Aislar no significa esconder
Un equipo necesita ejecutar software defectuoso, incompatible o potencialmente hostil sin convertir cada prueba en una amenaza para el resto del sistema. La respuesta habitual es «ponerlo en un contenedor» o «ejecutarlo en una máquina virtual». Ambas expresiones nombran mecanismos reales, pero no describen por sí solas una frontera de seguridad. Un contenedor puede ocultar procesos y limitar CPU; una máquina virtual puede presentar hardware virtual y un kernel separado. Ninguna frase explica qué ocurre con un socket montado, un dispositivo, una credencial del operador, el kernel compartido o un canal de administración.
Este capítulo usa aislamiento para referirse a una propiedad acotada: una entidad que cruza una frontera no puede observar, modificar o consumir determinados recursos de otra entidad, salvo por interfaces explícitamente autorizadas. La propiedad necesita un recurso, una operación, una autoridad, una configuración y un modelo de fallo. «El contenedor está aislado» no es todavía un claim técnico. «En el host H, el proceso P no puede leer el archivo X a través de la interfaz Y, bajo la configuración Z y durante la ventana W» sí permite buscar evidencia y contraejemplos.
La virtualización completa y los contenedores resuelven necesidades distintas. La primera emula o presenta hardware virtual para ejecutar un sistema operativo invitado (guest) sobre un anfitrión (host) mediante un monitor de máquina virtual o hypervisor. El segundo empaqueta un proceso y sus dependencias y usa el kernel del host para aplicar límites y vistas parciales. Hay runtimes que combinan un contenedor con una máquina virtual, y hay sistemas que llaman «contenedor» a varias implementaciones. Por eso conviene razonar por mecanismos y fronteras, no por etiquetas de producto.
Dos mecanismos, dos lugares donde se decide
En una máquina virtual, el invitado ejecuta un kernel propio. El hypervisor controla la ejecución del procesador virtual, la traducción o asignación de memoria, los dispositivos virtuales y ciertas operaciones sobre el host. El invitado ve una plataforma definida por el hypervisor, no el hardware físico completo. La frontera principal pasa entre el guest y el monitor; sus propiedades dependen de la configuración, del dispositivo virtual, del código del hypervisor, del host y de los canales que el operador haya habilitado. NIST SP 800-125 describe precisamente la virtualización completa como uno o varios sistemas operativos sobre hardware virtual y advierte que la capa adicional aumenta la carga de gestión de seguridad.
En un contenedor Linux ordinario no hay un kernel invitado que intercepte cada llamada. Un runtime crea un proceso y configura recursos del kernel: namespaces para ofrecer vistas separadas, cgroups para organizar y limitar consumo, capacidades para recortar privilegios, una raíz de filesystem y, cuando se configura, controles como seccomp, AppArmor o SELinux. El proceso sigue utilizando el kernel del host. El estándar OCI Runtime Specification define una configuración y un ciclo de vida interoperables, pero el estándar no convierte una configuración válida en garantía de aislamiento frente a todo fallo del kernel, del runtime o del despliegue.
La diferencia se puede expresar como una pregunta de autoridad. En la VM, ¿qué puede hacer el guest mediante el hardware virtual y qué valida el hypervisor? En el contenedor, ¿qué puede hacer el proceso mediante la interfaz del kernel y qué controles conservan autoridad en el host? Si un análisis responde sólo «VM más fuerte» o «contenedor más ligero», ha sustituido el mecanismo por una clasificación comercial.
La máquina virtual como frontera de hardware virtual
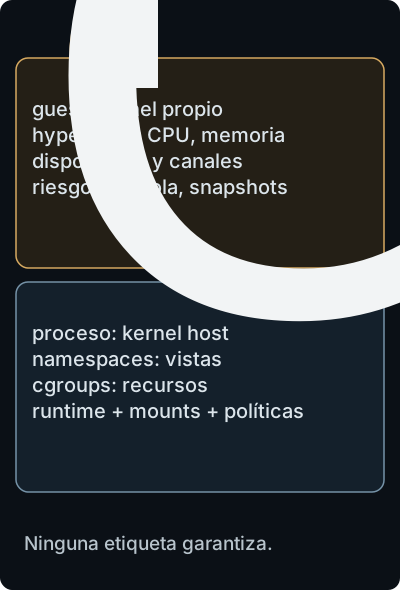
La frontera depende de interfaces y modelo de amenazas.
El flujo de creación de una VM comienza con una configuración de CPU, memoria, almacenamiento, red y dispositivos. El hypervisor asigna o multiplexa recursos físicos y expone un conjunto de dispositivos al guest. El kernel invitado aplica después sus propias reglas: usuarios, permisos, procesos, memoria y servicios. Un fallo dentro del guest puede afectar sus datos y procesos sin ser automáticamente una modificación del host, pero el alcance final depende de qué dispositivos y canales se compartan.
Hay al menos cuatro superficies que deben incluirse en un claim de VM:
- la interfaz de virtualización del procesador y la memoria;
- los dispositivos virtuales, emulación y drivers del guest;
- los canales de integración, como carpetas compartidas, portapapeles, agentes o consola;
- la administración del host, imágenes, snapshots, almacenamiento y red.
El snapshot ilustra un límite frecuente. Capturar el estado de una VM puede ayudar a recuperar el laboratorio, pero el archivo de snapshot se convierte en un activo que contiene memoria, disco, credenciales o claves del guest. Una política que prohíbe el acceso del guest al host no impide necesariamente que un operador con acceso al almacenamiento copie ese estado. El aislamiento de ejecución y la confidencialidad del artefacto de recuperación son claims diferentes.
La memoria virtual del guest tampoco significa que la información desaparezca al detenerlo. Páginas, discos, logs y caches pueden quedar en respaldos o en dispositivos administrados por el host. Por eso la evidencia de un claim de «el guest no puede leer memoria del host durante la ejecución» no autoriza afirmar «los datos del guest no pueden llegar al host». La segunda afirmación requiere analizar el plano de administración, la persistencia y la retención.
Qué compone un contenedor Linux
Namespaces: una vista, no una pared universal
Un namespace envuelve un recurso global de manera que los procesos miembros ven una instancia aparentemente propia. namespaces(7) documenta namespaces de mount, PID, red, IPC, UTS, user, cgroup y time, además de las APIs clone, unshare y setns. El efecto es específico al recurso. Un PID namespace cambia qué procesos se enumeran y cómo se asignan identificadores; no impide por sí solo toda interacción con el kernel ni borra un descriptor que se haya pasado por otra vía.
El mount namespace ofrece una tabla de montajes diferenciada. El runtime puede preparar una raíz de filesystem y montar /proc, /dev, /sys o volúmenes. La raíz visible no determina todos los objetos alcanzables: un bind mount, un descriptor heredado, un socket de Unix o una ruta expuesta por el host pueden introducir otra autoridad. Además, compartir un directorio no es una operación neutra: hace que el contenido y los permisos de ese activo formen parte del argumento de aislamiento.
El PID namespace limita la visibilidad de procesos y asigna un primer proceso con responsabilidades especiales dentro de su vista. El proceso puede verse como PID 1 en el contenedor y tener otro PID en el host. Esta dualidad es útil para supervisión y diagnóstico, pero no prueba que el host no pueda observarlo o administrarlo. Un operador que usa el runtime puede listar, señalar o terminar el proceso desde una frontera distinta.
El network namespace ofrece interfaces, rutas, tablas y puertos propios. La conexión entre namespaces suele construirse mediante pares de interfaces, bridges, NAT o redes del runtime. Ver una dirección privada dentro del contenedor no demuestra que no exista alcance hacia el host, hacia otros contenedores o hacia servicios de control. Ese alcance depende de rutas, reglas de filtrado, sockets escuchando y credenciales, no del nombre «red aislada».
El user namespace separa identificadores de usuario y grupo y puede mapear un UID que aparece como cero dentro a un UID no privilegiado fuera. user_namespaces(7) subraya que las capacidades son relativas al namespace: ser root dentro no equivale automáticamente a ser root en el namespace inicial. La configuración de mappings, ownership de montajes y operaciones permitidas debe comprobarse; un UID visible no resume toda la autoridad efectiva.
Los namespaces IPC, UTS, cgroup y time cambian respectivamente ciertos canales de comunicación, hostname, vista de la jerarquía de cgroups y relojes. Cada uno responde a una pregunta concreta. Activar un namespace no cubre los demás, y omitirlo puede hacer que el proceso herede la instancia del runtime. El OCI Runtime Specification establece que un tipo de namespace no incluido se hereda; por tanto, la ausencia de una entrada es una decisión con consecuencias, no un detalle cosmético.
Cgroups: regular consumo y observar estado
Los control groups (cgroups) organizan procesos jerárquicamente y permiten limitar y monitorizar recursos como CPU, memoria, I/O y número de procesos. La documentación de cgroup v2 del kernel separa el núcleo que organiza procesos de los controladores que implementan cada límite. Un cgroup puede impedir que una carga consuma más de un presupuesto, pero no impide por sí mismo que el proceso lea un archivo montado ni que invoque una syscall permitida.
El límite de memoria ofrece un ejemplo de interpretación. Si una carga alcanza el límite y es terminada, hay evidencia de aplicación de una política de recurso durante una ventana. No se sigue que el host sea inmune a agotamiento: kernel, runtime, dispositivos y otras cargas tienen sus propias rutas de consumo. Tampoco se sigue que el proceso carezca de capacidad de leer un secreto. La contención de disponibilidad y el aislamiento de confidencialidad son propiedades distintas.
El cgroup namespace virtualiza la vista de la jerarquía en /proc y /proc/mountinfo; no sustituye a los controladores que aplican límites. Un análisis que sólo muestra una ruta cgroup desde dentro está observando una representación, no demostrando el límite efectivo. Hay que contrastar configuración del host, procesos miembros, eventos de presión y comportamiento controlado.
Capacidades, nonewprivs y controles del kernel
Linux descompone parte de la autoridad tradicional de root en capabilities. Un runtime puede retener o retirar capacidades en los conjuntos effective, permitted, inheritable, ambient y bounding descritos por el OCI Runtime Specification. Retirar CAP_SYS_ADMIN, por ejemplo, reduce una clase de operaciones, pero no convierte el proceso en incapaz de toda interacción sensible. El conjunto exacto, la identidad efectiva, los dispositivos y las reglas LSM deben analizarse juntos.
no_new_privs evita que el proceso y sus descendientes obtengan privilegios adicionales mediante ciertos cambios de ejecución. Seccomp puede filtrar llamadas al sistema según una política, mientras AppArmor o SELinux pueden aplicar una política de control de acceso. Son capas con objetivos diferentes: una llamada rechazada por seccomp no demuestra que el objeto habría sido inaccesible por otra interfaz; una regla LSM sólo tiene el alcance que su política y contexto expresan. Declarar «usa seccomp» sin registrar la política y su carga efectiva no es evidencia suficiente.
La frontera real: composición y cruces
Una frontera de aislamiento es una composición de decisiones. Para reconstruirla, conviene dibujar host, runtime, proceso, filesystem, red, dispositivo, secreto, operador y servicio externo, y anotar por cada flecha qué autoridad transporta. Una flecha puede ser una syscall, un descriptor, un montaje, un socket, una ruta, una imagen, una consola o una API de administración. El objetivo no es producir un diagrama ornamental, sino encontrar cruces que el claim debe cubrir.
Considérese un laboratorio que ejecuta un parser no confiable. El proceso corre en un contenedor sin red, con filesystem raíz de sólo lectura y límite de memoria. Sin embargo, el operador monta el directorio de trabajo del host, expone el socket del runtime y conserva una capability innecesaria. El claim «el parser no puede alterar el host» falla por varias rutas potenciales aunque cada ajuste aislado parezca razonable. No hace falta afirmar que hubo una intrusión: basta reconocer que la frontera permite concluir menos de lo que la frase promete.
El mismo laboratorio en una VM puede reducir la dependencia del kernel del host para el parser, pero aumenta el número de componentes que se deben mantener: imagen del guest, kernel invitado, drivers, hypervisor, red virtual y canal de gestión. Si se comparte una carpeta o un agente de integración, la frontera vuelve a incorporar interfaces. Cambiar de contenedor a VM no elimina la necesidad de un modelo de amenazas; desplaza el punto de mediación y cambia el coste de mantenimiento.
La cadena de supply chain agrega otra dimensión. Una imagen de contenedor o disco de VM puede contener binarios, configuración y secretos. Verificar un digest o una firma aporta evidencia de correspondencia con un artefacto concreto, pero no prueba que el artefacto sea apropiado, que no tenga una autoridad excesiva ni que su ejecución preserve el claim. La procedencia de la imagen, la configuración en runtime y el estado del host responden preguntas diferentes.
Comparar sin convertir la tabla en una garantía
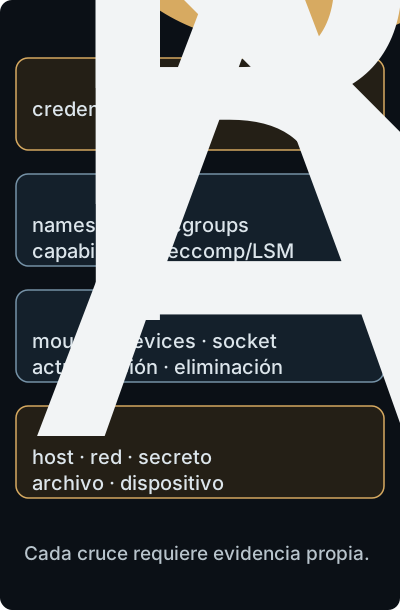
Una interfaz compartida puede ampliar el alcance.
Desliza horizontalmente para consultar todas las columnas.
La tabla ayuda a elegir una herramienta, no a asignar una severidad universal. Una VM mal administrada puede exponer snapshots o consolas; un contenedor bien configurado puede ser suficiente para una separación operativa concreta. El uso profesional requiere vincular la elección con activo, adversario, coste de fallo, actualización, recuperación y evidencia disponible.
Qué no significa «container escape»
Container escape se usa para describir una transición no autorizada desde el contexto del contenedor hacia recursos o autoridad del host o de otro contexto. No toda lectura visible desde el host es un escape: el host y el runtime deben poder administrar sus procesos. Tampoco toda capacidad dentro del contenedor es un escape: puede estar explícitamente concedida.
Para adjudicar una hipótesis de escape hay que separar observación, mecanismo e impacto. Una observación puede ser que un proceso obtiene un descriptor, ve un dispositivo o modifica un recurso. La inferencia pregunta qué frontera se cruzó y mediante qué autoridad. El impacto posible pregunta qué activo queda alcanzable. La conclusión necesita versión del kernel y runtime, configuración, precondiciones, control positivo y control negativo. Un error de configuración del operador y un fallo del kernel pueden requerir remediaciones distintas, aunque la consecuencia parezca similar.
La etiqueta «root dentro» tampoco resuelve la adjudicación. Si existe user namespace, el UID puede estar mapeado; si se comparten dispositivos o sockets, una identidad no privilegiada puede tener una autoridad importante; si se retiran capacidades pero se deja un mount escribible, la ruta relevante puede ser el filesystem. El diagnóstico debe observar credenciales, namespaces, capabilities, mounts, políticas, descriptores, red y relación con el proceso en el host.
Diseñar un claim y su evidencia
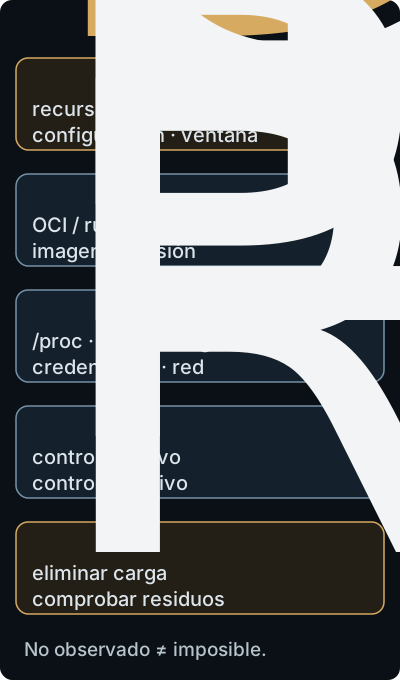
La conclusión termina donde termina la evidencia.
Un claim de aislamiento útil fija una versión y una operación. Por ejemplo: «Para la imagen I, runtime R, kernel K y configuración C, el parser P, ejecutado sin red y con el directorio de salida explícito, no puede leer ni modificar el archivo de control H del host durante una ejecución de prueba, salvo por la interfaz de salida O». La frase exige comprobar más que el proceso «parezca» confinado.
La evidencia puede organizarse en capas:
- Configuración declarada: imagen, runtime, namespaces, mappings, cgroups, capabilities, seccomp/LSM, mounts, devices y red.
- Estado materializado:
/procy/sysrelevantes, árbol de procesos, mappings, descriptores, rutas, pertenencia a cgroups y configuración efectiva del host. - Prueba controlada: lectura y escritura de objetos sintéticos autorizados, intentos negativos contra objetos fuera de alcance, límites de recursos y rutas de red explícitamente permitidas.
- Recuperación: detener y eliminar la carga, comprobar que no quedan procesos, mounts, interfaces, archivos temporales o credenciales inesperadas, y verificar que el host conserva su estado esperado.
Los controles positivos muestran que el laboratorio puede realizar la operación que necesita; los negativos prueban que una operación fuera de alcance es rechazada o no produce efecto. Un resultado negativo debe conservar la versión, configuración, observabilidad y ventana. «No se observó acceso» no equivale a «ninguna ruta existe», sobre todo si la prueba no cubrió interfaces de administración, dispositivos o cambios de configuración.
Errores frecuentes de diseño y diagnóstico
Confundir imagen con aislamiento. La imagen describe un filesystem y una aplicación; la frontera aparece al ejecutar con un runtime, configuración, mounts, identidad y políticas concretas. Cambiar la imagen no corrige un socket de administración expuesto.
Confundir rootfs con filesystem del host. Una raíz de contenedor es una vista montada. Un bind mount puede introducir una parte del host con sus propios permisos y semántica; su presencia debe ser explícita en el claim.
Usar cgroups como control de acceso. CPU y memoria limitadas ayudan a disponibilidad y contención de recursos, pero no reemplazan namespaces, permisos, capacidades o políticas de acceso.
Confiar en el nombre rootless. Rootless describe cómo se inicia o administra una carga, no una propiedad completa. Hay que comprobar mappings, acceso a dispositivos, helper, red, filesystem, runtime y privilegios efectivos.
Tratar el namespace como ocultación total. La vista cambia para los miembros, pero el host puede observar y administrar. Un canal compartido puede saltarse la vista que se pretendía aislar.
Medir sólo el arranque. Un contenedor que inicia con la configuración correcta puede adquirir un mount, un descriptor o una ruta adicional durante su ciclo de vida. La evidencia debe cubrir creación, ejecución, actualización y eliminación.
Inferir seguridad del aislamiento nominal. La frontera reduce una clase de interacciones; no elimina bugs de la aplicación, datos mal clasificados, secretos en la imagen, ataques contra servicios permitidos ni errores de operador.
Uso profesional: elegir, revisar y recuperar
En un laboratorio de análisis, una VM puede ser razonable cuando se necesita un kernel invitado, una red compleja o mayor separación de la carga, y se puede proteger su consola, disco y snapshots. Un contenedor puede ser adecuado para reproducir una aplicación con límites de CPU, memoria, red y filesystem, cuando el riesgo de compartir kernel está dentro del claim y el host está endurecido. Un contenedor dentro de una VM puede combinar propiedades, pero agrega otra frontera y otra cadena de actualización.
La decisión profesional sigue un orden: identificar activos y consecuencias; describir al adversario y los fallos accidentales; elegir la frontera que media las operaciones relevantes; minimizar interfaces y autoridad; fijar una configuración reproducible; probar controles positivos y negativos; registrar la evidencia; y diseñar eliminación y recuperación. La conveniencia operativa no debe convertirse en una afirmación de seguridad universal.
Una revisión también debe preguntar quién administra cada capa. El equipo que construye una imagen no necesariamente controla el kernel; el operador del host puede leer snapshots; el runtime puede añadir mounts por defecto; la red puede exponer un servicio de metadata; y la plataforma puede cambiar su configuración al actualizar. Cada responsabilidad es una premisa del claim, no un detalle administrativo separado de la seguridad.
Síntesis
Una VM y un contenedor son formas de componer una frontera, no sinónimos de una frontera suficiente. La VM separa un guest mediante un hypervisor y hardware virtual; el contenedor restringe un proceso mediante el kernel compartido, namespaces, cgroups, capabilities, root filesystem y políticas adicionales. En ambos casos, montajes, dispositivos, redes, credenciales, administración, imágenes y recuperación pueden ampliar o debilitar el alcance.
El modelo correcto no pregunta qué tecnología es «más segura» en abstracto. Pregunta qué recurso debe quedar fuera, qué operación lo alcanza, qué autoridad la media, qué precondiciones existen y qué evidencia permite sostener el claim. Un namespace aporta una vista; un cgroup limita recursos; una capability recorta autoridad; un hypervisor media hardware virtual. Ninguna de esas piezas hereda automáticamente una propiedad al sistema completo.
Al documentar un laboratorio o un servicio, el resultado profesional es un claim acotado, una frontera dibujada, una configuración versionada, controles positivos y negativos, y un procedimiento de recuperación. Esta disciplina evita tanto la confianza excesiva en «aislado» como el rechazo indiscriminado de una herramienta útil. El aislamiento sirve cuando se sabe qué separa, qué comparte y qué evidencia autoriza afirmar.
Fuentes principales
- NIST. SP 800-125: Guide to Security for Full Virtualization Technologies, 2011.
- NIST. SP 800-190: Application Container Security Guide, 2017.
- Open Container Initiative. Runtime Specification, configuración, namespaces, capabilities y ciclo de vida.
- Linux man-pages.
namespaces(7),user_namespaces(7)ycgroups(7). - Linux kernel documentation. Control Group v2.