Un programa no opera sobre «datos» en abstracto: opera sobre representaciones finitas, estados y reglas que asignan significado a esas representaciones. La misma secuencia de bits puede ser un entero, parte de un carácter, una instrucción o un valor inválido según el tipo, el contexto y la operación que la consume. Confundir el significado con su representación produce diagnósticos demasiado fuertes: un número visible no prueba cómo se almacenó; una dirección no es el objeto; y que un compilador acepte una expresión no significa que el resultado satisfaga el contrato del sistema.
Este capítulo continúa el modelo de programas como transformaciones de estado del capítulo 49. No enseña parsing o serialización completos (52), ni el control de flujo y excepciones (51). Se concentra en la frontera anterior: qué puede expresar una representación, qué invariantes aporta un tipo, cómo se relacionan objetos y memoria, y qué ocurre cuando una operación sale del dominio representable.
Una representación no es su significado
Una representación es una codificación observable: bytes, bits, una etiqueta, una dirección o una estructura en memoria. El significado es la interpretación que un contrato atribuye a esa codificación en un contexto. «42» como texto, el entero sin signo 42 y cuatro bytes en orden little-endian pueden relacionarse, pero no son el mismo objeto. La conversión entre ellos debe declarar codificación, rango y pérdida posible.
Considérese 00 00 00 2A. Como entero de 32 bits big-endian representa 42; leído little-endian representa 704643072. Como cuatro caracteres contiene bytes de control y * sólo en una posición concreta. Ninguna lectura es «la verdadera» sin un contrato. Un volcado tampoco prueba que esos bytes sean datos activos: pueden ser padding, memoria no inicializada o una representación que ya no tiene un propietario válido.
El contrato de una interfaz debe responder al menos: qué valores son válidos, qué unidad y codificación se usa, cuál es el orden de bytes, quién posee el almacenamiento, durante cuánto tiempo es válido y qué salida corresponde a un valor fuera de dominio. La ausencia de una respuesta no autoriza a inferir una garantía.
Vista adaptada. Toca el diagrama para ampliarlo.
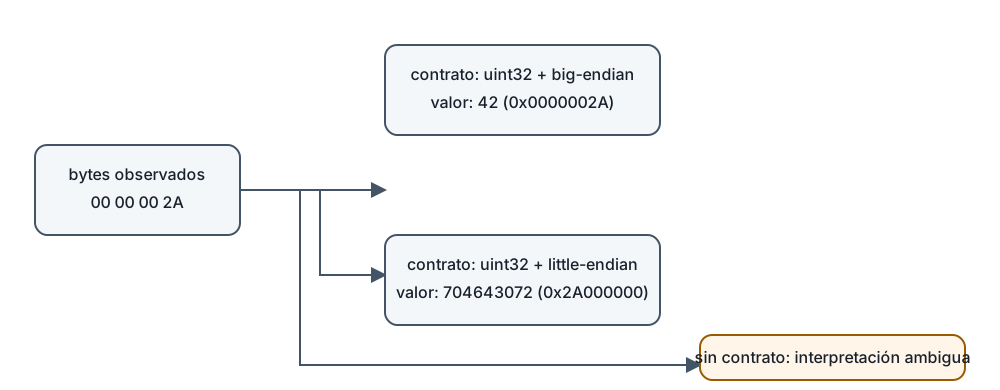
Tipos: información, comprobación y límite
Un tipo clasifica valores y operaciones permitidas. Un tipo estático se comprueba principalmente antes de ejecutar; uno dinámico se comprueba durante la ejecución cuando el valor participa en una operación; un sistema mixto puede hacer ambas cosas. Esta distinción no es una dicotomía de seguridad: los lenguajes estáticos pueden tener conversiones peligrosas, estados inválidos mediante unsafe o errores lógicos; los dinámicos pueden usar validación, contratos y pruebas que restringen entradas. «Dinámico» tampoco significa sin estructura.
El tipo ofrece información, no necesariamente una prueba completa de significado. int puede excluir una cadena, pero no decir que el número sea un identificador de tenant existente. Un tipo de capacidad puede aproximar esa propiedad, mientras que una autorización sigue siendo una decisión contextual. Separar tipo, validación semántica y autorización evita convertir una comprobación local en una garantía del sistema.
En una conversión explícita se debe preguntar qué ocurre con los valores fuera de rango. Convertir un entero grande a uno pequeño puede truncar, saturar, rechazar o producir un resultado definido por el lenguaje. Convertir bytes a texto puede fallar por codificación inválida o sustituir unidades. La política correcta depende del contrato; el silencio es una deuda de interpretación.
De bits a objetos: tamaño, alineación y orden
El tamaño es el número de bits o bytes reservados para una representación; el rango es el conjunto de valores que el contrato permite. Un entero de n bits sin signo puede representar, en el modelo habitual, de 0 a 2ⁿ−1; uno con signo no tiene una única representación universal entre lenguajes y estándares. ISO C fija propiedades y conversiones, pero deja tamaños concretos dependientes de la implementación. No se debe asumir que int mide 32 bits sólo porque una plataforma común lo haga.
La alineación es la restricción sobre direcciones donde un tipo puede ubicarse eficientemente o legalmente. Puede introducir padding entre miembros de una estructura. Por eso el tamaño de una estructura no es necesariamente la suma de sus campos. Copiar una estructura como bytes puede transportar padding no inicializado y romper la portabilidad; comparar bytes tampoco equivale siempre a comparar valores.
El endianness define cómo se ordenan bytes de un valor multibyte en memoria o en un formato. Es una propiedad de representación, no de la «importancia» del byte. Los formatos de red pueden fijar un orden independientemente de la CPU. Una conversión segura nombra explícitamente el orden y el ancho; no deriva el significado de una inspección parcial.
Vista adaptada. Toca el diagrama para ampliarlo.
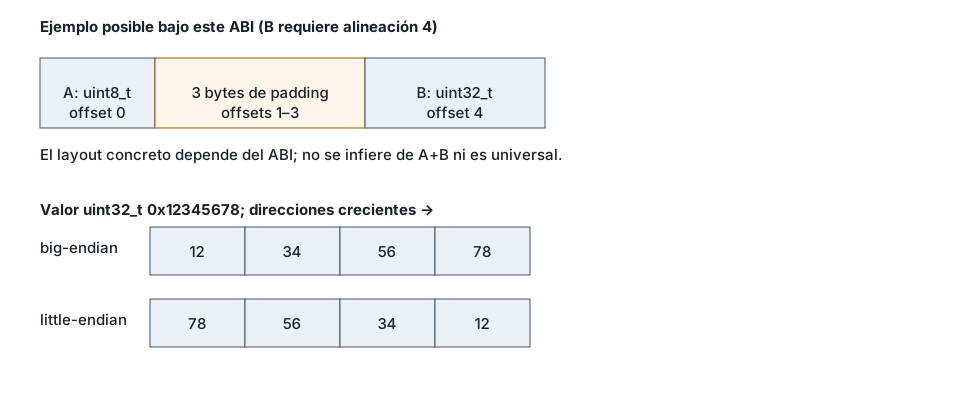
Enteros, overflow y precisión
El overflow ocurre cuando una operación produce un resultado fuera del dominio que puede representar el tipo u operación. No tiene una consecuencia universal. En algunos tipos sin signo de C, la aritmética se define módulo 2ⁿ; en tipos con signo, ciertas operaciones fuera de rango tienen comportamiento indefinido en C. En otros lenguajes se lanza una excepción, se comprueba en compilación, se envuelve o se satura. El diagnóstico debe citar el lenguaje, versión, tipo y operación concreta.
El riesgo práctico aparece cuando el resultado se usa como tamaño, índice, duración, contador o límite de autorización. Un cálculo que envuelve puede convertirse en una reserva menor que la prevista; una comparación con unidades distintas puede aceptar una duración equivocada. La mitigación no es «usar un entero grande» sin más: validar antes de convertir, comprobar operaciones críticas, fijar unidades y decidir una política para el límite. Las comprobaciones deben cubrir mínimo, máximo, transición y valor fuera de dominio.
Los números de punto flotante añaden representación aproximada, redondeo, infinitos y NaN. IEEE 754 define formatos y operaciones, pero no convierte igualdad numérica en igualdad de intención de negocio. Un precio, una medición y un contador requieren contratos diferentes. Comparar por tolerancia, usar enteros escalados o decimal exacto son decisiones de dominio, no reglas universales.
Memoria: ubicación, objeto, referencia y lifetime
La memoria es un espacio de almacenamiento direccionable; un objeto es una región cuyo tipo, estado y ciclo de vida permiten interpretar su contenido. Una referencia es un medio para localizar o acceder a un objeto bajo reglas del lenguaje; no es sinónimo de la dirección física. Un lifetime comienza cuando el objeto puede ser usado según su contrato y termina cuando deja de existir o de ser accesible de esa forma.
Stack, heap, registros y memoria mapeada son modelos de implementación con propiedades distintas, no cuatro categorías universales de seguridad. Un objeto puede moverse en un recolector, copiarse o permanecer en una región gestionada; una dirección observada puede quedar obsoleta. El propietario y la duración son más importantes que el nombre del segmento.
Un alias es otro camino para referirse al mismo estado. El aliasing puede ser útil, pero exige reglas sobre mutación y concurrencia. Un dangling reference apunta a un objeto cuyo lifetime terminó; una lectura fuera de bounds usa una posición que no pertenece al objeto previsto. Un use-after-free es un caso de acceso posterior a la liberación. Son clases conceptuales de error de memoria, no instrucciones de explotación. Pueden causar lecturas erróneas, corrupción, fallos o filtración de datos, según el entorno y las mitigaciones.
La memoria segura no significa que toda política sea correcta. Un lenguaje puede impedir use-after-free y aún permitir que un servicio envíe datos al tenant equivocado. Inversamente, un lenguaje con punteros explícitos puede expresar un programa seguro si sus invariantes de propiedad, límites y lifetimes están satisfechos. El control debe ubicarse donde se decide: tipo/compilador para invariantes expresables, runtime para entradas dinámicas, y lógica de negocio para significado y autorización.
Vista adaptada. Toca el diagrama para ampliarlo.
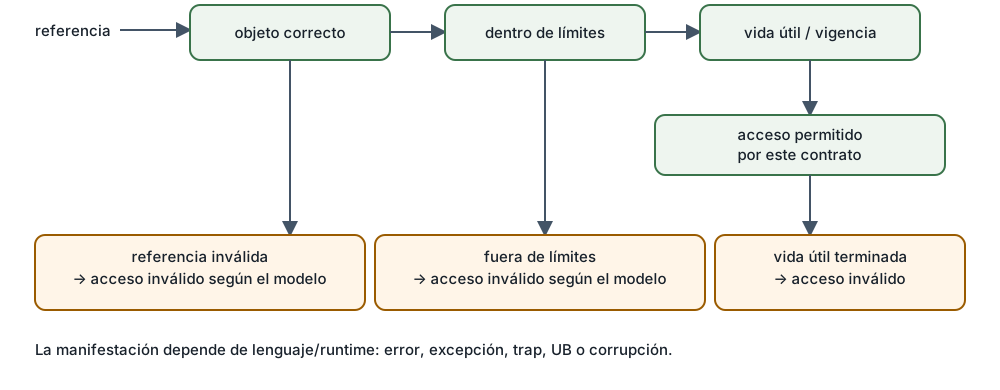
Leer errores como pérdidas de invariantes
Un error de representación interpreta bytes con el tipo, ancho, orden o codificación equivocados. Un error de rango acepta o genera un valor que el dominio no puede contener. Un error de lifetime usa almacenamiento fuera de su vigencia. Un error de contrato conserva una representación válida pero la usa para un significado que no se autorizó. Las categorías pueden componerse: un tamaño calculado con overflow puede conducir a un límite de memoria incorrecto y después a un acceso fuera de bounds.
El análisis profesional separa cuatro preguntas:
- ¿Qué observación es segura? Por ejemplo, se vio una secuencia de bytes o se produjo un resultado.
- ¿Qué interpretación permite el contrato? Hace falta tipo, ancho, unidad, owner y estado.
- ¿Qué operación se intentó y qué resultados están definidos? Aquí importan la especificación del lenguaje y el runtime.
- ¿Qué impacto está probado y qué queda potencial? Un fallo reproducible no prueba por sí solo una lectura de secretos o una escalada.
El control negativo es esencial. Si una conversión debe rechazar MAX+1, probar sólo valores normales no demuestra la frontera. Si una referencia debe dejar de ser válida tras cerrar un recurso, probar una lectura previa no demuestra el cierre. Si un parser posterior recibe bytes, este capítulo sólo puede afirmar que su límite de representación se conserva hasta ese consumidor; la validación sintáctica pertenece al capítulo 52.
Caso: longitud de un registro y cuatro fronteras
Un servicio recibe un campo length de 64 bits, lo convierte a size_t, reserva memoria y copia un registro. El caso no se resuelve diciendo «el tipo es grande». Hay cuatro fronteras: la semántica de la entrada, la conversión al tipo local, el límite de memoria permitido y el lifetime del buffer durante la copia.
Si length excede el máximo local, la conversión debe rechazarlo antes de reservar. Si la suma header + length desborda, hay que comprobar la suma o imponer un máximo antes de calcularla. Si la reserva funciona pero la fuente contiene menos bytes, el contrato de lectura debe distinguir truncamiento de éxito. Si el buffer se libera mientras una operación asíncrona lo usa, el tamaño era correcto pero el lifetime no. Cada control tiene una evidencia distinta y una política de error distinta.
El mismo razonamiento cambia en un lenguaje con slices comprobados, en uno con garbage collector o en C con aritmética de punteros. Ninguno autoriza a presentar el resultado como universal. La pregunta estable es: ¿qué invariante garantiza este lenguaje o biblioteca, en qué frontera y con qué coste de fallo?
Modelo objeto–valor–representación
Conviene mantener tres niveles separados. Un valor pertenece al conjunto que un tipo admite; un objeto es almacenamiento con identidad, estado y lifetime; una representación es la disposición concreta de bits o bytes usada para codificar el valor en ese objeto o en una frontera. En un uint32_t, por ejemplo, el valor abstracto 42 puede residir en un objeto de cuatro bytes; el orden de esos bytes cambia la representación, no necesariamente el valor. Dos objetos con el mismo valor siguen siendo objetos distintos y pueden tener owners, permisos o lifetimes distintos.
Esta separación explica por qué copiar bytes no siempre copia un valor válido. Una estructura puede contener padding; un puntero puede tener una representación que sólo es válida dentro de un proceso; un NaN puede tener múltiples payloads sin equivalencia ordinaria; y una referencia puede conservar una dirección después de que el objeto termine. La pregunta «¿qué hay en esta dirección?» es incompleta: hay que indicar qué proceso, qué objeto, qué tipo, qué instante y qué contrato de acceso.
Tipos como conjuntos y operaciones
Pensar un tipo como un conjunto de valores y operaciones ayuda a localizar límites. Una conversión total asigna cada elemento del conjunto origen a uno del destino; una conversión parcial necesita rechazar o representar explícitamente algunos elementos. Una promoción puede ampliar el dominio, pero no siempre conserva significado: una duración en milisegundos promovida a un entero mayor sigue pudiendo desbordar al multiplicarse. Una conversión estrecha puede perder magnitud, signo, precisión o unidad.
Las conversiones implícitas son especialmente peligrosas en fronteras mixtas. En C, las conversiones aritméticas usuales pueden promover tipos pequeños y combinar signedness; el resultado depende de rangos y tipos concretos (N1570, §§6.3.1.1 y 6.3.1.8). En Rust, las conversiones numéricas no se insertan de forma general como una operación silenciosa: el programador elige cast o métodos comprobados, y el resultado sigue dependiendo del modo de compilación y método usado. En lenguajes dinámicos, la conversión puede ocurrir en runtime y producir null, excepción, truncamiento o coerción. Por eso «el lenguaje convierte» no es una explicación suficiente: hay que registrar fuente, destino, operación y política de pérdida.
Un contrato robusto distingue absent, null, cero y error cuando tienen semánticas diferentes. También distingue unidades: bytes, elementos, segundos y milisegundos pueden compartir representación entera y no ser intercambiables. Una etiqueta o wrapper de unidad reduce errores de mezcla, pero no prueba que la cifra corresponda al mundo real. La validación semántica —por ejemplo, que un identificador exista o que una duración sea admisible para una política— sigue estando fuera del tipo numérico.
Signed, unsigned y números aproximados
En un entero sin signo de ancho fijo, una suma puede envolver módulo 2ⁿ bajo el contrato del lenguaje. Ese wrap puede ser correcto para un contador cíclico y peligroso para una longitud. En C, la conversión de un valor con signo a unsigned se define módulo una potencia de dos, mientras que el overflow de signed no debe tratarse como wrap portable (N1570, §§6.3.1.3 y 6.5). En Java, los enteros tienen anchos definidos y las operaciones ordinarias pueden envolver; en Rust, el método (checked_add, saturating_add, wrapping_add) expresa la política y el modo debug puede detectar algunos casos. Son perfiles distintos, no excepciones a una regla universal.
Una revisión debe comprobar dónde se calcula el límite, no sólo dónde se usa. count * element_size puede desbordar antes de llegar a la API de reserva. La validación correcta compara antes de multiplicar (count <= max / element_size), impone un máximo operacional y maneja el rechazo. También debe considerar conversiones posteriores: validar un uint64 y luego almacenarlo en size_t no conserva la garantía si el destino es menor. La unidad y el límite deben viajar juntos hasta el consumidor.
La coma flotante representa números mediante signo, exponente y significando; muchos valores decimales no son exactos. IEEE 754-2019 define operaciones, redondeos, excepciones y valores especiales, pero no el criterio de igualdad de una aplicación. NaN no se compara igual que sí mismo bajo comparaciones ordinarias; +0 y -0 pueden comportarse igual en algunas comparaciones y distinto en operaciones o serialización. Un cálculo financiero puede requerir decimal o enteros escalados; una medición puede admitir tolerancia; un algoritmo numérico puede necesitar controlar pérdida de significancia. Elegir «double para todo» oculta la política.
Fronteras de ABI, red y archivo
Una frontera ABI (Application Binary Interface) fija convenciones de llamada, tamaños, alineación, registros y layout para componentes que deben interoperar. Un layout de lenguaje no se vuelve ABI estable sólo porque el compilador lo haya producido una vez. Si dos módulos discrepan sobre packing o signedness, pueden leer un valor distinto sin que cambie ningún byte visible en el trace. Las interfaces C suelen usar tipos de ancho explícito y documentación de ownership; aun así, la validez depende de que ambos lados compartan ABI y reglas de lifetime.
En una frontera de red, el mensaje tiene una codificación, framing, orden, límites y versión. El receptor no debe convertir directamente un campo externo en un tamaño interno sin comprobar rango, longitud disponible y política de recursos. El hecho de que el transporte entregue bytes completos no demuestra que el valor sea semánticamente válido. En una frontera de archivo, la persistencia añade duración y compatibilidad: un archivo puede sobrevivir al proceso que lo creó, pero no por eso conserva una interpretación si cambian versión, codificación o esquema.
Estas fronteras no se resuelven dibujando «bytes entran, objeto sale». Hay una transición verificable: bytes recibidos → framing y longitud → decodificación bajo versión → valor candidato → validación semántica → objeto local con owner y lifetime. El parsing detallado y la canonicalización pertenecen a capítulos posteriores; aquí importa que cada transición declare qué propiedad gana y cuál todavía no está demostrada.
Errores espaciales y temporales
Un error espacial usa una posición fuera del objeto: índice negativo representado como unsigned, longitud que excede el buffer o aritmética de punteros que cruza el límite. Un error temporal usa un objeto antes de inicializarlo, después de liberar, después de cerrar un recurso o desde una tarea que perdió la propiedad. Ambos pueden producir la misma señal —un crash— y requieren evidencia distinta. El crash prueba un fallo observable; no adjudica por sí solo si la causa fue bounds, lifetime, race o una condición externa.
Ownership conceptual significa que existe una autoridad responsable de crear, transferir y liberar o dejar expirar el objeto. Borrowing o referencia temporal significa que otro componente puede acceder dentro de un intervalo, sin adquirir necesariamente propiedad. En un recolector, la liberación física puede ser automática, pero siguen existiendo estados inválidos: un objeto puede quedar lógicamente cerrado, una vista puede apuntar a un contenedor que cambió y una tarea puede usar una sesión que el servicio invalidó. La gestión automática reduce clases de errores; no elimina contratos.
Caso profesional: registro binario entre procesos
Dos procesos intercambian un registro de 24 bytes: version, flags, count y un offset a una tabla. El productor compila para una CPU little-endian y añade padding para alinear count; el consumidor espera big-endian y calcula table_start = header + count * entry_size. El primer defecto no es «la CPU equivocada»: el contrato no fijó endianness, packing ni si el offset es relativo al mensaje o una dirección local.
El diagnóstico comienza congelando el artefacto: bytes exactos, tamaño recibido, versión declarada y límites de captura. Después se prueba una decodificación controlada en ambos órdenes y se compara con una especificación del formato. Se verifica que count sea admisible antes de multiplicar, que table_start no desborde y que la tabla completa esté dentro del mensaje. Sólo entonces se construye un objeto local con lifetime propio; nunca se conserva un puntero a un buffer temporal sin transferir ownership.
Si el productor afirma «envío 24 bytes», eso describe una observación de su salida, no la validez del objeto del consumidor. Si el consumidor obtiene count=4, eso prueba su interpretación bajo una versión y endianness elegidos, no que el productor quisiera cuatro entradas. La evidencia mínima para adjudicar causa incluye contrato de formato, versión, ABI o packing, cálculo de límites y resultado de controles negativos con padding, orden incorrecto y count máximo. No hace falta convertir el caso en una explotación: basta mostrar qué invariante se perdió y en qué frontera.
Método de diagnóstico reproducible
- Congelar la observación sin interpretarla: bytes, tamaños, tipos declarados, instante, proceso y operación.
- Nombrar el objeto y su owner: qué región se lee, quién la creó, cuándo comienza y termina su lifetime.
- Reconstruir el dominio de cada tipo y cada conversión, incluyendo promociones implícitas, unidades y signedness.
- Comprobar límites antes de operaciones que puedan desbordar; probar mínimo, máximo, transición y rechazo.
- Separar fronteras: lenguaje, ABI, red, archivo, runtime y política de negocio. No transportar garantías entre ellas sin evidencia.
- Reproducir un control positivo y uno negativo. Un caso válido muestra capacidad; el negativo muestra que la frontera realmente se aplica.
- Reportar observación, interpretación, impacto observado, impacto potencial e incertidumbre como campos distintos.
Este método evita dos errores opuestos: llamar «corrupción» a cualquier valor inesperado y llamar «seguro» a cualquier programa que no falló en una ejecución. La investigación termina cuando la causa está ligada a una regla verificable y el alcance de la conclusión coincide con esa regla.
Transferencia: una fecha, una clave y una dirección
Una fecha codificada como texto, un identificador binario y una dirección de memoria parecen valores, pero requieren contratos diferentes. Para una fecha, el formato y la zona horaria afectan significado; para una clave, el ancho, secreto y comparación constante pueden importar; para una dirección, el proceso y lifetime delimitan validez. Copiar los bytes de los tres no preserva automáticamente sus propiedades.
Al revisar una interfaz, escribe primero una tabla de invariantes: tipo de entrada, unidad, rango aceptable, representación, propietario, lifetime, resultado fuera de rango y autoridad que decide. Después busca conversiones implícitas, tamaños derivados, aliasing y estados después de liberar o cerrar. Finalmente, enlaza cada afirmación con una observación o especificación. La ausencia de un error en una prueba no demuestra que el contrato cubra toda la frontera.
Síntesis
El modelo útil no es «tipado fuerte contra tipado débil» ni «stack seguro contra heap peligroso». Es una cadena: una representación finita se interpreta bajo un tipo y un contrato; el objeto ocupa almacenamiento con tamaño, alineación y orden concretos; las referencias sólo son válidas dentro de límites y lifetimes; las operaciones pueden salir del dominio por overflow, precisión o conversión; y el sistema decide si rechaza, transforma o propaga ese estado.
El capítulo 51 tomará los errores y estudiará cómo control de flujo, excepciones y fallos parciales propagan decisiones. El 52 añadirá parsing y validación estricta. Aquí queda la frontera conceptual: antes de preguntar qué hizo el programa, hay que establecer qué podía representar, qué objeto existía y qué significado estaba justificado.
Fuentes primarias
- ISO/IEC 9899:2011 (C11), draft público N1570, §§6.2.5, 6.5, 6.7.2.1 y 6.3.1.3: tipos, objetos, layout y conversiones. N1570.
- IEEE Std 754-2019, §§3–7: formatos, operaciones, excepciones y redondeo. IEEE Xplore.
- The Rust Reference, Types, Memory model y Undefined behavior: contratos de tipos, referencias y comportamiento no definido según Rust. doc.rust-lang.org/reference.
- SEI CERT C, INT rules: límites, conversiones y aritmética de enteros. wiki.sei.cmu.edu.
- IETF RFC 791, §3.1, y RFC 1700, orden de bytes de red: contexto de representación en protocolos, no regla del layout de memoria local. RFC 791, RFC 1700.