En nuestro sistema hipotético, Mara escribe https://fotos.example/album/7?orden=fecha#enero en la barra de direcciones y pulsa Intro. El dominio reservado .example identifica un ejemplo, no un servicio real que el lector deba visitar. Poco después, Mara ve una cuadrícula de fotografías. La explicación habitual cabe en una frase: «el navegador se conecta al servidor y descarga la página». Esa frase orienta, pero comprime tantas decisiones que deja un modelo falso. La URL no es la página; el servidor no tiene por qué ser una sola máquina; el documento inicial no contiene necesariamente todo lo visible; y una respuesta puede proceder de la red, de una caché o de una combinación de estados previos.
Este capítulo construye un mapa causal de esa navegación. Al terminar, el lector deberá poder reconstruir qué clase de transformación ocurre desde la referencia escrita hasta la representación visible, señalar dónde cambian los datos, las decisiones locales o la autoridad técnica atribuida y distinguir qué demuestra cada resultado. No aprenderemos todavía los algoritmos internos de DNS, TCP, QUIC, TLS, HTTP, caché, cookies, DOM, CSS o JavaScript. El objetivo es anterior: poder formular la pregunta correcta en la frontera correcta.
El recorrido que seguiremos no es una cinta transportadora universal. Usaremos como caso base una primera visita que necesita comunicarse por la red, pero iremos abriendo las bifurcaciones que un navegador real puede tomar. Una respuesta almacenada puede evitar una transferencia completa; una conexión puede existir ya; varias solicitudes pueden solaparse; el navegador puede empezar a procesar el documento mientras todavía recibe bytes; y el código de la página puede modificar lo que se ve después. La causalidad permanece, pero no exige que cada actividad termine antes de que comience la siguiente.
La cadena empieza con una referencia
La cadena que Mara escribe es una URL. Su primera función es identificar una referencia interpretable dentro de unas reglas; no contiene las fotografías ni demuestra que éstas existan. RFC 3986 presenta el papel identificador de las URI (RFC 3986, §1.1) y separa identificación e interacción: identificar un recurso no obliga a recuperarlo ni garantiza que sea accesible (RFC 3986, §1.2.2). En el contexto de un navegador, el análisis concreto de la cadena sigue el modelo del URL Standard, no una separación informal hecha a simple vista (WHATWG URL, §4.4).
Podemos leer el ejemplo por componentes:
httpses el esquema. Indica la semántica de acceso que el navegador debe aplicar si intenta obtener el recurso.fotos.examplees el host dentro de la autoridad de la URL. Es un nombre, no una dirección, una persona o una prueba de propiedad empresarial.- el puerto no aparece escrito; para este esquema existe un valor por defecto que el modelo de URL puede normalizar;
/album/7es la ruta;?orden=fechaes la consulta;#eneroes el fragmento.
La ruta y la consulta ayudan a identificar el recurso dentro del espacio gobernado por esa autoridad. El fragmento tiene otra frontera: se usa localmente para referirse a una parte o estado de la representación y se excluye del target URI enviado en la petición HTTP (RFC 9110, §7.1). Por eso no debemos dibujar toda la cadena, incluido #enero, viajando sin cambios hasta el servidor.
En este primer punto ya cambió algo. Mara aportó texto; el navegador produjo un registro URL o rechazó la entrada y tomó una decisión local de navegación. Interpretar la cadena es responsabilidad del agente de usuario y de sus reglas; aún no se ha atribuido autoridad HTTPS a ningún endpoint. Si la referencia es inválida o el esquema no está soportado, el recorrido puede terminar antes de emitir tráfico. Ver una URL bien formada tampoco prueba que el nombre se resuelva, que el recurso exista o que el contenido sea legítimo.
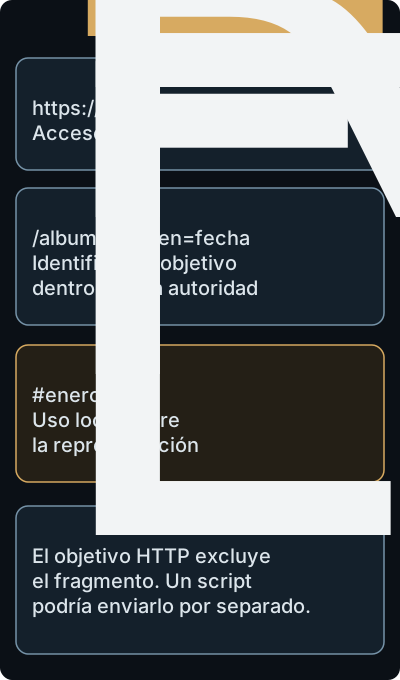
Esquema y host guían el acceso; ruta y consulta identifican el objetivo dentro de esa autoridad. El fragmento queda fuera del objetivo HTTP.
Del host a un extremo posible
El navegador necesita determinar cómo obtener una respuesta para esa URL. En el caso conductor asumiremos que no dispone todavía de una respuesta reutilizable ni de un canal adecuado. Entonces el host fotos.example participa en la localización de un extremo. Como vimos en el capítulo anterior, resolver un nombre puede aportar datos de dirección; no convierte el nombre en dirección ni autentica al servicio.
Conviene decir «puede resolver» y no «consulta DNS una vez». El navegador, el sistema operativo, un proxy u otro componente pueden tener información previa. También puede haber una caché de resolución. Desde la experiencia de Mara no se deduce qué consulta ocurrió ni qué actor la produjo. RFC 9110 reconoce que acceder al origen puede implicar establecer o reutilizar una conexión, y que el mecanismo depende del esquema y del contexto (RFC 9110, §7.3.3).
Supongamos que el sistema obtiene una dirección candidata. Lo que cambió fue el dato disponible para intentar contacto: de un host en una URL pasamos a información de localización utilizable por la red. No cambió la identidad humana de nadie ni apareció una autorización. La misma dirección puede servir a varios nombres y un mismo servicio puede usar varios endpoints. Una Content Delivery Network (CDN), un proxy o una infraestructura distribuida pueden hacer que el extremo alcanzado entregue una respuesta sin ser el lugar en el que se creó originalmente el contenido.
Si no aparece un endpoint utilizable, el navegador puede mostrar un error relacionado con la resolución. Esa observación delimita una frontera; no demuestra que «el sitio dejó de existir». La causa podría residir en la configuración local, el resolver, una caché, un proxy o los datos publicados. Un diagnóstico riguroso describe primero el resultado observable y sólo después contrasta hipótesis.
Comunicar no es todavía pedir una página
Con una dirección posible, el navegador necesita un medio de comunicación. El modelo general es un transporte nuevo o reutilizado. Una concreción común para una conexión nueva es TCP, un transporte fiable y orientado a conexión (RFC 9293, §§1 y 3). TCP explica cómo mantener una comunicación entre extremos; no explica qué recurso se solicita, qué significa un código HTTP ni quién está autorizado.
No debemos universalizar esa concreción. HTTP/3 funciona sobre QUIC, no sobre una secuencia independiente TCP seguida de TLS (RFC 9114, §3). Además, una navegación puede reutilizar un canal ya establecido. Por eso el mapa profesional conserva la separación «transporte — canal asegurado — HTTP», pero no promete que el navegador ejecute tres ceremonias nuevas y visibles en cada apertura.
En el caso base, una conexión TCP recién establecida sólo demuestra que dos extremos lograron mantener ese transporte en ese momento. Todavía no existe por ello una petición HTTP, una respuesta ni una decisión del servicio. Si el establecimiento falla, tampoco sabemos automáticamente si el endpoint estaba apagado, si una política descartó tráfico, si el camino se interrumpió o si nuestra dirección era inadecuada. La conexión es una condición de comunicación, no una explicación completa.
Qué añade HTTPS y qué deja fuera
El esquema https exige que la comunicación HTTP aceptada por el cliente esté asegurada. Transport Layer Security (TLS) busca confidencialidad, integridad y autenticación bajo sus supuestos (RFC 8446, §1). Durante el establecimiento, el servidor puede presentar material de certificado; recibirlo no basta: el cliente debe aplicar las comprobaciones correspondientes, y la propia especificación TLS deja parte del procedimiento detallado de validación fuera de su alcance (RFC 8446, §4.4.2.4).
Para HTTPS, la pregunta importante es si la identidad del servicio es una coincidencia aceptable para el origen de la URL. RFC 9110 exige esa comprobación y la vincula con los anclajes de confianza configurados en el cliente (RFC 9110, §4.3.4). Si resulta aceptable, el navegador puede atribuir al endpoint autoridad para responder por ese origen dentro de las reglas aplicables. La propiedad no procede de que aparezca un candado dibujado, sino del canal asegurado, la identidad de referencia y la validación.
Aquí cambia la autoridad atribuible. Antes había un endpoint alcanzable; ahora el cliente acepta un canal como autorizado para un origen HTTPS. Eso no autentica a Mara, no demuestra quién dirige la organización, no autoriza la lectura de un álbum y no certifica que las fotografías sean verdaderas. Tampoco protege automáticamente datos antes de entrar al canal o después de salir de él. TLS delimita una propiedad del canal, no una garantía total del sistema.
Una validación fallida debe permanecer en esta frontera. El mensaje de error no permite concluir por sí solo que el nombre era falso, que alguien atacó la conexión o que el servicio está caído. El reloj local, la configuración de confianza, el certificado presentado, la identidad esperada u otras condiciones pueden intervenir. Las causas concretas pertenecen a capítulos posteriores; aquí basta con no confundir el fallo con uno de transporte o de HTTP.
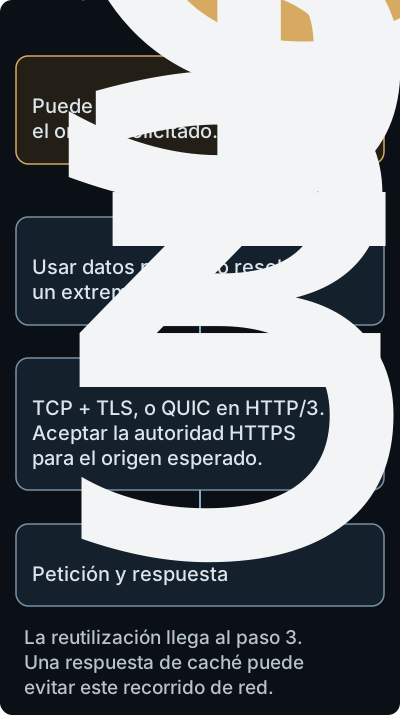
Si ya existe un canal adecuado para el origen, no se repite necesariamente su establecimiento. La caché puede evitar la red.
Una petición no trae «el sitio» entero
Con un canal aceptado, el navegador puede formular una petición HTTP. En nuestro caso, una petición GET solicita la transferencia de una representación del recurso identificado (RFC 9110, §9.3.1). El mensaje contiene datos de control, campos y, cuando corresponde, contenido. No es una frase humana como «dame la web», sino un mensaje con semántica definida.
El target incluye los componentes relevantes de la URL, sin el fragmento. Algunos campos expresan capacidades o contexto. Si existen cookies aplicables, el navegador puede incluir un campo Cookie. La petición puede atravesar intermediarios antes de llegar a un componente que actúe como servidor de origen. HTTP define cliente y servidor como roles en una interacción (RFC 9110, §3.3), distingue el rol de servidor de origen (RFC 9110, §3.6) y modela intermediarios (RFC 9110, §3.7); no son nombres de cajas físicas.
Esa precisión corrige la frase «el servidor devuelve el sitio». Un componente o programa desempeña el rol de servidor durante una interacción. Puede ejecutarse en una máquina, en varias, detrás de un gateway o mediante servicios distribuidos. La respuesta que llega puede haber atravesado proxies y cachés. La pantalla no revela automáticamente qué componente generó cada byte ni dónde se encontraba.
La respuesta HTTP incluye un estado, campos y quizá una representación. Para el GET del caso conductor, 200 OK significa que se transfirió una representación del recurso de destino; no garantiza que el cuerpo sea un documento HTML procesable, que sus dependencias carguen o que el navegador produzca la pantalla esperada (RFC 9110, §15.3.1). Una redirección puede aportar otra referencia y hacer que la navegación continúe hacia otra URL, incluso hacia otro origen. Una respuesta de error también es una respuesta HTTP: prueba que parte del recorrido funcionó, no que «no hubo conexión».
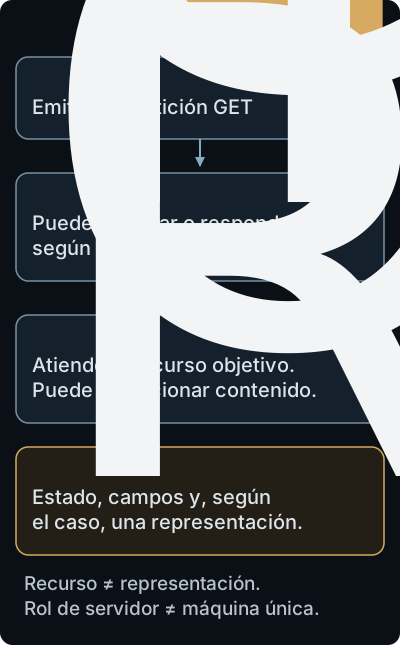
El intermediario es opcional y puede responder sin reenviar al origen. Recurso identificado y representación transferida no son lo mismo.
Origen, site y sitio web no son sinónimos
En la web, el origen de una URL HTTP(S) se modela a partir de esquema, host y puerto (WHATWG URL, §4.7). https://fotos.example y http://fotos.example no comparten el mismo origen; cambiar de puerto también puede cambiarlo. HTML trata los orígenes como unidades fundamentales de su modelo de seguridad y distingue actores que comparten origen de actores potencialmente hostiles (HTML Living Standard, §7.1.1). Este capítulo no desarrolla todavía la política de mismo origen ni sus excepciones.
Un sitio web, en el lenguaje editorial corriente, es una agrupación de páginas, productos o servicios percibidos por personas como una unidad. Puede abarcar varios orígenes. En cambio, site tiene también un significado técnico en las especificaciones web: HTML lo calcula como un origen opaco o una pareja de esquema y host derivada normalmente del dominio registrable, y lo diferencia de origen (HTML Living Standard, §7.1.1.1). Más adelante necesitaremos esa acepción para estudiar relaciones same site; aquí basta con no intercambiar sitio web, site y origen. Una organización puede controlar muchos de ellos, y una infraestructura compartida puede servir a organizaciones distintas.
Esta frontera importa cuando el documento principal referencia una imagen en media.example, una fuente en otro host o un script proporcionado por un tercero. Aunque todos contribuyan a una sola pantalla, no comparten necesariamente origen ni autoridad para el mismo espacio de recursos. El navegador evalúa cada obtención con su URL, contexto, políticas y estado. Dibujar una sola caja llamada «el sitio web» borraría precisamente el límite que necesitamos conservar.
Cookies: estado adjunto, no identidad automática
HTTP no necesita que una petición recuerde por sí sola todas las anteriores. Las cookies permiten que un agente de usuario almacene datos recibidos mediante Set-Cookie (RFC 6265, §4.1) y adjunte datos aplicables en solicitudes posteriores mediante Cookie, de acuerdo con reglas de alcance y procesamiento (RFC 6265, §§4.2, 5 y 5.4). Para el protocolo, esos valores son datos; la aplicación decide su significado. Aquí usamos RFC 6265 para explicar almacenamiento, dominio y ruta; no como descripción exhaustiva de todas las políticas actuales del navegador.
El servicio de fotos podría usar una cookie para relacionar la petición con una sesión, guardar una preferencia o sostener otro estado. No debemos llamar a toda cookie «la sesión» ni «la identidad». Un valor puede funcionar como referencia a estado de sesión, pero la identidad reconocida y la autorización resultan de un contrato mayor. También puede haber cookies sin relación con autenticación.
El alcance de cookies tampoco coincide exactamente con el origen. Sus reglas de dominio y ruta pueden hacer aplicable un dato en límites distintos. En este nivel sólo necesitamos conservar dos ideas: el navegador puede adjuntar estado local a una petición, y el receptor puede interpretarlo. Que una cookie viaje no prueba quién está frente a la pantalla ni que la acción esté permitida.
Aquí existe otro cambio de datos y ámbitos de decisión. Estado que estaba almacenado en el navegador puede cruzar hacia un servicio bajo reglas. El navegador decide si lo adjunta; la aplicación remota decide qué significa; una política de autorización decide qué acción concede. Reunir esas tres decisiones bajo la frase «la cookie inicia sesión» impide saber cuál falló.
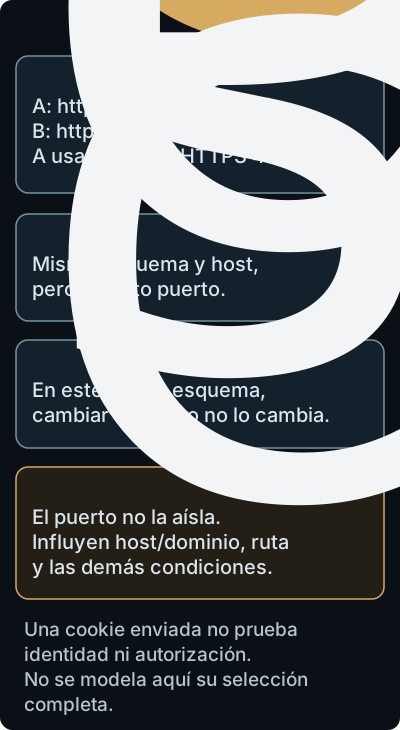
Dos URL HTTPS del mismo host con puertos distintos tienen distinto origen y el mismo site. La selección de cookies obedece otras reglas.
La caché no espera al final del recorrido
Una caché almacena respuestas y puede reutilizarlas bajo condiciones. RFC 9111 separa las condiciones para almacenar una respuesta de las reglas para construir una respuesta desde caché (RFC 9111, §§3 y 4). Por ello, «está en caché» no equivale a «es una copia vieja» ni garantiza que no ocurra ninguna interacción de red. Una respuesta puede ser reutilizable directamente, necesitar validación o no poder usarse para la petición actual.
La caché es una bifurcación de cada obtención, no una etapa única después de descargar la página. El documento principal podría necesitar red mientras una hoja de estilos procede de caché. Una imagen podría validarse y otra no estar almacenada. El algoritmo web de obtención contempla precisamente la relación entre red y caché (Fetch Standard, HTTP-network-or-cache fetch).
En nuestro caso conductor asumimos que el HTML llega por la red. Eso no obliga a que todos sus recursos sigan el mismo camino. Cuando después aparezca una imagen, el claim correcto será «el navegador dispuso de los datos de imagen y los procesó», no «la descargó del servidor principal», salvo que tengamos observaciones que lo demuestren.
La caché también cambia qué puede inferirse de un fallo. La ausencia de conectividad no implica que el navegador sea incapaz de mostrar cualquier representación previa; y ver una representación no demuestra que se haya contactado al origen durante esa apertura. La pantalla por sí sola es evidencia insuficiente para reconstruir el recorrido de red.
El documento empieza a producir trabajo antes de estar «terminado»
Cuando llegan metadatos y bytes del cuerpo, el navegador determina cómo procesarlos. Para un documento HTML, el estándar describe una tokenización y construcción del documento que puede progresar a medida que se consume la entrada (HTML Living Standard, §13.2.1). No hace falta esperar a que «se descargue toda la página» para empezar cada actividad posterior.
El documento puede contener enlaces a hojas de estilo (HTML, tipo de enlace stylesheet), elementos de imagen (HTML, elemento img) y scripts (HTML, elemento script). Una fuente tipográfica puede descubrirse al procesar una regla CSS que declara sus recursos (CSS Fonts 4, descriptor src); una solicitud también puede resultar de código o de una redirección. Por eso el mapa debe ser un grafo, no una lista que atribuya todos los recursos directamente a HTML.
Mientras continúa la recepción, pueden ocurrir varias actividades:
- el navegador decodifica y analiza parte del documento;
- descubre una hoja de estilos y decide obtenerla o reutilizarla;
- descubre imágenes y puede solicitar varias sin esperar una secuencia estricta;
- encuentra un script cuya ejecución depende de su tipo, atributos y contexto;
- aplica resultados disponibles y actualiza la representación;
- un script modifica el documento o inicia otra obtención;
- una dependencia tarda, falla o queda bloqueada y la página permanece parcial.
La numeración ordena el razonamiento, no establece una cronología obligatoria. El paso 2 puede solaparse con el 1; varias instancias del 3 pueden ocurrir concurrentemente; el 5 puede repetirse; y el 6 puede devolver el flujo hacia nuevas obtenciones. Algunas dependencias bloquean cierto trabajo y otras no. El navegador coordina un conjunto de estados que cambian, no ejecuta una receta lineal de ocho casillas.
HTML, CSS y código pueden originar obtenciones. interactive y complete describen preparación; no son un cronograma ni prometen ausencia de trabajo futuro.
Código del navegador y código de la página
La palabra «código» también necesita frontera. El navegador está construido con código propio que implementa análisis de URL, navegación, red, políticas, parseo, motor de ejecución y presentación. Ese código pertenece al agente de usuario. A la vez, una página puede suministrar scripts que el navegador ejecuta bajo sus reglas. Esos scripts son entradas del contenido, no extensiones automáticamente confiables del navegador.
Un script de la página puede cambiar texto, crear elementos, reaccionar a una acción de Mara o iniciar una obtención mediante una API web (Fetch Standard, Fetch API). Lo visible después de ese cambio se construyó localmente a partir del documento, recursos, estado y ejecución. No necesariamente llegó como una fotografía completa desde un servidor. En sentido inverso, recibir un script no implica que se haya ejecutado con éxito; puede estar bloqueado, contener un error o depender de otra condición.
Esta distinción será central en seguridad web. Por ahora basta con formular quién toma cada decisión. El servidor o intermediario puede entregar código. El navegador decide cómo tratarlo según tipo, origen, contexto y política. El motor lo ejecuta si corresponde. El código actúa dentro de capacidades delimitadas. La representación resultante no revela por sí sola qué instrucción produjo cada cambio.
La pantalla es una representación local y provisional
El navegador combina estructura, estilos, recursos y estado para construir una presentación. El HTML Living Standard incluye reglas de renderizado, pero advierte que no pretende especificar por completo todos los detalles de presentación de cada agente (HTML Living Standard, §15). Para nuestro mapa, «renderizar» significa producir y actualizar una representación perceptible, no aplicar una sola transformación final.
Mara puede ver primero el título, luego la cuadrícula y más tarde las imágenes. Que algo sea visible no significa que la carga esté completa. Que todos los bytes hayan llegado no significa que el parseo, la decodificación o la ejecución terminen correctamente. Que una respuesta sea exitosa no significa que el contenido se presente. Y una pantalla aparentemente completa puede mezclar respuestas recientes, datos de caché, estado local y resultados generados por scripts.
El último cambio de frontera va del estado interno del navegador a la experiencia de Mara. La persona recibe píxeles e interacción, no el historial causal entero. Para atribuir procedencia, autoridad o fallo hacen falta observaciones adicionales: URL efectiva, origen, mensajes, estados, políticas y eventos relevantes. La interfaz resume; no prueba la cadena completa.
Internet, web, sitio, servidor y nube
Cinco palabras frecuentes suelen comprimirse en una sola imagen de «la nube». Cada una responde una pregunta diferente.
Internet es la arquitectura e infraestructura de redes interconectadas en la que participan hosts y routers (RFC 1122, §§1.1.2 y 1.1.3). Transporta muchas clases de comunicación. No es sinónimo de web.
La web es un sistema de recursos identificados y de interacciones construido con tecnologías como URL, HTTP y HTML. La arquitectura web separa identificación e interacción precisamente para poder razonar sobre ambas (W3C, Architecture of the World Wide Web, §§2 y 3). La web usa normalmente Internet, pero Internet también sostiene otros servicios.
Un sitio web es una agrupación editorial o de producto que personas y operadores tratan como unidad. Puede abarcar varios orígenes, servidores y proveedores. El término técnico site definido por HTML es otra cosa: un valor derivado del origen que no incluye el puerto. La expresión usada debe indicar cuál de los dos sentidos pretende.
Un servidor es un rol que un componente o programa desempeña al atender peticiones. Puede participar junto con intermediarios y servicios auxiliares. La palabra no determina una máquina física ni una ubicación.
La nube describe un modelo de provisión de recursos informáticos, con características y modelos de servicio y despliegue; no es una capa situada después de Internet ni un protocolo que reciba la URL (NIST SP 800-145). Un servicio web puede usar nube, infraestructura propia, una CDN o una combinación. Nada de eso se deduce únicamente de que la página aparezca.
En el caso de Mara, la interacción usa la web sobre conectividad de Internet. fotos.example aparece en el componente de autoridad de una URL; uno o más componentes desempeñan roles de servidor o intermediario; el conjunto puede percibirse como un sitio web; y su provisión interna puede o no usar nube. Ninguno de esos términos reemplaza a los demás.
Un mapa de cambios, no una historia de cajas
Podemos reconstruir el recorrido sin mezclar tres planos: el dato que aparece o cruza, la decisión local que toma un componente y, sólo donde corresponde, la autoridad técnica atribuida a un endpoint u origen:
- Mara entrega una cadena; el navegador produce un registro URL o rechaza la entrada mediante una decisión local.
- El host y el estado local orientan una obtención; resolución o información previa pueden aportar un endpoint.
- La pila de red establece o reutiliza transporte; todavía no concede semántica HTTP.
- Para HTTPS, el cliente acepta o rechaza un canal y atribuye al endpoint autoridad para responder por el origen bajo su modelo de confianza.
- El navegador formula una petición; cookies aplicables pueden añadir estado, pero no una identidad automática.
- Servidores e intermediarios procesan o encaminan mensajes; una respuesta puede ser autoritativa, redirigida, almacenada o producida desde caché según el contexto.
- El navegador recibe campos y cuerpo, decide cómo procesarlos y construye un documento local.
- El documento, los estilos y el código pueden originar nuevas obtenciones, incluso hacia otros orígenes.
- El agente aplica, ejecuta, bloquea o descarta entradas y actualiza una representación.
- Mara observa esa representación, no el conjunto completo de decisiones.
Este mapa permite localizar errores sin fingir certeza. Una URL no interpretable aparece antes de la resolución. Un host sin endpoint utilizable se distingue de un transporte que no se establece. Un fallo de validación HTTPS ocurre después de cierta conectividad, pero antes de aceptar autoridad para el origen. Un 404 Not Found requiere una respuesta HTTP; no es «falta de Internet». Un cuerpo con tipo inesperado puede recibirse correctamente y aun no producir el documento previsto. Una imagen ausente puede deberse a obtención, política, decodificación o presentación. Una pantalla en blanco no demuestra por sí sola «un error de JavaScript».
Volver al álbum de Mara
Ahora podemos contar el caso sin falsear sus límites. El navegador analiza https://fotos.example/album/7?orden=fecha#enero y calcula un origen HTTPS. Decide que necesita obtener una representación. No dispone de una respuesta principal reutilizable, por lo que obtiene información para alcanzar un endpoint y establece un transporte nuevo. Asegura el canal y acepta la identidad del servicio para ese origen. Envía una petición HTTP cuyo target no contiene #enero; si hay estado de cookie aplicable, lo adjunta bajo sus reglas.
La respuesta exitosa al GET contiene un documento HTML. Mientras llegan y se procesan sus bytes, el navegador descubre una hoja de estilos, un script y varias imágenes. La hoja de estilos está en caché; algunas imágenes pertenecen a otro origen y se solicitan concurrentemente; una fuente se descubre al procesar CSS; el script añade un pie de foto e inicia la obtención de metadatos. El navegador construye una primera representación antes de que terminen todas las imágenes y después la actualiza. Si existe un objetivo compatible con enero, el agente puede aplicar el fragmento cuando la representación lo permita; si el objetivo todavía no existe durante el parseo, el algoritmo puede volver a buscarlo (HTML Living Standard, §7.4.2.3.3).
No afirmamos que todos los navegadores repitan exactamente ese orden. Podría existir una conexión reutilizada, una redirección, HTTP/3, un proxy o una respuesta de caché. Podría fallar un recurso sin impedir que otros aparezcan. El caso es válido porque cada transición declara sus supuestos y porque sus bifurcaciones no cambian las distinciones principales.
El producto intelectual del capítulo es esa capacidad de reconstrucción. Ante una página visible, el lector debe poder separar referencia, autoridad de origen, transporte, mensaje, estado local, dependencias, ejecución y presentación. Ante un fallo, debe poder proponer hipótesis en fronteras distintas sin adjudicar una causa por intuición.
Límites
No hemos explicado cómo funciona DNS, cómo se establece TCP o QUIC, cómo negocia TLS, cómo se multiplexan HTTP/2 y HTTP/3, cómo decide frescura una caché ni cómo se aplican todos los atributos de cookies. Tampoco desarrollamos la política de mismo origen, DOM, CSSOM, layout, pintura o ejecución de JavaScript. Cada tema requiere modelos y evidencia propios.
La secuencia tampoco sirve para inferir la topología interna de un proveedor. Una respuesta puede atravesar proxy o CDN; varios componentes distribuidos pueden desempeñar el rol de servidor; «nube» no informa el camino concreto. El mapa describe responsabilidades y fronteras observables. Las zonas sin evidencia permanecen marcadas como no observadas.
El modelo final no es una cadena de cajas, sino un grafo de obtenciones, estados y transformaciones alrededor de fronteras explícitas. La pantalla es su resultado local en un momento concreto. Reconstruir propiedades más fuertes exige volver desde ese resultado hacia la evidencia producida en cada frontera.
Fuentes principales
- WHATWG URL Standard, §§4.4 y 4.7 — análisis de URL y origen.
- HTML Living Standard, §§4.6, 4.8, 4.12.1, 7.1.1–7.1.1.1, 7.4, 13.2.1 y 15 — origen,
site, navegación, recursos, scripts, parseo y presentación. - Fetch Standard, §4 — obtención mediante red o caché.
- RFC 3986, §§1.1, 1.2.2, 3 y 5 — identificación, componentes y referencias.
- RFC 9110, §§3.2–3.7, 4.2.2, 4.3.3–4.3.4, 6, 7.1, 7.3.3, 9.3.1, 15 y 17.1 — semántica HTTP, autoridad HTTPS y roles.
- RFC 9111, §§3–5 — almacenamiento y reutilización en caché.
- RFC 8446, §§1, 4.4.2 y 4.4.2.4 — propiedades y certificado en TLS 1.3.
- RFC 9293, §§1 y 3 — TCP como concreción de transporte.
- RFC 9114, §3 — HTTP/3 sobre QUIC como contraejemplo al modelo TCP universal.
- RFC 6265, §§4.1–4.2, 5 y 5.4 — cookies HTTP. Base de almacenamiento y envío, no inventario de todas las políticas actuales.
- RFC 1122, §§1.1.2–1.1.3 — arquitectura de Internet.
- W3C, Architecture of the World Wide Web, Volume One, §§2–3 — identificación e interacción web.
- NIST SP 800-145 — definición de cloud computing.
- CSS Fonts Module Level 4, descriptor
src— localización de recursos tipográficos declarados desde CSS.
Comprobación
Mara vuelve a abrir el álbum. La URL es la esperada y el navegador muestra el título y la estructura, pero faltan las fotografías. En una segunda prueba, el modo sin conexión conserva parte del estilo. Construye una explicación con al menos cuatro hipótesis situadas en fronteras distintas: obtención o caché, origen y política, respuesta HTTP, procesamiento del recurso y representación. Para cada hipótesis, indica qué observación la apoyaría y qué otra causa seguiría siendo compatible.
Después responde, sin usar «servidor» como sinónimo de máquina: ¿qué demuestra un 200 OK para el GET del documento principal?, ¿qué no demuestra sobre las imágenes?, ¿por qué la parte visible no prueba que hubo una nueva conexión?, y qué evidencia adicional necesitarías para afirmar que una imagen procedió de un origen concreto durante esa apertura.