Un sistema no recibe «un objeto»: recibe una secuencia de bytes y decide qué secuencia de tokens, estructura y significado cree reconocer. Esa decisión es una frontera de seguridad. Si dos componentes consumen los mismos bytes con gramáticas distintas, si un parser acepta más de lo que el validador comprueba o si una autorización opera sobre una representación diferente de la que fue validada, el sistema puede ejecutar una interpretación que nadie revisó.
Este capítulo desarrolla el camino bytes → tokens → estructura → semántica → autorización. Parsing es el proceso que reconoce una entrada conforme a una gramática y construye una representación; serialización es el proceso inverso, sujeto al formato y al contrato; validación es la comprobación de propiedades que pueden pertenecer a capas distintas. No son sinónimos ni gates intercambiables. Una entrada bien formada puede violar el esquema, y una entrada que satisface un esquema puede no estar autorizada para una operación.
Qué se decide en cada frontera
En la entrada conviene conservar cuatro preguntas separadas:
- ¿Los bytes pueden decodificarse con la codificación y el encuadre declarados?
- ¿La secuencia de tokens pertenece a la gramática?
- ¿La estructura resultante tiene la forma y los tipos exigidos?
- ¿Los valores satisfacen invariantes del dominio y la operación está permitida para este principal?
La primera pregunta es de transporte o representación. La segunda es sintáctica. La tercera es estructural: cardinalidad, tipos, campos requeridos, extensiones y límites. La cuarta contiene semántica y autorización, que deben permanecer separadas: amount >= 0 es una propiedad del dominio; «la cuenta A puede reembolsar la cuenta B» es una decisión de política para un principal y un contexto.
Una implementación puede fusionar pasos por rendimiento, pero el diseño debe poder nombrar el gate que rechazó una entrada. Si se registra solamente «invalid», se pierde la causa y se dificulta saber si falló el framing, la gramática, el esquema, el dominio o la política. El caso conductor será una orden sintética {operation, account, amount, nonce} enviada sobre una interfaz que acepta JSON. La orden no se ejecuta hasta atravesar todos los gates.
Esta nomenclatura también evita atribuir a una capa la responsabilidad de otra. Un parser puede decir «objeto reconocido» sin decir «orden válida»; un validador de dominio puede decir «orden posible» sin decir «acción permitida»; una política puede decir «permitida ahora» sin prometer que la ejecución posterior no encontrará una condición de carrera. Mantener las etiquetas separadas hace explícitos los supuestos y permite que una revisión cuestione exactamente la transición que no está respaldada.
Vista adaptada. Toca el diagrama para ampliarlo.
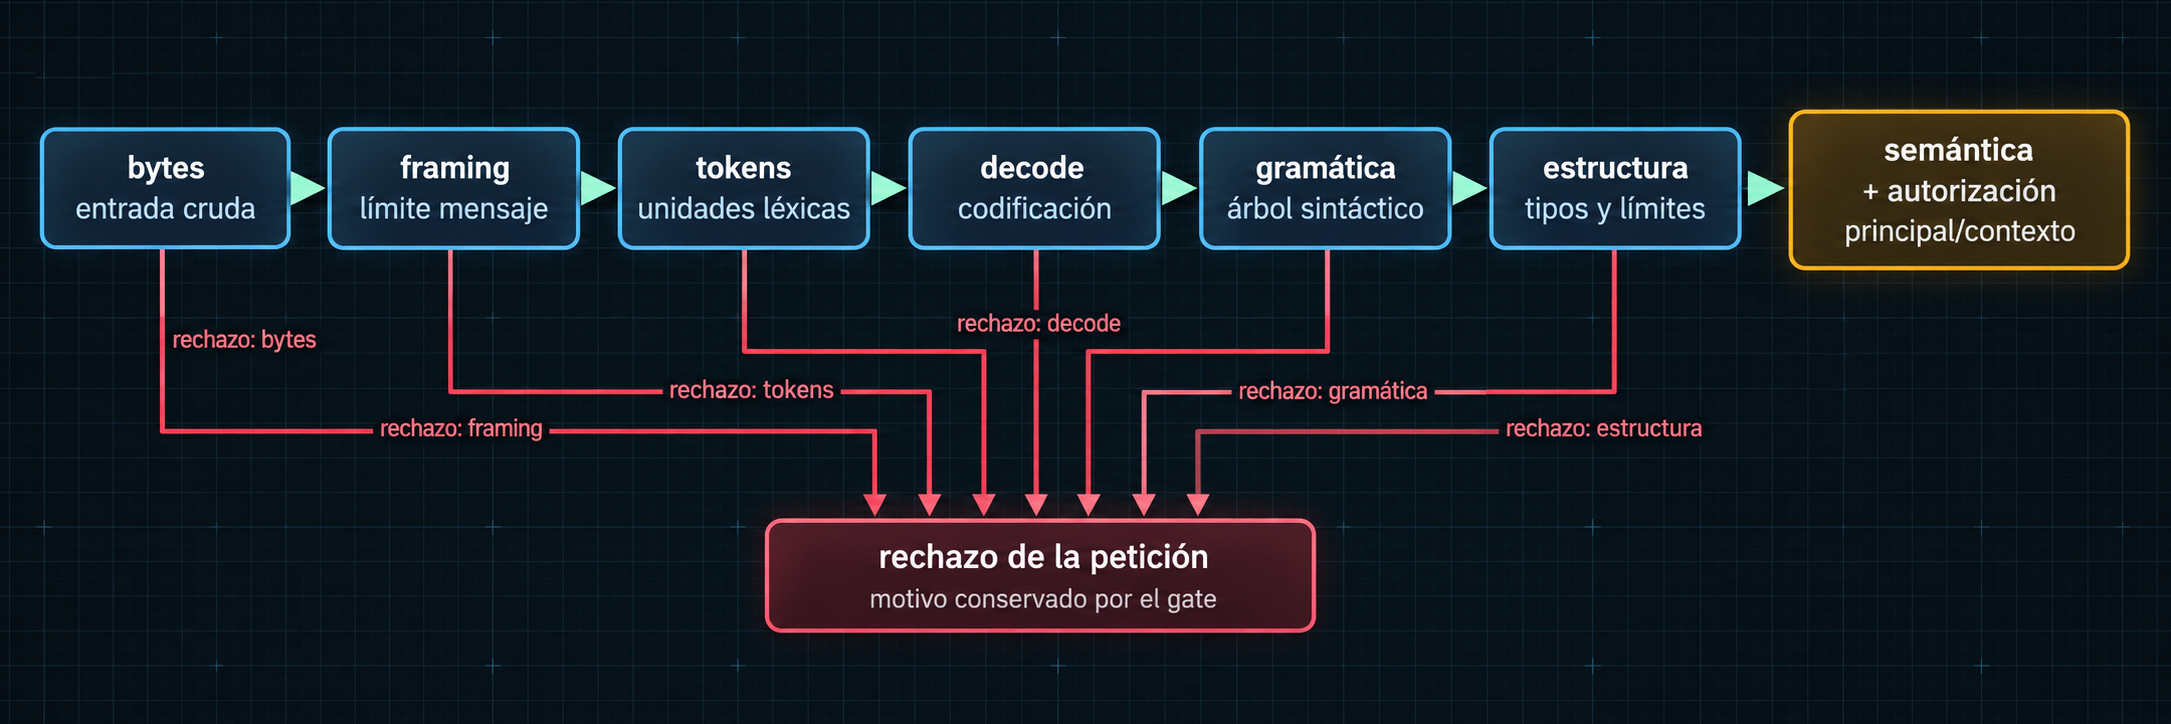
La figura (fig-0052-01) muestra la secuencia causal. Una flecha no significa que un gate conceda autorización: sólo indica que su salida es la entrada del siguiente. El parser produce una representación intermedia con posiciones y tipos; el validador trabaja sobre esa representación y la política recibe únicamente valores que ya pasaron los gates anteriores.
Bytes, codificación y tokens
Antes de reconocer una gramática existe una secuencia concreta. En texto, el protocolo debe declarar o acordar una codificación; UTF-8, por ejemplo, no convierte cualquier byte arbitrario en texto válido. El decodificador debe rechazar secuencias inválidas o adoptar la conducta especificada por el protocolo. Sustituir silenciosamente bytes inválidos por el carácter de reemplazo puede hacer que el componente receptor valide una cadena distinta de la que otro componente registró o firmó.
El framing responde dónde empieza y termina el mensaje. Puede venir dado por una longitud, un delimitador o el cierre de un flujo. Un parser que lee más allá del límite asignado mezcla mensajes; uno que lee menos puede dejar un sufijo para otro consumidor. HTTP exige reglas específicas para campos y mensajes; RFC 9110 §5.5 trata caracteres de control peligrosos en valores de campo y §6.3 describe el manejo del contenido. No se debe trasladar una regla de JSON o HTTP a otro formato sin declarar el contrato.
La tokenización transforma caracteres en unidades: llaves, separadores, nombres, números, cadenas y literales. Un token no es todavía un campo de negocio. Por ejemplo, el texto "amount": 01 puede ser rechazado por la gramática JSON de RFC 8259 §6, aunque un lenguaje de programación permita un literal octal. El tokenizador no debe «arreglar» la entrada para hacerla aceptable: normalizar, quitar espacios significativos o aceptar comillas alternativas puede crear divergencia con otro parser.
RFC 8259 §7 define los escapes Unicode de JSON y advierte que una comparación de cadenas que no trate pares sustitutos de forma uniforme puede producir comportamientos impredecibles. El formato especifica sintaxis, no la intención del valor. "admin", "ADMIN" y una forma Unicode equivalente sólo son iguales si el contrato semántico define esa equivalencia; el parser no debe inventarla.
En binario la frontera es análoga. RFC 8949 §3 separa datos bien formados de valores válidos y de «expected input» que la aplicación acepta. Un decodificador CBOR puede reconocer un item, pero la aplicación todavía debe imponer tags, rangos, tipos y límites. RFC 8949 §10 además trata riesgos de entradas excesivamente grandes y de estructuras profundas. El principio es general: decodificar no equivale a confiar.
Gramática y parser
Una gramática define qué secuencias son aceptables y cómo se agrupan. Una gramática libre de contexto puede expresarse como producciones, por ejemplo order := "{" fields "}" y fields := field ("," field)*; en producción importa además el conjunto de tokens, límites y reglas de ambigüedad. Un parser LL, LR, PEG o un parser generado por una biblioteca puede aplicar estrategias distintas, pero la gramática efectiva y el comportamiento ante error deben estar documentados.
El reconocimiento debe ser completo. Aceptar un prefijo válido y dejar bytes no consumidos es distinto de aceptar el mensaje completo. La condición habitual para un endpoint es parse(input) = tree y cursor = end; si el cursor no está al final, el gate rechaza o el protocolo define explícitamente un segundo campo. Esta comprobación evita que un componente valide {"role":"user"} mientras otro procesa un sufijo que contiene una segunda instrucción.
La ambigüedad puede ser explícita (dos árboles para una misma cadena) o surgir entre implementaciones. JSON RFC 8259 §4 dice que los nombres de un objeto deberían ser únicos para interoperabilidad y observa que implementaciones difieren cuando aparecen duplicados: algunas conservan el último, otras reportan error y otras conservan todos. Una política estricta debe fijar la conducta; rechazar duplicados suele ser más auditable que elegir silenciosamente. La misma regla debe operar antes de convertir el objeto a un mapa que ya haya perdido la multiplicidad.
El differential parsing aparece cuando una cadena pasa por dos parsers o por dos fases con reglas diferentes. Casos típicos son espacios y delimitadores, normalización Unicode, números grandes, duplicados, valores nulos, campos desconocidos y límites de longitud. El riesgo no exige un exploit para existir: basta con que el verificador firme o autorice una estructura y el ejecutor reconstruya otra. La defensa es reducir consumidores, congelar una gramática única, comparar árboles canónicos sólo cuando el formato lo define y probar pares de implementaciones con entradas de frontera.
El parser debe tener una política de error determinista. Un error de sintaxis no debe producir un árbol parcial que llegue accidentalmente al ejecutor. Si se conserva un árbol parcial para diagnósticos, su tipo debe impedir que se use como entrada validada. Los mensajes de error pueden exponer posición, regla y código, pero no deben reflejar secretos ni repetir una entrada completa no confiable en logs.
Una prueba útil es pedir a dos lectores que clasifiquen la misma entrada sólo con el contrato escrito. Si llegan a gates distintos, la especificación todavía contiene una ambigüedad que la implementación no debería resolver por accidente. La revisión debe convertir esa diferencia en una regla, un rechazo o una pregunta abierta registrada.
Representación validada y parsear una vez
Parsear una vez no es una micro-optimización: es una propiedad de coherencia. El boundary decodifica y construye una representación intermedia inmutable o con ownership claro. Los gates posteriores reciben esa representación, no vuelven a parsear el texto original ni consultan campos mediante búsquedas independientes. Tras validarla, el ejecutor recibe un tipo de dominio construido por un constructor que sólo existe para entradas aceptadas.
Una forma conceptual es:
bytes --decode/frame--> tokens --parse--> RawOrder
RawOrder --structure--> TypedOrder
TypedOrder --domain--> ValidOrder
ValidOrder + Principal + Context --policy--> AuthorizedCommand
RawOrder todavía puede contener campos desconocidos, números fuera de rango o duplicados marcados. TypedOrder ya tiene tipos y cardinalidades comprobados. ValidOrder incorpora invariantes como monto permitido y estado de nonce. AuthorizedCommand no es sólo otro nombre: contiene la decisión de política asociada al principal y contexto concretos. Si el servicio guarda TypedOrder y vuelve a consultar el JSON en una capa posterior, se reabre la superficie de divergencia.
La propiedad requiere un vínculo entre representación y evidencia: registrar un hash de los bytes no prueba que el árbol usado para ejecutar sea equivalente, salvo que el contrato defina la transformación. Es más útil registrar versión de gramática, resultado de cada gate, límites aplicados y un identificador de la representación. Los logs no deben convertirse en una segunda fuente de verdad.
Los gates no son la autorización
La validación sintáctica comprueba la forma. En la orden conductora, {"operation":"refund", "account":"A", "amount":10, "nonce":7} puede ser sintácticamente válida. La estructural exige campos exactos o política de extensiones, cadena no vacía, entero dentro de rango y nonce con el tipo acordado. La semántica comprueba que refund sea una operación definida, que la cuenta exista en el contexto de la transacción y que el monto no exceda el saldo elegible. Ninguno de esos checks concede el derecho a operar.
La autorización evalúa un principal autenticado, el recurso, la acción, el contexto y el estado relevante. Un servicio puede aceptar una orden semánticamente válida de un cliente sin permisos y rechazarla con una decisión de política; no debe alterar la estructura para «hacerla válida». También puede autorizar una orden para la cuenta correcta pero rechazarla por nonce usado, ventana temporal o estado de workflow. En una arquitectura distribuida, el ejecutor debe recibir la decisión vinculada al mismo objeto y contexto que fueron validados.
La separación mejora el diagnóstico: 400 por sintaxis o estructura, un rechazo de dominio según el contrato de la API y 403 o equivalente para autorización son ejemplos, no una norma universal. No hay que convertir códigos HTTP en categorías de seguridad sin leer el protocolo aplicable. La respuesta observable debe evitar que un atacante distinga detalles internos innecesarios, mientras que la telemetría interna conserva el gate causal.
Una distinción útil es entre presencia, tipo y significado. Que exista account no implica que sea una identidad válida; que sea una cadena no implica que tenga la codificación, longitud o forma exigidas; que tenga una forma válida no implica que el principal pueda actuar sobre ella. Del mismo modo, un campo role recibido del cliente no es una declaración de autoridad. Puede ser un dato de negocio permitido o puede ser ignorado por la política, pero nunca debe convertirse en privilegio sólo porque el parser lo reconoció.
Los campos desconocidos requieren una decisión explícita. Rechazarlos hace visible la incompatibilidad y evita que una versión antigua acepte una intención que una nueva versión interpreta de otra forma. Ignorarlos puede facilitar extensibilidad, pero sólo si el contrato garantiza que no afectan a decisiones de seguridad y que ningún componente posterior los procesa. Copiar campos desconocidos a una estructura genérica para «no perder información» es peligroso si esa estructura acaba alimentando un ejecutor diferente.
La validación debe ocurrir en cada frontera de confianza que pueda recibir datos de otra versión, proceso o propietario. «Ya lo validó el gateway» no es una propiedad transitive de los bytes: el backend debe verificar que recibió el tipo y la versión que espera, y que la decisión de autorización corresponde a su recurso. Revalidar no significa parsear dos veces la misma cadena; significa verificar el contrato de la representación que cruza la frontera y rechazar una representación cuyo origen o versión no pueda establecerse.
La concurrencia añade una condición temporal. Una orden puede ser semánticamente válida cuando se valida y dejar de serlo cuando se ejecuta porque cambió el saldo, el nonce o el estado del recurso. La comprobación de autorización debe estar vinculada a la transacción o a una condición de carrera controlada; no basta con guardar un booleano authorized=true y usarlo más tarde sin revisar la versión del estado. El parser no puede resolver esa carrera, pero su salida debe conservar los identificadores que permiten al dominio y a la política detectarla.
Vista adaptada. Toca el diagrama para ampliarlo.
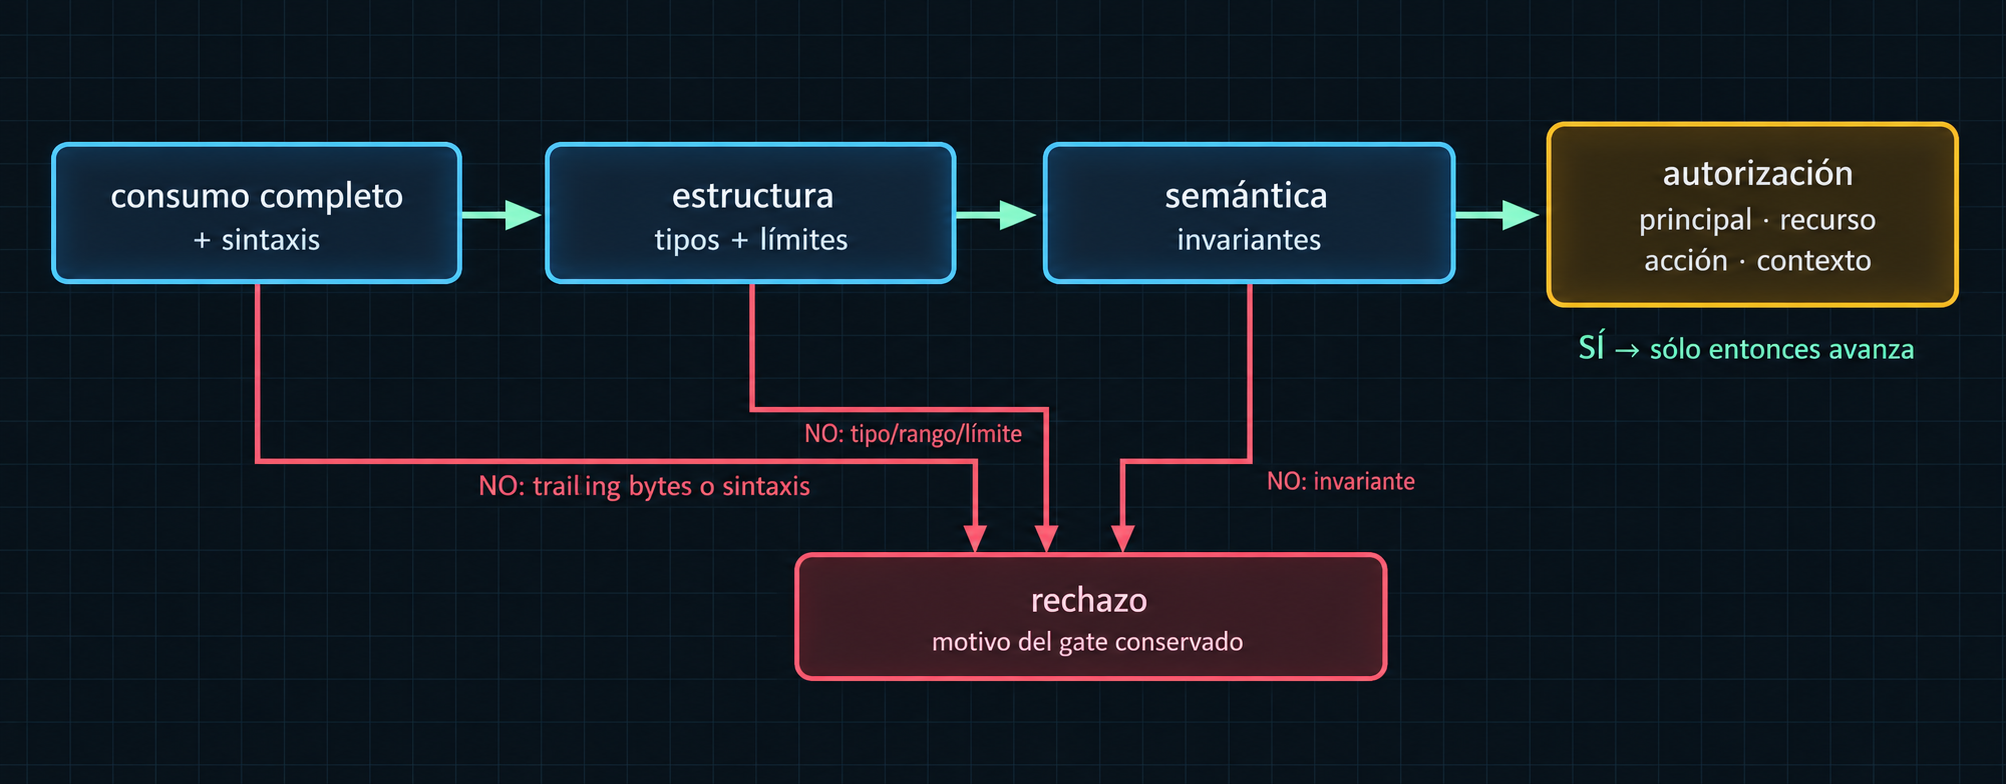
La figura (fig-0052-02) separa las cuatro decisiones. La rama de autorización parte de una representación semánticamente válida y añade principal y contexto; no entra directamente desde bytes. Las salidas de rechazo son terminales para esa petición. Esta disposición evita el error visual de representar validación y autorización como una sola caja de «validar».
Límites, recursión y consumo
Un parser seguro limita lo que puede consumir. Los límites deben existir antes de asignar recursos: bytes totales, longitud de una cadena, número de campos, profundidad de anidamiento, tamaño de un array o mapa, número de tokens, tiempo de CPU y memoria acumulada. El valor debe ser compatible con el protocolo y el uso legítimo; un límite arbitrario puede truncar entradas válidas, pero la ausencia de límite deja que una entrada no confiable dicte el coste.
La recursión convierte profundidad de entrada en profundidad de pila o en trabajo repetido. Un parser recursivo puede fijar profundidad máxima y detectar el exceso antes de llamar; uno iterativo puede usar una pila explícita con capacidad limitada. La comprobación debe cubrir también referencias indirectas, expansión de entidades, alias o tags que causen ciclos. XML 1.0 §2.1 exige documento bien formado y §4.3.2 describe entidades analizadas; una aplicación que habilita entidades externas introduce consumo y fronteras de acceso que no se resuelven con un simple check de esquema.
Los números necesitan límites propios. No basta con que el token sea numérico: hay que fijar precisión, signo, rango y conversión. Convertir primero a un entero de máquina puede truncar o desbordar antes de validar. Para una longitud n, comprobar n <= MAX y la suma header + n antes de reservar es parte del gate estructural. Para un decimal monetario, el formato puede aceptar un número que el dominio no representa exactamente. El rechazo debe ser explícito, no redondeo silencioso.
El consumo incremental y el streaming cambian el lugar del gate, no su necesidad. Un parser streaming puede procesar un array sin cargarlo completo, pero debe imponer límites acumulados y no ejecutar el primer elemento antes de saber que la estructura completa es aceptable, salvo que el protocolo defina semántica transaccional y compensación. Si la autorización depende del total, ejecutar parcialmente rompe la relación entre objeto validado y efecto.
Los límites deben medirse en unidades no ambiguas: bytes recibidos, puntos de código, tokens o elementos, según el riesgo. Una aplicación que limita caracteres después de decodificar puede asignar mucho más trabajo durante la decodificación; una que limita bytes pero permite expansión puede ser vulnerable a una relación de consumo no prevista. Registrar límite configurado, observado y resultado de rechazo permite distinguir abuso de entradas legítimas sobredimensionadas.
Los errores de límite también tienen semántica operacional. Si el consumidor recibe un flujo que supera max_depth, no debe continuar en modo tolerante ni convertir el exceso en un árbol plano. Si se agota el presupuesto de CPU, la petición debe terminar como rechazo o timeout controlado y liberar todos los recursos asociados. En un servidor concurrente, cada conexión puede consumir su propio presupuesto; un límite global sin aislamiento puede hacer que una entrada normal quede bloqueada por otra entrada costosa.
La profundidad declarada por el formato y la profundidad de la estructura en memoria no siempre coinciden. Un tag puede introducir significado sin anidar visualmente; una referencia o entidad puede expandirse a una estructura mayor; un array puede tener un solo nivel pero millones de elementos. Por ello conviene medir al menos profundidad, número de nodos y bytes acumulados. Las pruebas deben incluir el valor justo bajo el límite, el valor exacto y el primero que lo supera; sólo probar un caso enorme no revela errores de comparación o de contabilidad.
El rechazo temprano debe respetar la posibilidad de diagnóstico. Se puede guardar un código como LIMIT_BYTES, LIMIT_DEPTH o RANGE_AMOUNT y una posición, sin conservar todo el contenido no confiable. Los límites son parte del contrato observable: cambiar max_fields puede afectar compatibilidad y debe versionarse o comunicarse. Un control que sólo existe en una configuración local no es una garantía del formato.
Serialización, round-trip y forma canónica
Serializar una representación validada vuelve a producir bytes. El round-trip decode(encode(x)) = x sólo es una propiedad bajo un dominio de valores y una codificación definidos, y no debe prometerse si el decoder ya perdió duplicados, orden, escapes o precisión numérica. Puede fallar como igualdad textual aunque preserve parte de la semántica. Por eso no debe afirmarse que «re-serializar sanea» una entrada.
La serialización puede servir como puente entre componentes: un servicio decodifica, valida un tipo de dominio y emite una forma que el siguiente componente consume con el mismo contrato. Debe quedar claro qué se conserva y qué se pierde. Si los nombres duplicados ya fueron rechazados, un mapa serializado no puede reintroducirlos; si los números se redujeron a precisión binaria, el round-trip textual no recupera el decimal original. La forma canónica es una especificación del formato o del protocolo, no una preferencia estética. RFC 8949 §4.2 define requisitos de codificación determinista, incluidos tamaños preferidos y orden de claves; no debe llamarse «canonical CBOR» a una política inventada.
En JSON, RFC 8259 no define una única forma canónica de ordenar miembros ni una igualdad universal de números. Si una firma necesita bytes estables, el protocolo debe adoptar una especificación de canonicalización explícita y registrar su versión. La firma de un texto antes de parsear no protege contra dos representaciones equivalentes si los verificadores no comparten reglas. El capítulo 53 tratará en profundidad archivos, codificaciones, canonicalización y persistencia; aquí sólo se establece la frontera: serializar un valor ya validado no sustituye esos contratos.
Vista adaptada. Toca el diagrama para ampliarlo.
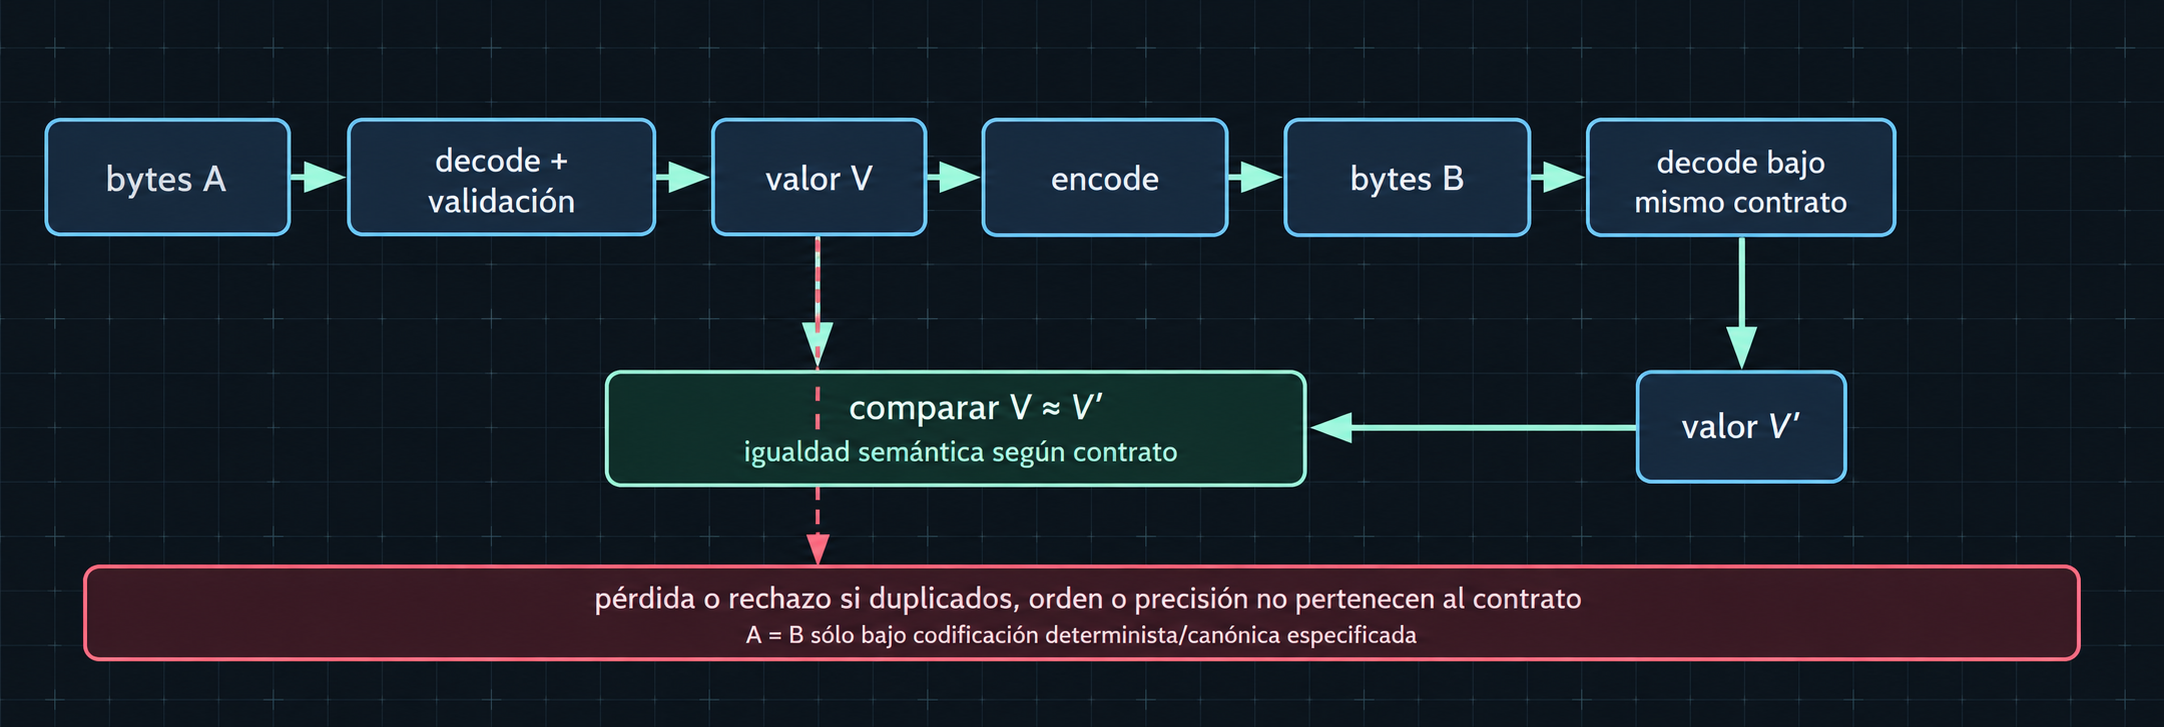
La figura (fig-0052-03) muestra el puente: los bytes iniciales se decodifican una sola vez, la representación validada se serializa según un contrato declarado y el receptor vuelve a validar su frontera. La igualdad requerida puede ser semántica o byte a byte; la figura marca ambas como decisiones distintas y no presenta la serialización como una garantía automática.
Caso trabajado y transferencia
Supóngase que el endpoint recibe dos objetos con el mismo propósito aparente. El primero contiene un campo amount repetido; el segundo incluye amount: 10 y un sufijo no consumido. El primer gate rechaza el duplicado según la política del formato; el segundo rechaza el sufijo porque el cursor no llegó al final. Una variante con amount: 1e1000 pasa una gramática permisiva pero falla el rango del dominio. Otra con una cuenta existente pasa semántica, pero un principal sin permiso falla autorización. Cuatro observaciones parecidas («la petición no se ejecuta») tienen causas y controles diferentes.
En un caso de transferencia de inventario, el mensaje puede ser sintáctica y estructuralmente correcto, pero quantity=0 puede estar prohibido por el dominio y warehouse=B puede estar fuera del ámbito del principal. El sistema debe construir la decisión a partir del mismo árbol validado; no debe volver a leer warehouse desde una cadena ni autorizar antes de resolver la unidad y el rango. El lector debe poder explicar qué evidencia pertenece a cada gate y qué no permite concluir.
Síntesis
La seguridad del parsing no reside en escoger una biblioteca con modo strict. Reside en un contrato completo: framing y decodificación explícitos; gramática única y consumo completo; representación intermedia que conserva los datos necesarios para detectar ambigüedad; límites de tiempo, memoria y recursión; validación estructural y semántica separadas; autorización vinculada al principal y contexto; y serialización con round-trip definido sólo cuando el formato lo especifica.
Para revisar una implementación conviene seguir una entrada concreta, no sólo leer nombres de funciones. Pregunte qué bytes entraron, qué decodificador los consumió, qué tokens quedaron, qué producción de la gramática se aplicó, qué nodos se construyeron y qué gate decidió el resultado. Después compare esa misma representación con la que usa el ejecutor. Si no puede reconstruirse la trayectoria, la afirmación de «validación estricta» es una etiqueta sin evidencia suficiente. Esta trazabilidad también permite probar casos negativos: duplicados, sufijos, profundidad máxima, números fuera de rango, campos desconocidos y principal sin permiso.
El modelo operativo es bytes → tokens → estructura → semántica → autorización. Cada transición reduce incertidumbre y puede rechazar, pero ninguna transición posterior debe reinterpretar silenciosamente la anterior. Parsear una vez y usar la representación validada reduce divergencia; no elimina defectos de política, implementación o configuración. Un sistema profesional puede explicar por qué rechazó una entrada, qué consumió, qué forma autorizó y bajo qué versión de contrato. Esa trazabilidad es el puente entre el mecanismo de parser y una decisión de seguridad defendible.
Fuentes primarias
La gramática, los límites y las diferencias de interpretación se contrastan con RFC 8259, §§4, 6–9 (JSON, objetos, números y seguridad); RFC 8949, §§3, 4.2 y 10 (CBOR bien formado, válido, esperado, determinismo y seguridad); RFC 9110, §§5.5 y 6.3 (valores de campo y parsing de contenido HTTP); y XML 1.0 Fifth Edition, §§2.1, 4.3.2 y 5.1 (well-formedness, entidades y validity). Estas fuentes describen formatos y procesamiento; ninguna convierte por sí sola una entrada válida en una decisión autorizada ni constituye una garantía de seguridad del sistema.