Cuando un registro parece contar más de lo que sabe
Un servicio deja esta línea: 2026-10-04T10:00:04Z orders DELETE account=184 result=denied trace=7f…. Parece una respuesta directa a una pregunta de investigación. Sin embargo, la línea no dice necesariamente cuándo ocurrió el intento, si el emisor verificó la identidad, si la transacción llegó a almacenamiento, si otro componente la reintentó ni si el reloj estaba sincronizado. Es una observación emitida por un componente, con una semántica que todavía debemos reconstruir.
Logging es la generación y conservación de registros sobre eventos que un componente observa o decide registrar. Trazabilidad es la capacidad, bajo un alcance y una calidad de evidencia definidos, de relacionar esos registros con entidades, operaciones y transiciones. Una gran cantidad de mensajes no produce trazabilidad si faltan contexto, relojes comparables, identificadores estables, procedencia o retención. Tampoco produce una garantía de que lo que no aparece no haya ocurrido.
Este capítulo construye un modelo para investigar sistemas locales y distribuidos. Separa evento, registro y evidencia; distingue relojes de calendario y relojes para intervalos; clasifica identificadores por alcance; y muestra cómo una traza une operaciones sin convertir el contexto en autenticación. El resultado profesional no es una línea de tiempo con falsa precisión, sino una conclusión que dice qué se observó, qué se infiere, qué impacto es posible y qué queda sin resolver.
¿Qué se está registrando realmente?
Un evento es una transición o hecho que un componente puede observar: una solicitud recibida, una política que permite o deniega, un proceso que sale, un mensaje que se confirma o una transacción que cambia estado. Un log record es la representación producida para comunicar esa observación. Puede contener un mensaje de texto, campos estructurados o ambos. La diferencia importa: el evento puede haber ocurrido sin que el componente lo registrara, y un registro puede describir una intención, una decisión o un resultado sin incluir las otras dos.
Un servicio que escribe DELETE requested no ha demostrado que el objeto desapareció. Un servicio que escribe DELETE committed aporta una observación más fuerte sobre su propio paso, pero aún deja abierta la consistencia con la base de datos, la réplica y la respuesta entregada al cliente. Para sostener el estado final hay que consultar la autoridad que posee ese estado o una evidencia equivalente, y conservar la relación entre solicitud, decisión y resultado.
Un registro útil declara su semántica. Como mínimo conviene identificar la fuente, el tiempo que el emisor atribuye al evento, la operación, el sujeto o proceso que actuó, el objeto afectado, el resultado, la razón o política relevante, la versión del componente y un identificador que permita relacionarlo con otras observaciones. No todos los eventos requieren todos los campos, pero cada omisión cambia la conclusión posible. Un mensaje “falló” sin operación, destino ni resultado no es intercambiable con un registro de una denegación de autorización.
La Request for Comments (RFC) 5424 ofrece un formato estructurado de syslog con campos como TIMESTAMP, HOSTNAME, APP-NAME, PROCID, MSGID y STRUCTURED-DATA. El formato hace explícita una estructura de transporte; no demuestra que el proceso haya observado correctamente el evento, que el hostname sea auténtico ni que el colector haya recibido todos los mensajes. La procedencia y la integridad deben argumentarse aparte. RFC 5424, §§6.2–6.3
Conviene separar tres preguntas al leer un registro:
- ¿Qué afirmó el emisor? Es la observación directa sobre el contenido y la semántica de la línea.
- ¿Qué relación con otros registros permite? Depende de los identificadores, de la fuente y del contexto propagado.
- ¿Qué estado del sistema queda probado? Requiere saber qué componente tiene autoridad sobre ese estado y si la observación conserva el resultado, no sólo el intento.
Esta separación evita llamar evidencia a un indicio aislado. Un registro es un insumo de evidencia; la evidencia técnica incluye su procedencia, contexto, integridad, versión y cadena de conservación.
El tiempo del evento no es el tiempo de llegada
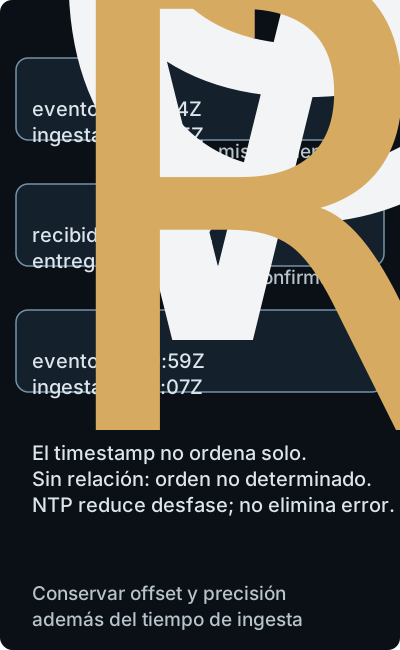
NTP reduce desfase; no elimina incertidumbre ni convierte timestamps en causalidad.
Un timestamp responde a una pregunta sólo cuando conocemos qué reloj lo produjo, cuándo se tomó y qué error puede tener. RFC 3339 define representaciones de fecha y hora de Internet con Z para Coordinated Universal Time (UTC) o un offset numérico. Es útil para transportar una convención común, pero no sincroniza relojes ni corrige el retardo de transporte. También contempla que el offset local sea desconocido; ocultar esa incertidumbre con una hora aparentemente exacta degrada la interpretación. RFC 3339, §§4 y 5.6
Hay, al menos, tres tiempos que no deben mezclarse:
- Tiempo de evento: lectura del reloj del componente cuando observa o decide registrar algo.
- Tiempo de ingestión: instante en que un agente, colector o almacenamiento recibe el registro.
- Tiempo de análisis: momento en que una herramienta ordena, normaliza o presenta la evidencia.
El orden de ingestión puede ser útil para reconstruir cómo llegaron los mensajes a un colector, pero no siempre es el orden en que ocurrieron. El tiempo de evento puede acercarse al instante de observación, pero dos hosts pueden tener desfase distinto. El tiempo de análisis es posterior y no aporta por sí mismo información causal.
Portable Operating System Interface (POSIX) distingue CLOCK_REALTIME, que representa un tiempo de calendario ajustable, de CLOCK_MONOTONIC, destinado a medir intervalos que no deben retroceder por ajustes del reloj. Un timeout de tres segundos debe medirse con una referencia monotónica; una fecha que una persona compara con un ticket suele usar tiempo de calendario. Si una investigación ordena logs con un reloj ajustado hacia atrás, una secuencia visual puede contradecir el intervalo real sin que exista una contradicción en el proceso. POSIX clock_gettime()
La sincronización mediante Network Time Protocol (NTP) estima offset y delay entre relojes bajo supuestos sobre las fuentes y el camino de red. Reduce el desfase operativo, pero deja error residual, interrupciones y posibilidades de manipulación. Por eso una política de logging debería conservar, cuando sea relevante, la fuente de tiempo, la precisión, el estado de sincronización y el offset conocido. “Todos usan UTC” describe una representación, no la calidad temporal. RFC 5905, §§3–4 y 8
En sistemas distribuidos rara vez existe un reloj único que ordene toda transición. Si el gateway registra una petición en 10:00:04Z y el worker registra su consumo en 09:59:59Z, ambos hechos son compatibles con un reloj del worker adelantado, con una cola y con distintos tiempos de ingestión. El identificador compartido puede apoyar que pertenecen a la misma operación, pero no convierte los timestamps en una prueba de causalidad. La relación fuerte sería un mensaje observado, un parent-id, un offset de cola o una confirmación que preserve la dependencia.
El modelo correcto es un orden parcial: A precede a B cuando un mismo reloj monotónico muestra el intervalo, cuando un componente registra que envió un mensaje que otro confirmó o cuando una relación de padre e hijo se conservó. Para los pares sin una relación verificable, se mantiene “antes”, “después” o “concurrente” como hipótesis con incertidumbre. Es preferible declarar dos eventos no ordenables que inventar una secuencia exacta.
Identificadores: alcance antes que apariencia
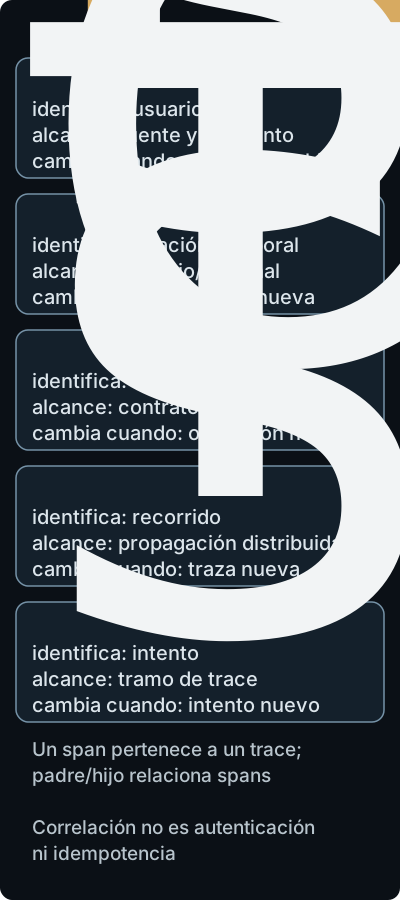
Correlación no autentica ni deduplica efectos.
Un identificador es una etiqueta que permite referirse a una entidad, operación o relación dentro de un alcance. Un número largo no es automáticamente único en todo el sistema; un identificador universalmente único (UUID, por sus siglas en inglés) no es una firma; y un nombre legible puede cambiar o colisionar. La pregunta profesional es qué designa, quién lo genera, cuánto dura, dónde se propaga, si puede reutilizarse y si expone información.
Es útil distinguir categorías:
- Identificador de entidad: usuario, cuenta, proceso, host, workload o recurso. Debe resolver a una entidad en un momento y fuente concretos. El mismo nombre textual puede mapear a distintos UID, tenants o proveedores.
- Identificador de sesión: relación temporal de un principal con un servicio o terminal. No es sinónimo de token ni prueba por sí mismo de quién posee la sesión.
- Request ID: referencia a una entrada concreta en un endpoint o proceso. Un reintento puede recibir otro request ID aunque represente la misma operación de negocio.
- Correlation ID u operation ID: etiqueta estable para relacionar intentos que forman una operación lógica, como un pago. Correlacionar no deduplica por sí solo: el receptor puede registrar el mismo ID y ejecutar dos veces.
- Trace ID: etiqueta del recorrido distribuido que agrupa spans relacionados. Sirve para correlación; no autentica al originador.
- Span ID y parent ID: identifican una operación dentro de una traza y su relación inmediata. Permiten reconstruir un árbol o grafo parcial, no todo lo que ocurrió fuera de la propagación.
Una clave de idempotencia pertenece a otro contrato. El cliente presenta una clave dentro de un ámbito definido y el receptor conserva suficiente estado para reconocer una repetición equivalente y evitar que vuelva a aplicar el efecto, o para devolver el resultado acordado. Deben documentarse principal, operación, equivalencia del payload, ventana de retención, colisiones, concurrencia y respuesta ante reutilización incompatible. No es necesariamente el operation ID, request ID ni trace ID: puede vincularse a ellos para observabilidad, pero sólo el contrato y el estado de deduplicación le conceden efecto. Esta es una recomendación de diseño acotada, no una propiedad universal de esos identificadores.
El World Wide Web Consortium (W3C) Trace Context define traceparent y tracestate para propagar contexto entre servicios. El trace-id agrupa una traza y el parent-id relaciona la operación con su padre según las reglas del estándar. Un componente puede recibir contexto no confiable desde una frontera externa, decidir si lo acepta o genera uno nuevo y registrar la decisión. Transportar un valor no prueba la identidad del emisor, la integridad del encabezado ni autorización para la acción. W3C Trace Context 1.1, §§3–4
Los identificadores deben conservar su semántica durante colas, reintentos y llamadas asíncronas. Un worker puede crear un nuevo span por cada entrega y conservar el operation ID para correlacionar reintentos del mismo trabajo. Si además debe impedir un efecto duplicado, necesita un contrato de idempotencia y un registro de deduplicación, no sólo la coincidencia del ID. Si se propaga sólo el request ID del gateway, un segundo intento del consumidor puede parecer otra operación. Si se conserva sólo el trace ID, se pierde la distinción entre intentos y el punto exacto de fallo. Diseñar el contrato requiere declarar qué cambia, qué permanece estable y qué componente posee el estado que decide aplicar o rechazar el efecto.
Nunca conviene convertir un identificador de correlación en secreto. Si es predecible o aparece en una URL, puede permitir enumeración o fuga de contexto. Tampoco se debe registrar un token, una contraseña o un dato personal completo sólo porque facilita búsquedas. Se puede usar un identificador interno estable, una referencia parcialmente redactada o una huella con política documentada, siempre que la transformación no impida investigar el caso autorizado.
De muchos registros a una traza defendible
Una traza es un conjunto relacionado de operaciones, normalmente con un trace ID y relaciones de padre, hijo, enlace o continuación. No es un archivo ni una pantalla de una herramienta. Se produce cuando cada frontera que participa en el flujo conserva suficiente contexto y el pipeline mantiene procedencia. Una traza puede estar incompleta por muestreo, filtros, caída de agentes, rotación, colas sin propagación o componentes que no instrumentan.
Considérese un flujo sintético: gateway recibe POST /pay, crea request-id=R1 y trace-id=T; orders valida una orden y publica un mensaje; payments intenta cobrar, recibe una respuesta transitoria y reintenta. El primer intento tiene span-id=P1 y el segundo P2; ambos conservan operation-id=O1. El gateway puede registrar una respuesta 202 antes de que payments termine. La cola puede añadir un tiempo de entrega. El backend puede registrar la decisión de reintentar y luego el resultado final.
La pregunta “¿se cobró dos veces?” no se resuelve contando spans ni buscando el mismo texto. Hay que relacionar la operación lógica O1, los intentos P1 y P2, la respuesta de la autoridad de pagos y el estado persistido de la orden. Dos spans prueban dos observaciones de intento; no prueban dos cargos. Un mismo span repetido en el colector puede ser un duplicado de transporte. Un operation ID reutilizado fuera de su ventana podría unir transacciones distintas.
La propagación también se rompe en procesos asincrónicos. El productor puede guardar el contexto en atributos del mensaje, pero el consumidor debe extraerlo y registrar su propia lectura. Un broker con offsets y confirmaciones aporta evidencia adicional sobre entrega y consumo, no necesariamente sobre procesamiento exitoso. Si falta el identificador de mensaje o el parent ID, el hueco debe marcarse como tramo no correlacionado; no debe rellenarse con una coincidencia de hora o nombre.
Un pipeline profesional conserva al menos la fuente, la recepción, el payload o su referencia autorizada, la operación, el resultado y la transformación aplicada. El colector debe registrar pérdida, retraso, rechazo, duplicado y muestreo. Si una política elimina eventos de baja severidad, la investigación debe conocer el filtro y su ventana, porque “no se encontró” puede significar “no se conservó”.
Integridad, procedencia y retención
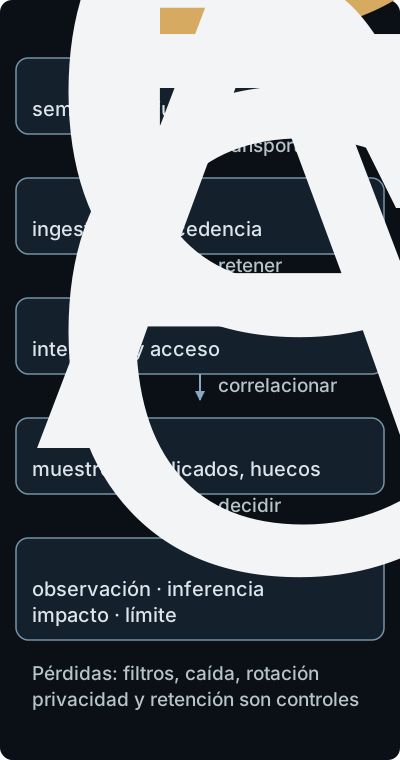
Retención, integridad, acceso y privacidad limitan la evidencia disponible.
Un log local es útil para diagnosticar el proceso que lo emitió, pero puede desaparecer con el proceso, perderse por rotación o ser modificado por una autoridad con acceso al host. Remitir una copia a otro sistema mejora disponibilidad y separación de funciones, pero introduce otra cadena: transporte, autenticación, autorización, buffering, reloj de recepción y retención. La pregunta deja de ser sólo “¿qué escribió el servicio?” y pasa a ser “¿cómo sabemos que esta copia corresponde al mensaje emitido y qué huecos existen entre ambos puntos?”.
NIST SP 800-92 trata la gestión de logs como un proceso que incluye generación, análisis, almacenamiento y disposición, junto con responsabilidades e infraestructura. NIST SP 800-92, §§2–4 NIST SP 800-86 sitúa la evidencia en un proceso de preservación, examen, análisis y reporte. NIST SP 800-86, §§3–4 Aplicado a una investigación, esto significa conservar el origen y el contexto, documentar exportaciones, mantener la zona horaria y registrar cualquier normalización. Una base de datos que reescribe timestamps o elimina campos sin historial puede seguir siendo operacionalmente útil, pero reduce el claim forense.
La retención expresa cobertura temporal, no calidad. Siete días de registros íntegros pueden ser preferibles a meses sin procedencia, pero si la hipótesis exige revisar diez días, la ventana impone una incertidumbre material. Backups, métricas, logs de un proveedor o artefactos de proceso pueden ampliar la cobertura sólo si se puede establecer su fuente, alcance y relación temporal. La ausencia de un registro no demuestra la ausencia del evento: puede indicar que nunca se generó, que se filtró, que se perdió, que se rotó o que no era observable desde ese componente.
Registrar todo tampoco resuelve el problema. El volumen puede hacer inviable la búsqueda; los campos pueden no tener semántica estable; la duplicación puede ocultar los pocos eventos relevantes; y el almacenamiento puede convertirse en un activo con datos sensibles. Un contrato de logging especifica qué decisión apoya cada campo, qué valor tiene, qué redacción aplica, quién accede y cuánto tiempo debe conservarse. El diseño debe equilibrar utilidad investigativa, privacidad, rendimiento e integridad.
Un método de análisis profesional
Empiece con la pregunta, no con el buscador. “¿Qué ocurrió?” es demasiado amplio; “¿qué identidad recibió autorización para cambiar el recurso O entre las 10:00 y las 10:05?” delimita fuente, intervalo, operación y propiedad. Después enumere qué componente tiene autoridad sobre cada afirmación. Un gateway puede afirmar que recibió una solicitud; el servicio de autorización puede afirmar una decisión; la base de datos puede afirmar una transacción.
A continuación, preserve los artefactos originales y anote transformaciones. Normalice formatos sin destruir el timestamp original, la fuente ni el tiempo de ingestión. Reúna estado de sincronización y offsets de reloj. Separe los campos generados por el emisor de los añadidos por un colector. Luego construya una matriz de eventos con origen, identificadores, tiempo de evento, tiempo de ingestión, relación observada y calidad de evidencia.
Correlacione primero por relaciones fuertes: parent ID, identificador de mensaje, confirmación de cola, referencia de transacción o un operation ID con contrato de unicidad. Use igualdad de texto, cercanía temporal, hostname o nombre de cuenta sólo como indicios secundarios. Para cada enlace, declare por qué es válido y qué alternativa queda abierta. Un grafo parcial con un hueco explícito es más defendible que una línea de tiempo completa construida por coincidencias débiles.
Finalmente, redacte cuatro capas:
- Observación: qué registros existen, de qué fuente, con qué campos y procedencia.
- Inferencia: qué relación es compatible con esos registros y qué supuestos la sostienen.
- Impacto posible: qué decisión, exposición o pérdida seguiría si la inferencia fuera correcta.
- Decisión y límite: qué acción está justificada y qué evidencia falta para elevar la confianza.
Este método evita que una herramienta de observabilidad convierta su propio grafo en una verdad. El grafo es una interpretación de datos y reglas; debe poder explicarse y reproducirse.
Errores frecuentes y sus correcciones
“UTC demuestra el orden.” UTC unifica representación. Corrija conservando desfase, precisión, ingestión y relaciones de mensajes.
“El mismo ID es la misma identidad.” Un nombre o identificador puede tener alcance de servicio, tenant o ventana temporal. Corrija vinculándolo a una fuente de resolución y a la credencial o principal que lo originó.
“El trace ID autentica la solicitud.” El contexto de traza es correlación. Corrija separando autenticación, autorización, integridad del transporte y trazabilidad.
“El log dice éxito, por tanto el estado cambió.” Puede registrar intención, respuesta provisional o una operación que falló después. Corrija consultando la autoridad del estado y el resultado transaccional.
“No hay log, por tanto no ocurrió.” Hay filtrado, pérdida, caída, muestreo y límites de observación. Corrija examinando el contrato de cobertura y fuentes alternativas.
“Más logs significa más control.” Volumen sin semántica, retención ni acceso puede aumentar coste y exposición sin mejorar una decisión. Corrija diseñando cada campo para una pregunta y una política.
“Un colector remoto hace la evidencia inmutable.” El colector agrega otra superficie y autoridad. Corrija documentando autenticación, transporte, permisos, retención, detección de pérdida y procedencia.
Cierre: la trazabilidad es una conclusión acotada
Un sistema trazable no es el que produce más texto, sino el que permite relacionar observaciones con entidades, operaciones y estados dentro de condiciones explícitas. Un buen diseño distingue evento de registro, tiempo de evento de ingestión, reloj de calendario de reloj monotónico, identidad de correlación y traza de autenticación. Preserva procedencia y declara pérdidas, muestreo, reintentos, desfase y retención.
La secuencia profesional queda así: definir la pregunta y la frontera; identificar la autoridad de cada estado; emitir registros con semántica; conservar tiempos y fuentes; propagar identificadores con alcance documentado; proteger y retener el pipeline; reconstruir un orden parcial; y redactar la conclusión separando observación, inferencia, impacto y decisión. Cada paso tiene límites. NTP no elimina incertidumbre; RFC 5424 no valida un emisor; traceparent no otorga permiso; un ID no es una firma; y la ausencia de un log no es ausencia del evento. La calidad de la conclusión depende de mantener esas distinciones cuando cambian la versión del servicio, el proveedor de tiempo, la ruta de mensajería o la política de retención. Si una de esas condiciones cambia, el contrato de logging y la confianza en la traza deben revisarse, no suponerse heredados.
Esta disciplina convierte logging en evidencia operativa utilizable sin atribuirle omnisciencia. Cuando el capítulo siguiente estudie fronteras de aislamiento, el mismo modelo permitirá preguntar qué observaciones cruzan una frontera, qué reloj las ordena y qué identificador conserva la relación. La trazabilidad no sustituye el razonamiento: lo hace auditable.