Un resultado negativo no habla por sí solo
La dirección recibe tres frases al final de una evaluación de una API de pagos: el escáner no encontró vulnerabilidades críticas, las pruebas de autorización no produjeron respuestas inesperadas y el sistema de monitorización no generó alertas durante cuatro horas. La pregunta llega en una forma aparentemente sencilla: «¿Podemos declarar la API limpia y cerrar el incidente?»
La respuesta profesional no es elegir entre optimismo y alarma. Es preguntar qué significan exactamente esas salidas. Un escáner puede no cubrir una clase de debilidad. Una prueba puede no haber alcanzado una ruta o un rol. El monitor puede haber perdido eventos. Incluso si los instrumentos funcionaron perfectamente, un resultado negativo sólo habla de la condición definida, en la población y el período que el método podía observar.
Este capítulo enseña a interpretar esa clase de silencio. Presenta incertidumbre epistémica y aleatoria, controles positivos y negativos, límites de detección, falsos resultados, prevalencia y lenguaje calibrado. No desarrolla todavía ingeniería de detección ni métricas operativas de un centro de operaciones. La pregunta es anterior: ¿qué permite afirmar un resultado sin hallazgos, y qué decisión queda fuera de su alcance?
El caso exige una afirmación más estrecha
La frase «cero hallazgos críticos» mezcla varias preguntas. ¿Se buscaban errores de autorización, inyección, exposición de secretos o sólo configuraciones conocidas? ¿Se incluyeron todas las rutas, tenants, roles y versiones? ¿Qué criterio convirtió una salida en «crítica»? ¿La monitorización debía detectar un comportamiento concreto o cualquier acceso anómalo? ¿Los logs llegaron completos? ¿Se comprobó que la cadena de observación podía registrar una condición conocida?
Una evaluación es un procedimiento para responder una pregunta, no una inspección de la realidad sin mediación. NIST SP 800-53A Rev. 5 organiza los procedimientos alrededor de objetivos, objetos y métodos concretos; distingue examine, interview y test, y separa la profundidad —el rigor— de la cobertura —el alcance de objetos y pruebas—. NIST SP 800-53A Rev. 5, §§2.4–2.4.2
Así, una conclusión defendible podría ser: «En la versión 4.8 de la API, sobre las rutas y roles incluidos en el plan, el procedimiento ejecutado no identificó hallazgos clasificados como críticos durante el período de prueba». La frase informa algo útil. No afirma que no existan debilidades de otra clase, que no haya rutas fuera del plan, que el servicio permanezca igual después de un cambio ni que el incidente no ocurriera.
Este recorte no es una maniobra retórica para evitar una decisión. Es lo que permite relacionar observación, alcance y acción. NIST SP 800-30 Rev. 1 pide definir propósito, ámbito, supuestos y restricciones; también advierte que la incertidumbre de esos supuestos puede afectar la tolerancia al riesgo. NIST SP 800-30 Rev. 1, §3.1, Task 1-3
Qué significa incertidumbre
Incertidumbre es la falta de certeza suficiente para asignar un estado, una medida o una explicación sin reservas. No significa que todas las opiniones valgan lo mismo. Significa que existe una distancia entre lo que ocurre, lo que el método puede observar y lo que la evidencia permite sostener.
Una parte de esa distancia es epistémica: falta conocimiento. Puede no saberse qué regla estaba activa, qué versión del servicio respondió, qué activos quedaron fuera, si el reloj del sensor estaba sincronizado o si el parser descartó un campo. La incertidumbre epistémica puede reducirse recuperando configuración, conservando procedencia, ampliando cobertura o diseñando una prueba discriminante.
Otra parte es aleatoria: el fenómeno o la medición varían entre observaciones aunque el método esté especificado. Una latencia puede fluctuar; una muestra puede caer en una ventana distinta; un mecanismo que muestrea paquetes puede observar conjuntos diferentes. Repetir y caracterizar ejecuciones puede estimar esa variación, pero documentar mejor el procedimiento no la elimina.
La distinción es una herramienta de diagnóstico, no una frontera metafísica. Una variación que parece aleatoria puede revelar después una causa desconocida, y una falta de conocimiento puede permanecer aunque se acumulen datos. NIST Technical Note 1297 ofrece una cautela relacionada: Type A y Type B describen métodos para evaluar componentes de incertidumbre, no son sinónimos de incertidumbre «aleatoria» y «sistemática». NIST TN 1297, Apéndice D1
En seguridad conviene preguntar, para cada duda: ¿qué no sabemos?, ¿qué variación esperamos?, ¿qué dato podría reducirla?, ¿qué decisión es sensible a ella? Si no conocemos la configuración del sensor, más ejecuciones idénticas pueden producir una falsa sensación de precisión. Si conocemos el sensor pero el fenómeno varía, una única ejecución puede ser insuficiente aunque haya sido perfectamente documentada.
Positivos, negativos y referencia de verdad
Un resultado positivo significa que el método clasificó o encontró la condición buscada. Puede ser un verdadero positivo si la condición estaba presente, o un falso positivo si no lo estaba. Un resultado negativo significa que el método no la reportó. Puede ser un verdadero negativo si la condición estaba ausente, o un falso negativo si estaba presente y el método no la detectó.
Estas cuatro categorías cruzan dos planos que no deben confundirse: el estado del mundo y la salida del método. «No alertó» describe la salida. «No había actividad anómala» describe una conclusión sobre el mundo y exige un criterio independiente o una referencia de verdad. Sin esa referencia, no se puede adjudicar todavía si el negativo fue correcto.
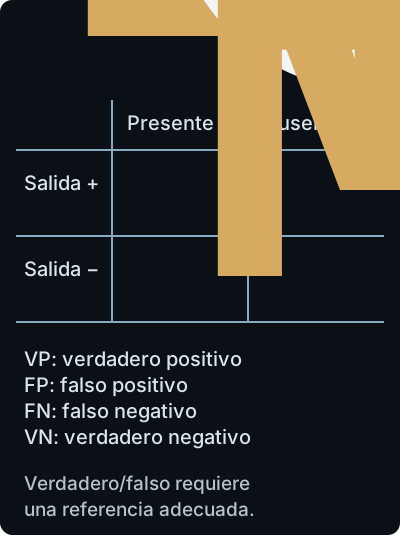
La salida sólo fija una fila. Para llamarla verdadera o falsa hace falta una referencia de estado independiente y adecuada.
La terminología depende del objeto. NIST define, para análisis de código fuente, un falso negativo como el caso en que una herramienta no reporta una debilidad presente; añade que no es falso negativo no reportar una clase de debilidad que la herramienta no pretende identificar. NIST SP 500-268, §1.5 La precisión importa: una herramienta no falla por no resolver una pregunta que nunca prometió responder.
Por eso una revisión debe declarar su detection target: la condición, clase o comportamiento que intenta hacer visible. «Detectar abuso» es demasiado amplio. «Reportar cinco intentos fallidos contra cuentas de producción desde una red no autorizada dentro de diez minutos» ofrece un objetivo que puede probarse, aunque todavía haya que definir excepciones, retrasos y fuentes.
El instrumento puede estar ciego
Un resultado negativo tiene significado sólo si el instrumento tenía una oportunidad razonable de observar la condición. Esa oportunidad se divide, al menos, en cinco preguntas.
- Objetivo: ¿la condición presente pertenece a la clase que el método declara cubrir?
- Cobertura: ¿se incluyeron los activos, rutas, estados, roles, tenants, versiones, fuentes y períodos relevantes?
- Sensibilidad: bajo las condiciones definidas, ¿con qué frecuencia detecta el método una condición presente?
- Salud y transporte: ¿el sensor, la colección, el almacenamiento, el parser y la consulta funcionaron?
- Criterio: ¿la referencia usada para decidir presencia era adecuada y suficientemente independiente?
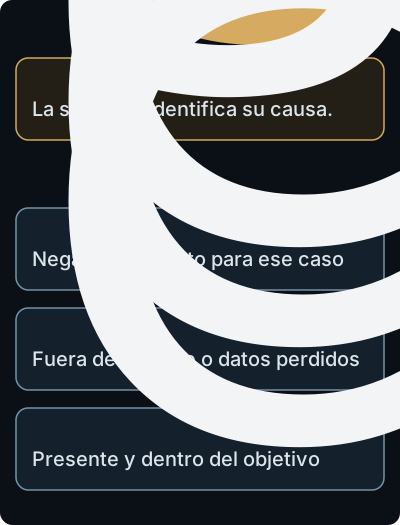
Antes de interpretar el silencio hay que distinguir ausencia real de una clase no soportada, falta de cobertura, pérdida de telemetría o falso negativo.
La sensibilidad no es una propiedad universal de una herramienta. Es una capacidad medida para una clase de condiciones, una población, una configuración y un umbral. Un escáner puede ser sensible a una versión vulnerable de una biblioteca y ciego a un fallo de lógica de negocio. Un monitor puede detectar un patrón en logs de autenticación y no ver un abuso que ocurre enteramente dentro de una sesión válida.
La cobertura tampoco es una cifra autosuficiente. Cubrir cien por ciento de las rutas declaradas no incluye una ruta olvidada; cubrir todos los hosts registrados no incluye un activo que nunca entró en el inventario. NIST SP 800-53A presenta cobertura como el alcance y amplitud de los objetos evaluados, mientras que profundidad describe el nivel de rigor. NIST SP 800-53A Rev. 5, §2.4.2
El tiempo introduce otra frontera. NIST SP 800-115 señala que el testing técnico suele tener alcance estrecho por limitaciones de tiempo y recursos y que no proporciona una evaluación integral de toda la postura; combinar métodos puede ofrecer una visión más adecuada. NIST SP 800-115, §2.3 Cuatro horas sin alerta no equivalen a cuatro horas de observación perfecta, y una prueba anual no convierte en estable una configuración que cambia cada día.
Controles positivos y negativos
Un control positivo introduce o simula una condición conocida que el método debería detectar. Un control negativo presenta una condición conocida ausente o benigna que no debería activar el método. No son sinónimos de «resultado bueno» y «resultado malo»: son experimentos de la capacidad de discriminación.
Para una regla que busca acceso administrativo desde una red no autorizada, el positivo puede usar una identidad de laboratorio, una red de prueba clasificada deliberadamente como no autorizada y un identificador rastreable. La expectativa es que el evento llegue al colector, sobreviva al parsing y produzca una alerta. El negativo puede usar una identidad autorizada desde una red aprobada, comprobando que la misma ruta no activa la regla por error.
El positivo responde: «¿la cadena puede hacer visible esta condición conocida ahora?». El negativo responde: «¿la cadena evita activar la regla ante este caso benigno conocido?». Si el positivo falla, un negativo posterior pierde fuerza: no sabemos si el silencio indica ausencia o incapacidad de observación. Si el negativo activa, la regla puede tener un problema de especificidad —su capacidad, medida contra una referencia definida, de no activar ante casos que no contienen la condición— o el escenario quizá no era realmente benigno; hay que adjudicarlo antes de usar resultados reales.
Ambos controles tienen límites. Un positivo de una sola variante no valida todas las variantes de la clase. Un negativo no prueba que nunca habrá falsos positivos en otra población. El control debe estar dentro de la misma frontera de versión, configuración, permisos, pipeline y período operativo que el resultado que se interpreta.
Base rates sin convertir el capítulo en estadística
La tasa base o prevalencia es la frecuencia con que aparece la condición en la población considerada. Cambia el significado de una salida. Supongamos un detector probado sobre 10.000 transacciones. Si sólo diez contienen la condición y el método detecta nueve, pero activa por error en 100 transacciones benignas, habrá 109 positivos y sólo nueve serán verdaderos. La tasa de verdaderos positivos del método puede parecer buena; sin embargo, un positivo aislado tiene una probabilidad modesta de representar la condición real.
Si la condición fuera mucho más frecuente en otra población, unas mismas tasas de error producirían una mezcla distinta. Por eso sensibilidad, especificidad o tasa de falsos positivos no bastan para contestar «¿qué significa esta alerta aquí?». Hace falta conocer —o reconocer que se desconoce— la prevalencia, la selección de casos y las consecuencias de cada error.
Podemos comprobarlo con otro ejemplo sintético que conserva las tasas. Imagina dos poblaciones de 10.000 casos, con sensibilidad del 90 % y especificidad del 99 %. Esto significa detectar nueve de cada diez casos con la condición y no alertar en 99 de cada 100 casos sin ella. Supondremos que esas tasas se mantienen en ambas poblaciones; en un despliegue real habría que comprobarlo.
Desliza horizontalmente para consultar todas las columnas.
La sensibilidad sigue siendo 90 %; la proporción de alertas correctas cambia porque su denominador incluye también los falsos positivos. Son cocientes distintos: uno parte de los casos que contienen la condición; el otro, de las alertas. NISTIR 7972, §§3.2.3, 3.2.5, 3.2.7–3.2.8 define estas métricas para detección de objetos; aquí reutilizamos las relaciones de una clasificación binaria, no sus resultados empíricos ni su contexto de robótica.
Supongamos además una regla local ficticia: escalar directamente a una revisión urgente cuando más del 80 % de los positivos sean casos reales; por debajo, pedir una comprobación independiente antes de esa escalada. Con los costes y la política mantenidos, la primera población requiere confirmación y la segunda permite escalada directa. El 80 % no es un umbral recomendado ni una norma: hace visible por qué cambiar la tasa base puede cambiar una decisión. Si el daño de esperar fuese alto, podría convenir actuar precautoriamente en ambas poblaciones. Ni la estadística ni la política convierten una alerta concreta en un hecho confirmado.
Este razonamiento también afecta los negativos. Cuando la condición es rara, muchos negativos serán verdaderos incluso con un método mediocre; eso no demuestra que el método cubra bien una variante peligrosa. Cuando la condición es común y la sensibilidad es limitada, un negativo merece más sospecha. No hace falta calcular una probabilidad posterior para actuar con prudencia: basta preguntar qué población sostiene la métrica y si se parece al caso actual.
La tasa base rara vez es estable en seguridad. Una campaña activa, un cambio de arquitectura o un incidente reciente pueden modificarla. Las muestras de laboratorio suelen sobre representar casos confirmados y los datos operativos pueden ocultar condiciones no detectadas. Una cifra de un proveedor no debe trasladarse sin examinar población, definición de positivo y criterio de referencia.
Confianza calibrada, no números ornamentales
Confianza es la fuerza justificada con que sostenemos una conclusión dadas las observaciones, el método, la cobertura, las alternativas y las incertidumbres. No es entusiasmo del analista ni un porcentaje que se añade para dar apariencia de precisión. Una confianza verbal útil necesita una regla local y razones auditables.
En un informe puede distinguirse entre:
- respaldado fuertemente bajo estas condiciones: controles, cobertura y fuentes independientes son adecuados, y las alternativas principales pierden compatibilidad;
- respaldado moderadamente: el resultado es consistente con la hipótesis, pero queda una limitación relevante o una alternativa plausible;
- compatible: no hay contradicción decisiva, pero la evidencia tiene poco poder discriminante;
- no determinado: falta cobertura, referencia, salud del instrumento o información crítica;
- refutado bajo estas condiciones: una predicción necesaria no se cumple en una prueba cuya capacidad de observación fue validada.
«No observado» describe un dato. «No detectado» describe una salida. «Ausente bajo el procedimiento validado» es una conclusión más fuerte y acotada. «No existe» es, en general, una afirmación universal que exige un argumento de cobertura y un dominio muy particular. «Cero hallazgos críticos» no debe traducirse en «riesgo cero», porque la clasificación, el alcance y el umbral son parte de la evaluación.
El lenguaje también debe separar incertidumbre y decisión. Puede haber evidencia insuficiente para afirmar compromiso y, aun así, suficiente para rotar una credencial, preservar logs o pausar una integración. Una acción precautoria no convierte la hipótesis en hecho; reconoce que el coste de esperar puede ser mayor que el de una medida reversible.
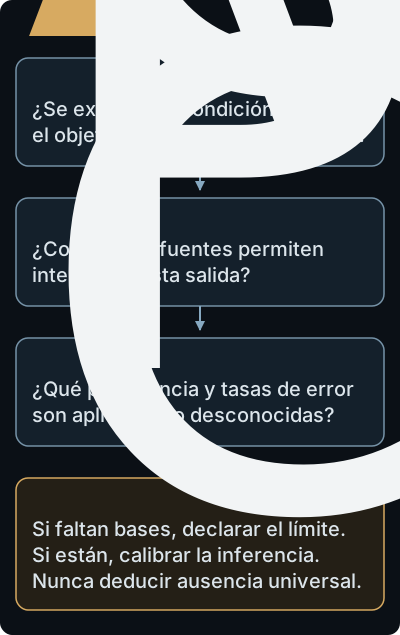
Un “no” no obliga siempre a repetir la misma prueba: puede exigir reparar el instrumento, ampliar alcance, obtener una referencia mejor o tomar una medida precautoria.
Qué autoriza realmente un negativo
Un resultado negativo puede autorizar varias conclusiones limitadas:
- que el método no produjo una salida positiva en los objetos y período consultados;
- que, si el control positivo funcionó y la cobertura fue verificada, la condición buscada no fue observada bajo esas condiciones;
- que ciertas hipótesis pierden apoyo, en la medida en que predecían una señal necesaria y el instrumento podía verla;
- que una decisión concreta —por ejemplo, continuar una prueba no intrusiva o cerrar una tarea de una clase definida— es razonable según el umbral de riesgo acordado.
No autoriza por sí solo:
- declarar ausentes todas las vulnerabilidades o intrusiones;
- extender el resultado a una versión, entorno o ruta no examinados;
- inferir que un control operativo es eficaz sólo porque no hubo alertas;
- borrar evidencia, cerrar un incidente o atribuir el silencio a un actor;
- convertir una clasificación «sin críticos» en una garantía de seguridad universal.
La diferencia entre evidencia y decisión importa. NIST SP 800-53A indica que los hallazgos de una evaluación ayudan a una decisión informada y basada en riesgo, no que una salida particular dicte una decisión universal. El responsable puede aceptar riesgo residual, pedir otra prueba, ampliar alcance o aplicar una mitigación. La evidencia limita qué puede decirse; el contexto decide qué hacer.
Resolver el caso conductor
Volvamos a la API. El escáner cubrió la versión 4.8 y las rutas autenticadas documentadas, pero no el flujo de recuperación de cuenta ni una ruta de administración recién desplegada. El test positivo de autorización falló porque no generó la respuesta esperada en el pipeline de observación. Durante cuatro horas, el proxy perdió 40 minutos de logs. El control negativo no activó la regla, pero sólo probó una cuenta y una red.
El resultado correcto no es «la API está limpia». Tampoco es «la API está comprometida». El expediente permite decir: «El procedimiento no identificó hallazgos críticos en las rutas y condiciones que alcanzó. No permite evaluar la ruta de administración ni recuperación de cuenta. El control positivo no demostró la capacidad de observación del pipeline, y existe un intervalo sin logs; por tanto, la ausencia de alertas no reduce de forma fuerte la hipótesis de actividad anómala durante ese período».
¿Qué acción sigue? Recuperar o marcar como perdido el intervalo del proxy, reparar el control positivo, ampliar el alcance a los flujos omitidos y preservar los datos ya disponibles. Si la decisión inmediata es mantener el servicio, se puede aplicar una mitigación temporal —por ejemplo, limitar el privilegio de la ruta nueva— con una justificación de riesgo. La acción no prueba que hubiera ataque; gestiona una incertidumbre que tiene consecuencias.
Si el positivo funcionara, la cobertura coincidiera con la pregunta, los logs estuvieran completos y el período fuera pertinente, el negativo ganaría fuerza: «No se observó el comportamiento definido en las fuentes y condiciones validadas». Aun así, no convertiría el resultado en una garantía para otras clases de abuso o para el futuro despliegue.
Errores frecuentes al hablar de silencio
«El escáner no lo reportó, así que no existe». Confunde salida con estado y olvida clases fuera de alcance.
«Dos herramientas coincidieron». Si comparten parser, fuente, firma o dataset, la coincidencia no es independencia.
«Nunca hubo una alerta». Puede indicar ausencia, ceguera, retención insuficiente, consulta defectuosa o una condición que no genera esa señal.
«El control positivo es artificial». Precisamente porque su estado es conocido permite saber si el instrumento podía hablar; debe diseñarse para no alterar la operación y representar la ruta real.
«Una confianza del 95 % lo resuelve». El número carece de interpretación si no se declara población, modelo, método y cobertura. NIST TN 1297 pide documentar cómo se evaluaron los componentes de incertidumbre y por qué una afirmación de intervalo tiene la interpretación que se le atribuye. NIST TN 1297, §7
«Si hay incertidumbre, no se puede decidir». La incertidumbre se gestiona: se reduce, se acota, se acepta o se mitiga. No desaparece por fingir certeza ni bloquea toda acción.
Síntesis
Un resultado negativo es una observación sobre un método que no emitió una señal. Su fuerza depende de la pregunta, la definición de la condición, la cobertura, la sensibilidad, la salud de la cadena de observación, la referencia de verdad y la tasa base de la población. Los controles positivos y negativos hacen visible parte de esa capacidad; no convierten una prueba local en garantía universal.
La incertidumbre epistémica pide conocimiento adicional. La aleatoria pide caracterización de la variación. Ambas deben declararse sin usar etiquetas matemáticas como ornamento. La confianza se calibra con razones y alcance. El resultado negativo puede reducir apoyo a una hipótesis o autorizar una decisión concreta, pero sólo dentro de condiciones explicitadas.
La disciplina completa la progresión de los capítulos anteriores: un claim tiene alcance; un riesgo depende de escenario y consecuencias; una investigación necesita autorización; una conclusión separa observación e inferencia; la evidencia conserva procedencia; y ahora el silencio del instrumento se interpreta según lo que realmente podía detectar. La pregunta profesional no es «¿dio limpio?», sino «¿qué afirmación concreta quedó menos probable, bajo qué condiciones, y qué decisión permite tomar?»
Comprobación de comprensión
- ¿Por qué «el escáner no encontró vulnerabilidades» no equivale a «no hay vulnerabilidades»?
- Distingue incertidumbre epistémica de aleatoria con un ejemplo de seguridad.
- ¿Qué diferencia hay entre un resultado negativo y un verdadero negativo?
- ¿Qué debe probar un control positivo antes de usar un silencio como evidencia?
- ¿Por qué una cobertura del cien por ciento puede ser insuficiente?
- ¿Cómo cambia la interpretación de un positivo cuando la condición es muy rara?
- ¿Qué significa «refutado bajo estas condiciones» y por qué no equivale a «imposible»?
- ¿Qué decisión puede ser razonable aunque la evidencia no determine si ocurrió un compromiso?
Problema de transferencia
Un proveedor afirma: «La revisión anual produjo cero hallazgos críticos y el servicio nunca generó una alerta de exfiltración». El expediente muestra que se revisaron las versiones desplegadas en marzo, que el control positivo de exfiltración sólo se ejecutó contra un tenant de laboratorio, que un colector tuvo una interrupción de seis horas y que el proveedor no conserva los casos descartados por el umbral de severidad.
Redacta una conclusión profesional de cuatro o cinco frases. Después, enumera: (a) dos afirmaciones que el resultado sí autoriza; (b) tres que no autoriza; (c) un control positivo y uno negativo para el detector; y (d) la evidencia mínima que pedirías antes de cerrar el riesgo de exfiltración. Explica qué parte de tu incertidumbre es epistémica, qué variación aleatoria podría importar y qué acción reversible tomarías si el coste de esperar fuera alto.
Fuentes principales
- Ron Ross et al. NIST SP 800-30 Rev. 1: Guide for Conducting Risk Assessments.
- Joint Task Force. NIST SP 800-53A Rev. 5: Assessing Security and Privacy Controls.
- Karen Scarfone et al. NIST SP 800-115: Technical Guide to Information Security Testing and Assessment.
- NIST SAMATE. SP 500-268: Source Code Security Analysis Tool Functional Specifications.
- Barry N. Taylor y Chris E. Kuyatt. NIST Technical Note 1297: Guidelines for Evaluating and Expressing the Uncertainty of NIST Measurement Results.
- NIST. SP 800-94: Guide to Intrusion Detection and Prevention Systems (referencia histórica; su revisión no se convirtió en publicación final).
- Godil et al. NISTIR 7972: Performance Metrics for Evaluating Object and Human Detection and Tracking Systems, julio de 2014, §§3.2.3–3.2.8. Se usan las definiciones de métricas, no una estimación de rendimiento en ciberseguridad.