Dos archivos producen el mismo digest. ¿Son el mismo archivo? Bajo un hash criptográfico vigente, la respuesta práctica suele ser «con confianza suficiente», no «por definición». Un digest es más corto que cualquier mensaje posible; las colisiones deben existir. La seguridad consiste en que encontrar una relevante sea computacionalmente inviable bajo una propiedad y un adversario concretos.
La segunda pregunta es más importante: ¿de dónde salió el digest que se considera correcto? Si un atacante sustituye update.bin y también el SHA256SUMS descargado del mismo servidor comprometido, la comparación funciona y no protege nada. El hash detecta una diferencia respecto de una referencia; no crea por sí solo confianza en esa referencia.
Una función determinista que comprime un espacio enorme
Una función hash criptográfica recibe una cadena de bits de longitud dentro de su dominio y devuelve un digest de longitud fija. FIPS 180-4 especifica la familia SHA-2; FIPS 202 especifica SHA3-224, SHA3-256, SHA3-384, SHA3-512 y las funciones de salida extensible SHAKE128/SHAKE256.
El cálculo es determinista: los mismos bytes bajo el mismo algoritmo producen el mismo digest. Cambiar un byte suele alterar muchos bits de salida, pero observar un «efecto avalancha» no demuestra las propiedades criptográficas. Un algoritmo roto puede verse caótico.
Que la salida sea fija implica compresión. Hay infinitos mensajes posibles o un dominio mucho mayor que los (2^n) digests de (n) bits. Por el principio del palomar, múltiples mensajes comparten digest. No se exige ausencia de colisiones, sino resistencia a encontrarlas bajo juegos concretos.
Tres juegos que no deben confundirse
Vista adaptada. Toca el diagrama para ampliarlo.
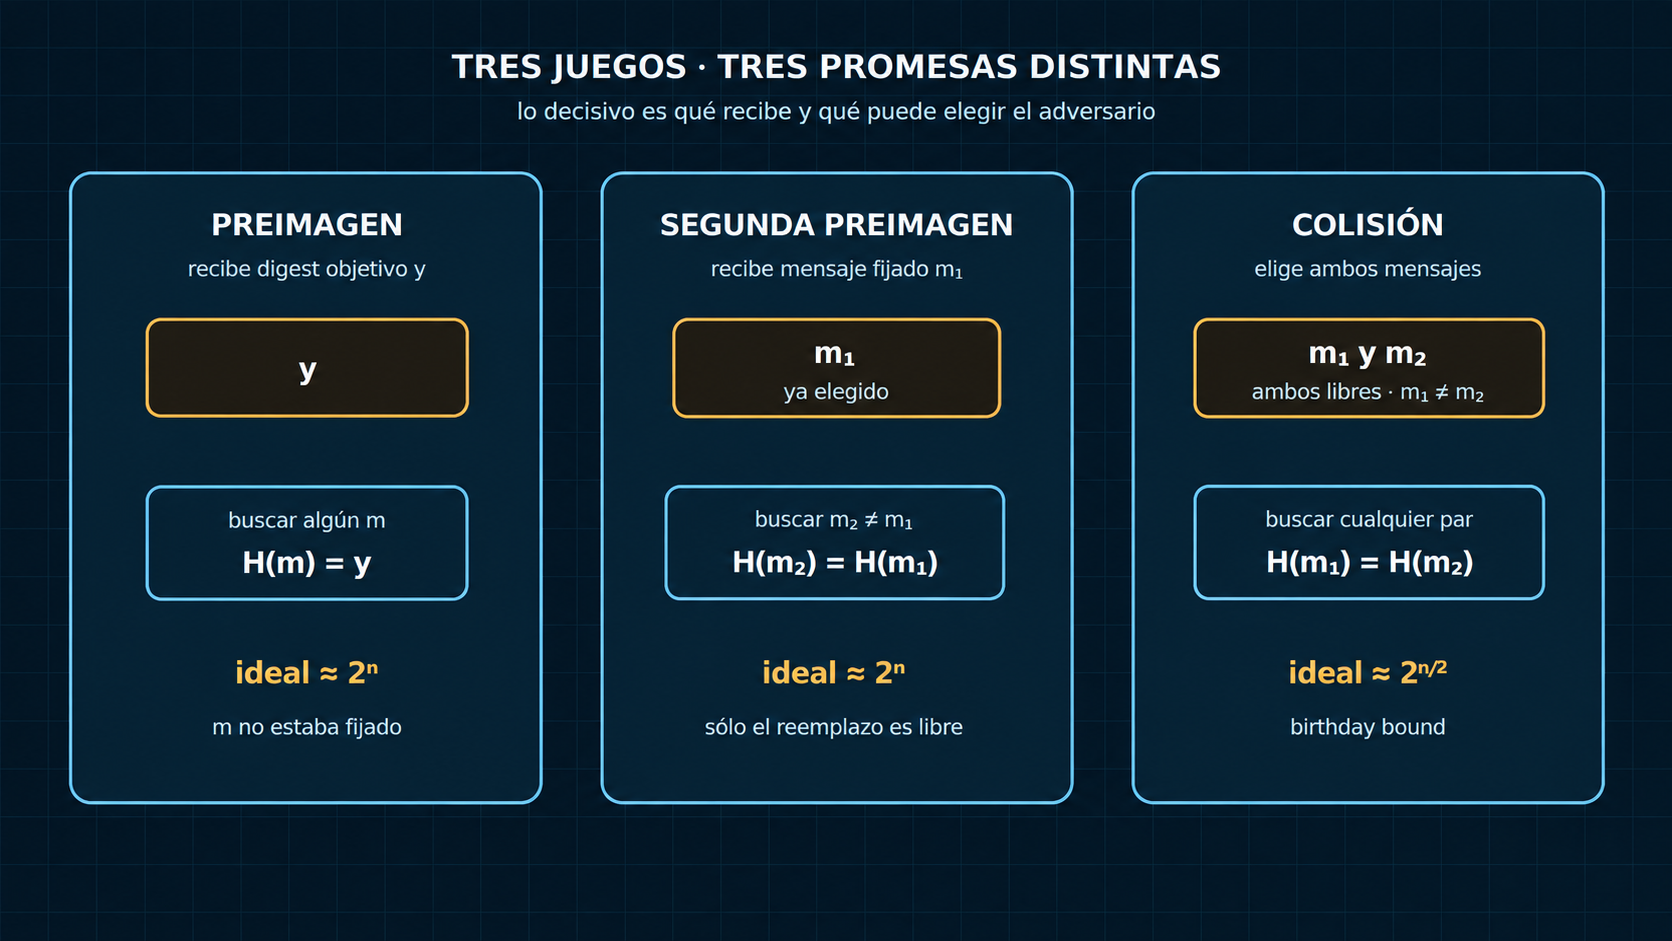
Resistencia a preimagen
Dado un digest objetivo (y), el adversario intenta encontrar algún mensaje (m) tal que (H(m)=y). Para una salida ideal de (n) bits, el trabajo genérico esperado está en el orden de (2^n). Esta propiedad importa cuando el digest oculta o representa un valor que el atacante intenta recuperar.
No salva entradas de baja entropía. Si m es un PIN de seis dígitos, el adversario enumera un millón de candidatos y compara. El espacio de entrada domina; por eso una contraseña no se almacena con un hash rápido genérico.
Resistencia a segunda preimagen
Dado un mensaje específico (m_1), el adversario busca otro (m_2 \ne m_1) con el mismo digest. No elige libremente ambos. En el modelo ideal también se espera una dificultad cercana a (2^n), aunque estructuras y longitudes concretas pueden cambiar análisis detallados.
Esta propiedad se aproxima a la pregunta «¿puede reemplazarse este documento ya fijado por otro con el mismo digest?». No es idéntica a resistencia a colisión.
Resistencia a colisión
El adversario elige ambos mensajes y busca cualquier par distinto con igual digest. El birthday bound reduce el costo genérico ideal a aproximadamente (2^{n/2}). Un digest de 256 bits no ofrece 256 bits de resistencia a colisión; idealmente ofrece alrededor de 128.
La distinción es operacional. Un protocolo que deja al atacante preparar dos contratos —uno benigno y otro malicioso— puede depender de colisión. Verificar un artefacto previamente fijado se parece a segunda preimagen. Recuperar una entrada desde el digest se parece a preimagen.
Las propiedades no se heredan automáticamente entre variantes ni truncamientos. Reducir un digest a 64 bits reduce su espacio a (2^{64}) y su barrera genérica de colisión a aproximadamente (2^{32}), alcanzable en muchos contextos. El volumen y la capacidad multi-target también importan.
Un digest no es autenticidad
FIPS 180-4 dice que los digests pueden usarse para detectar si mensajes cambiaron desde que se generaron. Falta una condición: el verificador necesita una referencia confiable y una definición exacta de los bytes.
Vista adaptada. Toca el diagrama para ampliarlo.
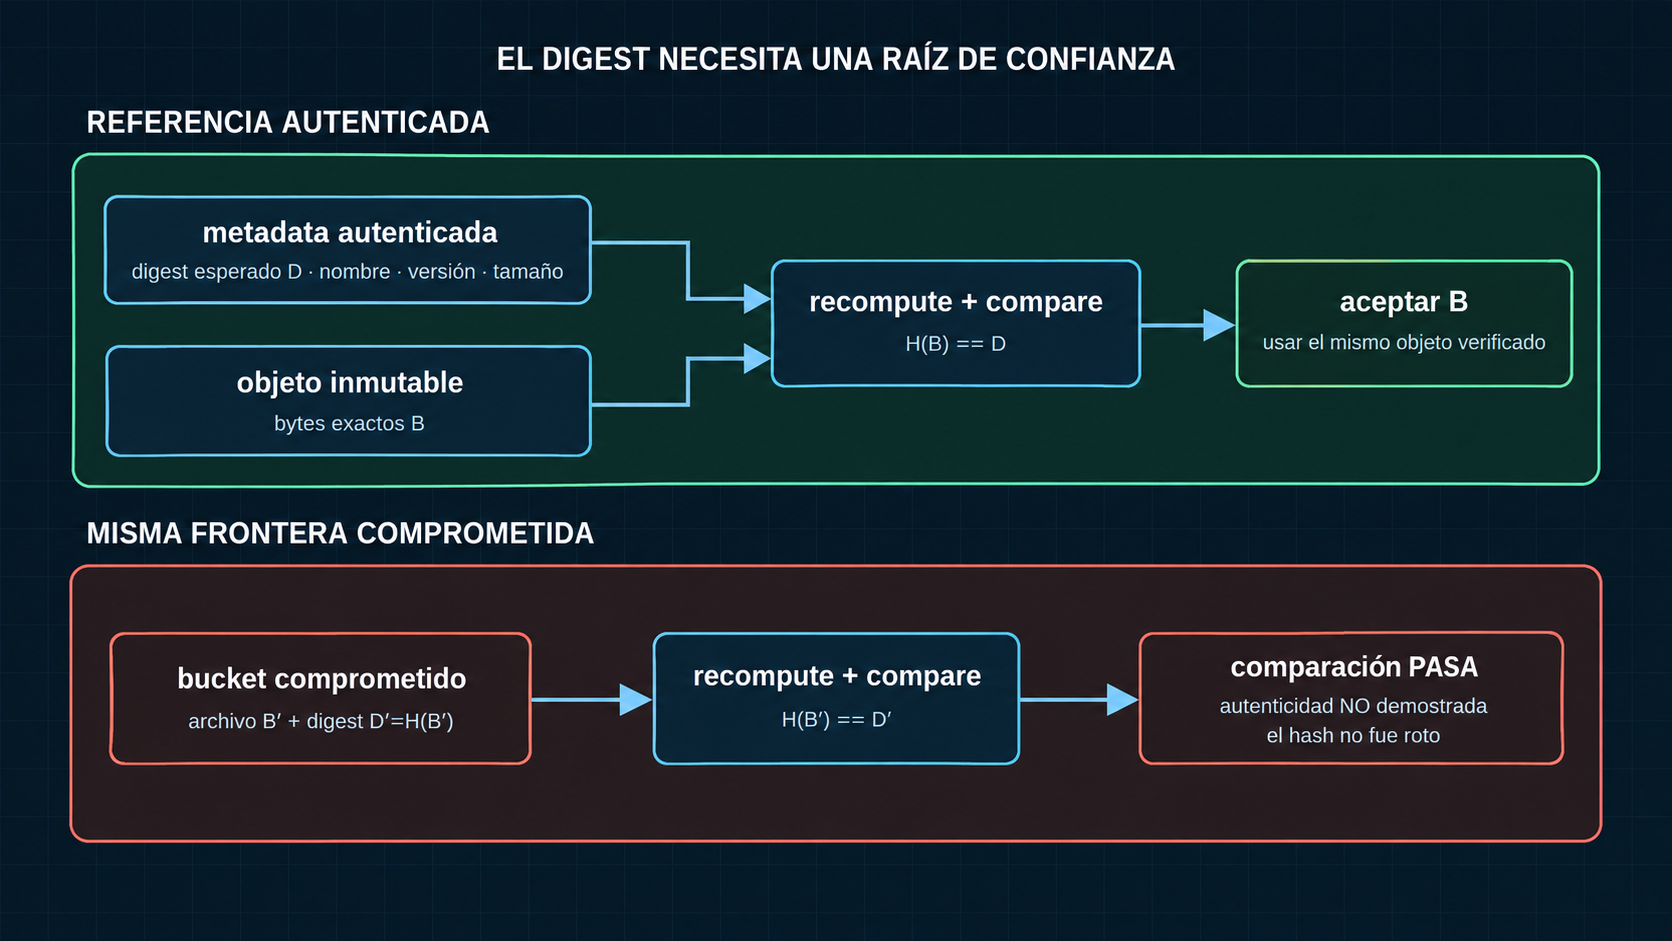
Un checksum no criptográfico, como CRC, detecta errores accidentales y es excelente para su propósito. No está diseñado para resistir a quien puede elegir modificaciones. Un hash criptográfico dificulta construir cambios con el mismo digest, pero sigue siendo público: cualquiera puede calcular el digest de su propio archivo malicioso.
La referencia puede adquirir confianza mediante:
- un canal independiente previamente autenticado;
- metadata firmada que liga nombre, versión, tamaño y digest;
- un log verificable cuyo root está autenticado y observado;
- una imagen inmutable identificada por digest dentro de una política de despliegue;
- una medición anclada en hardware y ligada a una identidad de plataforma.
Cada opción desplaza, no elimina, la raíz de confianza. HTTPS desde el mismo origen protege el tránsito frente a terceros, pero si el origen está comprometido entrega archivo y digest coherentemente maliciosos. Una firma ayuda sólo si la clave, identidad, scope y política de verificación son correctos; se desarrolla en el capítulo 67.
El digest tampoco aporta frescura. Un atacante puede servir una versión antigua y su digest auténtico. La metadata necesita versión, expiración, contador o política de rollback. Integridad de bytes no es actualidad, autorización, procedencia ni ausencia de vulnerabilidades.
Los bytes exactos forman parte del contrato
H(documento) es ambiguo si «documento» no define representación. JSON permite variaciones de espacios, orden de miembros y representaciones numéricas. Unicode ofrece secuencias distintas que pueden verse iguales. Un archivo de texto puede usar LF o CRLF. Descomprimir, normalizar o transcodificar cambia bytes.
Hay dos estrategias válidas:
- Hash de bytes transportados. El digest cubre exactamente el artefacto recibido. Es simple y adecuado para descarga, almacenamiento y content addressing.
- Hash de representación canónica. El sistema parsea, valida y serializa según una canonicalización especificada, y hashea esos bytes. Permite equivalencia semántica definida, pero aumenta superficie de parsers y divergencias.
No debe improvisarse una canonicalización con «quitar espacios» u ordenar objetos según una biblioteca particular. Dos implementaciones podrían firmar o verificar objetos distintos. Si se necesita semántica, el formato canónico, versión, tipos, límites y manejo de duplicados deben ser parte del protocolo.
La concatenación también puede ser ambigua. H("ab" || "c") y H("a" || "bc") reciben los mismos bytes. Para hashear una tupla se usan longitudes, tipos o una codificación inyectiva. SP 800-185 define TupleHash precisamente para hashear secuencias de strings sin esta ambigüedad.
Separación de dominios
Una misma función puede aparecer en múltiples roles: hojas y nodos de árbol, artefactos y manifests, desafíos y transcripts. Si todos aceptan el mismo espacio de bytes, un valor válido en un rol podría reinterpretarse en otro.
La separación de dominios antepone etiquetas inequívocas o usa funciones personalizables para crear espacios lógicos distintos. No basta una palabra sin framing. Una forma conceptual es:
H(encode("artifact-v1", length(name), name, length(bytes), bytes))
RFC 9162 usa 0x00 antes de una hoja y 0x01 antes de un nodo interno en su Merkle Tree Hash. La diferencia no es estética: impide confundir la representación de una hoja con la de un nodo y es requerida para la resistencia a segunda preimagen del árbol.
SP 800-185 ofrece cSHAKE con customization string y TupleHash para tuplas. Estas herramientas no autorizan inventar protocolos ad hoc; muestran que nombre de función, contexto, estructura y longitud son inputs de seguridad.
Length extension y construcciones improvisadas
SHA-256 y otros hashes Merkle–Damgård exponen un digest que corresponde a un estado encadenado. Conocer H(m) y la longitud de m puede permitir calcular el hash de una extensión con padding apropiado sin conocer m. Esto se conoce como length extension.
La consecuencia pedagógica no es «SHA-256 está roto». La resistencia a preimagen y colisión puede seguir intacta. El error es esperar de un hash sin clave o de una composición improvisada una propiedad que no prometía.
En particular, H(secret || message) no debe inventarse como MAC. Además de problemas de construcción, gestionar framing, keys y comparación tiene requisitos propios. El capítulo 64 presenta HMAC y MACs definidos. Del mismo modo, H(password || salt) no sustituye un password hashing memory-hard, y H(randomness) no crea entropía ausente.
SHA-3 usa una construcción sponge y no comparte el mismo length-extension behavior de SHA-2, pero eso no convierte cualquier concatenación con SHA-3 en un protocolo seguro. La construcción completa sigue necesitando una definición y análisis.
Compromisos: fijar ahora, revelar después
Un esquema de compromiso permite publicar un valor C que fija un mensaje sin revelarlo todavía. Más tarde se publica el mensaje y un opening; cualquiera comprueba que corresponden.
Vista adaptada. Toca el diagrama para ampliarlo.
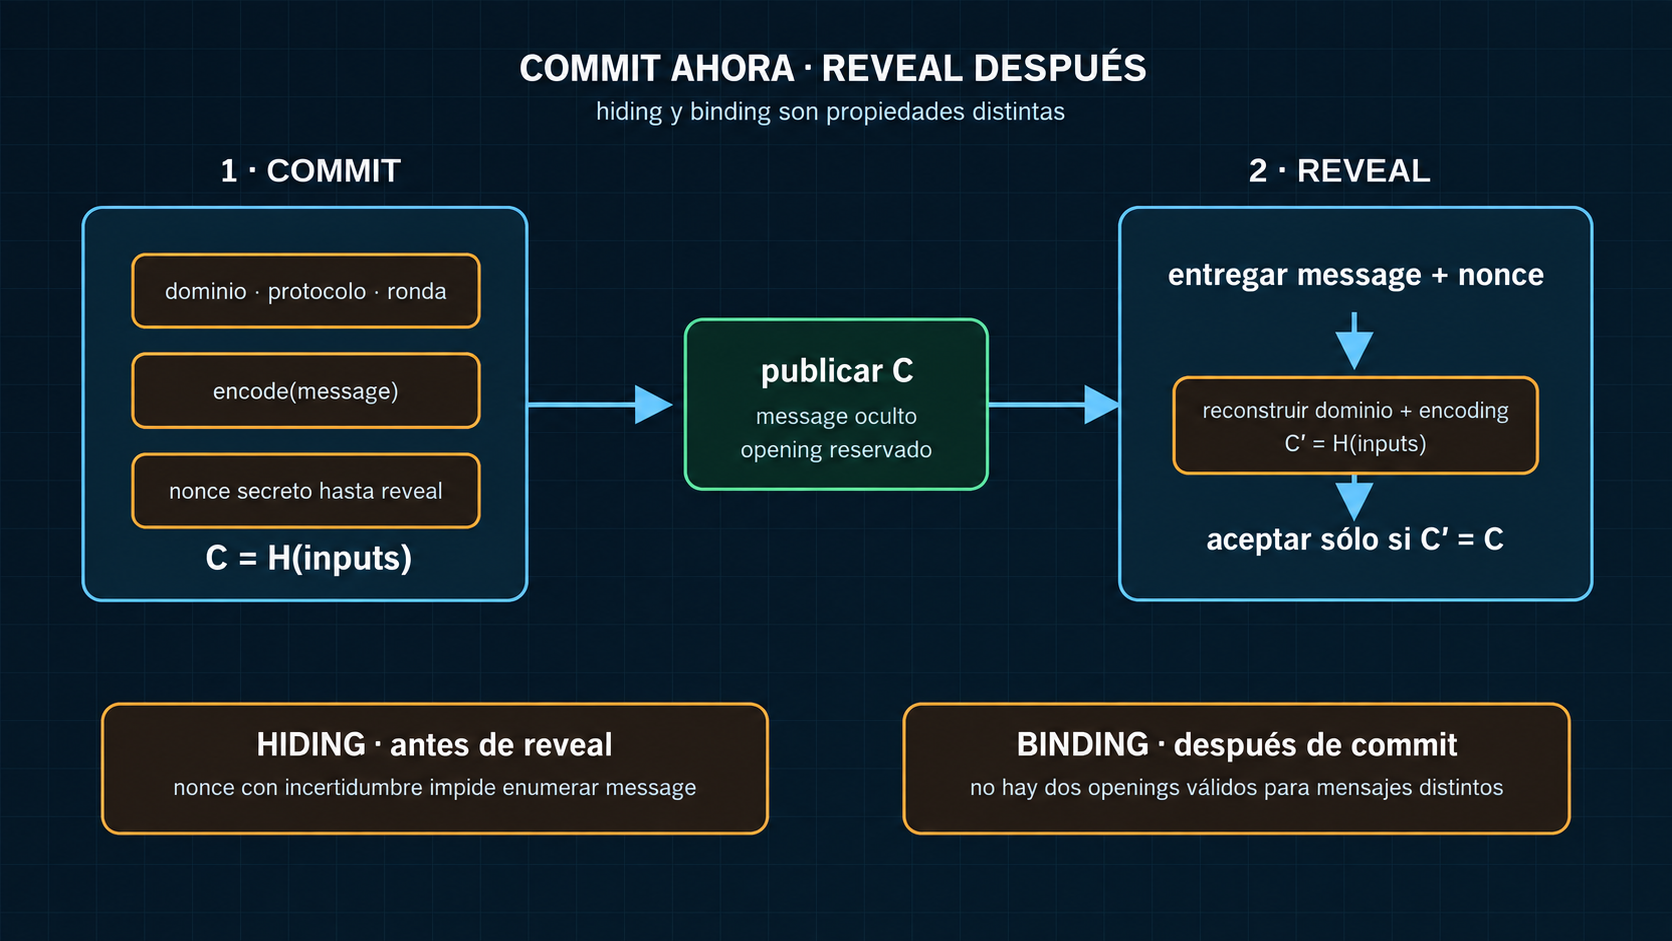
Una construcción pedagógica es:
C = H(domain || encode(message) || nonce)
En la fase commit, se publica C y se conserva message, nonce. En la fase reveal, se entregan ambos; el verificador reconstruye exactamente los bytes y compara.
Se buscan dos propiedades:
- Hiding: antes de reveal,
Cno debería revelar el mensaje. - Binding: después de publicar
C, el committer no debería poder abrirlo como dos mensajes distintos.
El hash por sí solo no asegura hiding. Si el mensaje es «sí» o «no» y no hay nonce secreto con suficiente incertidumbre, cualquiera calcula ambos digests. El nonce —a menudo llamado blinding value— amplía el espacio que debe explorar el observador. No es el mismo contrato que un salt público de contraseñas ni que un nonce AEAD.
Binding depende de resistencia a colisión o segunda preimagen según el modelo, de que el committer no pueda escoger representaciones ambiguas y de que el dominio incluya protocolo, ronda, identidad o contexto necesarios. Si encode acepta dos parseos, la misma cadena podría «abrirse» semánticamente de dos maneras sin romper el hash.
Un commit tampoco prueba que el mensaje sea verdadero, que existiera antes de cierta hora o que lo eligiera una persona específica. Publicarlo en un medio autenticado con timestamp puede aportar evidencia temporal; ese medio y su reloj son supuestos adicionales.
Los compromisos algebraicos, como Pedersen, tienen propiedades y supuestos distintos —por ejemplo hiding perfecto y binding computacional bajo un problema de grupo—. No son intercambiables con hash(message || nonce). Este capítulo usa el compromiso hash para aprender el contrato, no para declarar una construcción universal.
Content addressing: identidad por bytes
En content addressing, el identificador de un objeto deriva de su contenido. Al recuperar bytes, el consumidor recalcula el digest y rechaza si no coincide. Esto desacopla ubicación de identidad y hace visibles cambios accidentales o maliciosos respecto del identificador esperado.
No responde quién publicó el objeto ni si debe ejecutarse. Un malware también tiene un digest estable. Un digest fijado en un lockfile sólo hereda la confianza y protección del lockfile. Si el mismo actor comprometido cambia objeto y referencia, la verificación sigue pasando.
Se debe declarar algoritmo y longitud. Un identificador que sólo guarda hex sin algorithm tag crea deuda de migración. Multihash y formatos versionados ilustran una idea útil: el identificador incluye cómo interpretarse. Esto no resuelve por sí solo downgrade; la política decide algoritmos aceptables.
La deduplicación por digest asume que colisiones son despreciables dentro del modelo. Sistemas de alto impacto pueden comparar longitud y bytes al detectar un digest ya presente, separar namespaces y conservar evidencia de origen. No se usa MD5 sólo porque «las colisiones no ocurrirán por accidente» cuando un atacante puede elegir entradas.
Árboles de Merkle: muchos objetos bajo una raíz
Un Merkle tree combina hashes de hojas hasta obtener una raíz. Una prueba de inclusión aporta los nodos hermanos necesarios para recomputar esa root sin descargar todo el conjunto. Su tamaño crece logarítmicamente.
La prueba demuestra que una hoja está incluida en esa raíz y ese tamaño de árbol, si el algoritmo, framing y orden son correctos. No demuestra que la raíz sea legítima. El verificador necesita un signed tree head, checkpoint o canal confiable. Tampoco demuestra que el log muestre la misma vista a todos; hacen falta gossip, monitores o mecanismos de consistencia.
RFC 9162 distingue:
- prueba de inclusión: una hoja pertenece al árbol comprometido;
- prueba de consistencia: un árbol posterior extiende uno anterior sin cambiar su prefijo;
- firma del tree head: autentica root, tamaño, timestamp y parámetros según el protocolo.
Ninguna prueba afirma que el certificado de una hoja sea verdadero o benigno. Certificate Transparency vuelve observables emisiones y facilita auditoría; no reemplaza validación PKI ni revocación.
Un árbol construido sin separación hoja/nodo puede permitir interpretaciones estructurales peligrosas. Además, el orden y el número de hojas forman parte del compromiso. Una «lista» tratada como set, o viceversa, cambia la propiedad.
Integridad en almacenamiento y en ejecución
Verificar al descargar no garantiza los bytes usados después. Entre check y use, otro proceso puede reemplazar el archivo: un TOCTOU. El verificador debe operar sobre el mismo handle, descriptor o objeto inmutable que luego consume, o moverlo atómicamente desde cuarentena a un store content-addressed.
El orden seguro suele ser:
- recibir en un área no ejecutable;
- imponer límites de tamaño y parseo mínimo;
- calcular digest mientras se lee el objeto que se conservará;
- verificar metadata autenticada, nombre, versión, tamaño y digest;
- promover atómicamente el mismo objeto;
- ejecutar o distribuir por su identidad verificada;
- registrar evidencia sin copiar secretos ni contenido sensible.
Verificar un directorio archivo por archivo no cubre ausencias, extras, paths, symlinks o permisos. Un manifest autenticado debe comprometer el conjunto y sus metadatos relevantes con encoding inequívoco. La ausencia también puede ser un hecho de seguridad.
Para memoria o boot, la raíz de confianza puede medir cada etapa antes de pasar control. Un measurement log es evidencia; una política decide valores permitidos. Igualdad con una medición conocida no prueba que el software carezca de vulnerabilidades.
Algoritmos, truncamiento y transición
NIST planea retirar SHA-1 de todos los usos de protección criptográfica para el 31 de diciembre de 2030 y conservar su especificación para procesar información histórica. FIPS 180-4 sigue siendo final, pero NIST decidió revisarlo y retirar SHA-1 de la siguiente versión. FIPS 202 también está planificado para actualización; eso no lo vuelve inválido hoy.
Una política no debería decir sólo «SHA». Debe fijar algoritmo, output length, uso, fecha y strength requerido. SHA-512/256 no significa truncar arbitrariamente SHA-512 en cualquier implementación; es una función especificada con IV propio. SHAKE exige elegir longitud de salida y esa longitud forma parte del contrato.
Cuando se trunca un digest, el protocolo contabiliza seguridad de preimagen y colisión del valor truncado, número de objetos y ataques multi-target. Truncar por comodidad de UI y reutilizar como identidad de seguridad puede convertir un espacio amplio en uno enumerable.
La migración necesita algorithm agility sin ambigüedad:
- identificadores versionados con algorithm tag y longitud;
- verificador que rechaza algoritmos no permitidos, no que acepta cualquiera anunciado;
- periodo de doble publicación cuidadosamente ligado al mismo objeto;
- rehash desde bytes confiables, no desde un digest viejo;
- inventario de referencias, caches, APIs y bases que asumen longitud fija;
- retiro medible de generación y, si hace falta, lectura histórica acotada.
Aceptar alg=md5 porque el objeto lo declara convierte agilidad en downgrade. La selección pertenece a política local.
Caso trabajado: actualización con digest correcto
Una aplicación descarga agent-4.2.bin y agent-4.2.bin.sha256 desde el mismo bucket. Recalcula y coincide. El equipo concluye que el binario es auténtico.
El adversario comprometió la credencial de escritura del bucket. Subió un binario modificado y su nuevo digest. No necesitó romper SHA-256. La comprobación sólo descartó corrupción entre el bucket y el host.
La remediación define metadata versionada con nombre, tamaño, plataforma, versión, digest y expiración; la firma una clave de release fuera del bucket. El cliente fija la raíz pública por un canal de actualización separado, aplica umbrales y rollback protection, descarga a cuarentena, verifica metadata antes de promover el mismo inode y registra versión/digest aceptados.
Luego aparece un mirror comprometido. Puede retener o servir una versión anterior cuya firma era válida. La expiración y el contador de versión permiten rechazar rollback, pero introducen reloj y estado persistente. Si el host restaura un snapshot anterior, ese estado también puede retroceder; la política de actualización necesita tratar restore.
Finalmente, un parser acepta dos entradas de manifest con el mismo nombre y distintas capitalizaciones. La firma cubre bytes, pero cliente y servidor eligen entradas diferentes. Se exige una única canonicalización, rechazo de duplicados y binding entre target y metadata. La criptografía conservó bytes; la semántica ambigua rompía la decisión.
Método de revisión
Ante cualquier uso de hash, completa:
- Objeto: ¿qué bytes exactos se hashean y en qué momento?
- Propiedad: ¿preimagen, segunda preimagen, colisión, fingerprint, compromiso o indexación?
- Adversario: ¿elige el target, uno o ambos mensajes, muchos targets o sólo causa errores?
- Referencia: ¿quién autentica el digest esperado y por qué canal?
- Contexto: ¿versión, tipo, identidad, algoritmo, longitud y dominio están ligados?
- Encoding: ¿la representación es inequívoca y rechaza duplicados?
- Volumen: ¿qué efecto tienen birthday bound, truncamiento y multi-target?
- Frescura: ¿cómo se impide rollback de objeto y metadata?
- Uso: ¿se consumen los mismos bytes verificados o existe TOCTOU?
- Composición: ¿se está reinventando un MAC, password hash o KDF?
- Transición: ¿cómo se versiona y retira el algoritmo sin downgrade?
- Evidencia: ¿qué test negativo demuestra sustitución, ambigüedad y rechazo?
Si no se puede explicar la procedencia del digest, la frase «verificamos SHA-256» es incompleta.
Transferencia al capítulo 64
Este capítulo mostró por qué un digest público no autentica al emisor. El capítulo 64 añadirá una clave mediante MACs: definirá autenticidad bajo clave compartida, HMAC, tags truncados, verificación constante, separación de keys y límites frente a replay y no repudio.
Síntesis
Un hash comprime mensajes a digests fijos y se analiza mediante juegos distintos. Preimagen, segunda preimagen y colisión no son nombres intercambiables; para una salida ideal de (n) bits, la colisión genérica aparece alrededor de (2^{n/2}), mientras preimagen apunta a (2^n). El ancho nominal no corrige entradas enumerables ni truncamientos.
Un digest detecta cambios sólo respecto de una referencia confiable. Si el atacante sustituye objeto y digest, no rompe la función. La integridad completa liga bytes, algoritmo, longitud, identidad, versión y frescura, y garantiza que los bytes verificados sean los usados.
Los compromisos separan commit y reveal y requieren hiding y binding; el nonce, framing y dominio son parte del contrato. Los Merkle trees permiten pruebas compactas de inclusión y consistencia respecto de una root, pero esa root aún necesita autenticación y observación.
Hash no es MAC, firma, password hashing, KDF ni fuente de entropía. Las construcciones definidas y las fronteras de confianza importan tanto como el algoritmo.
Fuentes primarias y documentación técnica
- NIST, FIPS 180-4 — Secure Hash Standard; CSRC, actualización 2015, con decisión de revisión de 2023.
- NIST, FIPS 202 — SHA-3 Standard; CSRC, 2015, con decisión de actualización de 2025.
- NIST, SP 800-185 — SHA-3 Derived Functions; CSRC, 2016, con decisión de revisión de 2025.
- NIST, SP 800-107 Rev. 1 — Recommendation for Applications Using Approved Hash Algorithms; CSRC, 2012, con retirada planificada tras migrar requisitos.
- NIST, Transitioning Away from SHA-1 for All Applications; CSRC, 2022.
- IETF, RFC 6920 — Naming Things with Hashes; RFC Editor, 2013.
- IETF, RFC 9162 — Certificate Transparency Version 2.0, especialmente §2.1; RFC Editor, 2021.