Una pantalla roja, una respuesta lenta o una reserva duplicada son observaciones importantes, pero todavía no son explicaciones. Pueden proceder de un defecto de diseño, de un estado que el servicio no debía alcanzar, de una dependencia caída, de un uso fuera de límites o de una acción deliberada. Incluso pueden coincidir dos causas. El trabajo profesional empieza antes de elegir una etiqueta: reconstruye qué debía hacer el servicio, qué hizo, en qué composición y durante qué ventana.
Este capítulo parte del modelo de 0.10. Allí una ejecución era una composición situada de artefacto, configuración efectiva, datos y estado, plataforma, dependencias y contexto. Aquí añadimos un vocabulario para comparar esa composición con un servicio esperado. Las palabras tienen historia en varias comunidades y no todos los glosarios trazan exactamente las mismas fronteras; las definiciones que siguen son un modelo de trabajo explícito para razonar con cuidado, no una ley universal.
Primero: ¿qué servicio se esperaba?
Un servicio esperado es una propiedad observable que una persona, contrato, diseño o política atribuye a una operación bajo condiciones declaradas. No significa que todo sistema deba ser perfecto ni que una expectativa informal tenga automáticamente fuerza contractual. Debemos poder responder: ¿qué operación?, ¿para qué actor?, ¿con qué entradas y estado?, ¿qué resultado o límite se había prometido?, ¿en qué intervalo?
Supongamos una taquilla digital. Bajo una sesión autenticada y una plaza disponible, el servicio esperado es que una solicitud válida reserve como máximo una plaza, confirme el resultado y conserve la reserva. “Como máximo una” es una propiedad de exclusión; “confirme” es una propiedad de comunicación; “conserve” es una propiedad de estado. Si no separamos estas propiedades, “la taquilla falló” oculta tres preguntas distintas.
La expectativa también tiene condiciones. Si el contrato sólo admite una solicitud por segundo, una ráfaga puede quedar fuera del servicio esperado. Eso no decide todavía si la respuesta debe ser rechazo limpio, espera o degradación; sí evita llamar fallo a cualquier resultado que no sea una reserva. La condición debe estar escrita o ser reconstruible, no inventada después de ver el resultado.
De la observación a la discrepancia
Una observación es lo que se midió o reconstruyó: dos confirmaciones con el mismo identificador de plaza, un código de respuesta, una cola que creció, un registro ausente, o la respuesta que devolvió una dependencia. La observación no es todavía una causa. NIST SP 800-61 separa evento e incidente precisamente porque una señal puede requerir clasificación adicional antes de atribuir impacto de seguridad.
Para distinguir mecanismo y resultado, adoptamos una convención técnica: error es una parte incorrecta del estado que puede contribuir a que el servicio falle; fallo es la desviación del servicio entregado respecto del correcto. La causa atribuida al error se denomina fault; cuando es una deficiencia del diseño o implementación, hablaremos de defecto. La taxonomía incluye también causas externas, por lo que fault no equivale siempre a defecto de código. Esta distinción procede de Avizienis et al., §2.2. En el habla cotidiana «error» tiene sentidos más amplios; aquí usaremos el vocabulario acotado para no confundir estado, causa y servicio.
La cadena mínima de diagnóstico es:
servicio esperado + observación → discrepancia de servicio
 discrepancia → preguntas sobre estado, causa e impacto
Cada flecha exige evidencia distinta y no representa necesariamente la causalidad histórica. Avizienis et al. describen fault como causa potencial de error y failure como desviación del servicio; el orden causal puede ser fault→error→failure, mientras que el orden de diagnóstico suele invertirse: observamos failure, buscamos error y luego hipótesis de fault. Una confirmación duplicada acredita una observación; para afirmar que ambas reservas se persistieron necesitamos evidencia de estado; para localizar el mecanismo debemos correlacionar concurrencia, transacciones, caché o dependencia. Saltar de la primera a la última flecha produce diagnósticos frágiles.
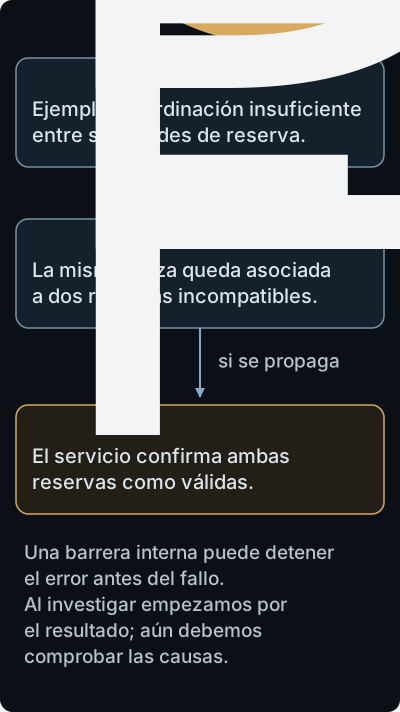
Defecto latente: una condición que puede producir el error
Un defecto es aquí una condición en diseño, implementación, configuración, datos, dependencia o integración que puede hacer que la ejecución se aparte del servicio esperado. Es latente cuando está presente pero aún no se manifiesta en la observación que tenemos. Un defecto no es el error mismo: dos ejecuciones pueden compartir el defecto y sólo una alcanzar las condiciones que lo activan.
En la taquilla, comprobar disponibilidad y registrar la reserva sin la coordinación necesaria puede contener un defecto. Con solicitudes suficientemente separadas, la ejecución puede no manifestarlo. En una concurrencia desfavorable, el estado puede llegar a asociar la misma plaza con dos reservas incompatibles: ése es el error del ejemplo. Cuando el servicio confirma ambas como válidas, manifiesta el fallo. Si una comprobación interna detecta y corrige el conflicto antes de comprometer el servicio, no se produce ese fallo, aunque el estado incorrecto haya existido. La activación y propagación son condiciones, no consecuencias inevitables de la presencia del defecto.
La misma cadena puede tener un defecto de configuración: el límite de concurrencia que el diseño presupone no está activado en una región. O un defecto de integración: el servicio de inventario confirma una versión de datos que el cliente interpreta con otro significado. “Defecto” no designa exclusivamente una línea de código.
Avizienis et al. y RFC 4949 conservan vocabularios próximos para fault, error y failure, pero con historia y alcance distintos. Por eso no afirmamos que todo equipo deba usar estas palabras con idéntica precisión. Lo importante para el lector es no colapsar presencia latente, estado erróneo y manifestación observable en una sola causa.
Fallo visible: cuando el servicio no cumple
Un fallo es la manifestación observable de que la ejecución no presta el servicio esperado para la operación y condiciones consideradas. La taquilla puede devolver un “éxito” que contradice el estado real, rechazar una reserva válida, perder la confirmación o quedar indisponible. Son fallos diferentes aunque tengan la misma pantalla de error.
El fallo es visible respecto de una frontera. Un proceso puede informar éxito al cliente y, al mismo tiempo, fallar en la persistencia. Para el cliente hay una confirmación; para la propiedad de conservación hay un fallo. Un proveedor de pagos puede aceptar la orden mientras la taquilla no registra la reserva. Hay un comportamiento real que intentamos reconstruir, pero ninguna de estas observaciones aisladas lo describe por completo.
Una avería accidental también puede afectar seguridad: disponibilidad e integridad importan aunque nadie haya obtenido datos ajenos. Un disco lleno que impide guardar reservas debe evaluarse contra las propiedades y políticas del servicio, no descartarse como «no seguridad» por falta de atacante. A la vez, no toda diferencia visual menor constituye un incidente. La definición histórica de NIST SP 800-61 Rev. 2, §2.1 incluía violaciones o amenazas inminentes de violación de políticas de seguridad, uso aceptable o prácticas estándar. Se cita para esa distinción, no como guía operativa vigente: Rev. 3 la reemplazó en abril de 2025.
La relación causal puede tener varias piezas. Un defecto en la lógica de reserva, una configuración que permite concurrencia excesiva y una dependencia lenta pueden cooperar. La primera explicación plausible no debe convertirse en causa raíz sin probar qué transición produjo el resultado.
Caso conductor: tres lecturas de la misma taquilla
Consideremos tres escenas con la misma interfaz.
Escena normal con fallo de corrección. Dos clientes legítimos envían solicitudes casi simultáneas. La aplicación responde “reserva confirmada” a ambos y después el inventario muestra una plaza ocupada dos veces. La observación y el estado violan la propiedad “como máximo una”. La hipótesis de carrera es compatible con el defecto latente; todavía hay que correlacionar tiempos y escrituras. Nada en la escena requiere intención adversaria.
Escena de abuso de capacidad. Una cuenta automatizada envía solicitudes a una frecuencia muy superior al límite publicado, usando sesiones válidas. El servicio se degrada y otros clientes reciben timeout. “Abuso” describe el uso fuera de propósito o límites declarados; no adjudica por sí solo una motivación criminal ni prueba que exista un defecto. El sistema puede estar funcionando conforme a su mecanismo de límite y aun así la capacidad ser consumida de forma no permitida.
Escena de ataque intencional. Una persona diseña una secuencia para alterar identificadores de reserva, eludir el control de propiedad y conseguir una plaza que la cuenta no podía reservar. Aquí sí hay una acción dirigida contra una propiedad o control. Puede explotar un defecto de autorización, pero también puede aprovechar credenciales robadas, una configuración permisiva o una interfaz legítima. El ataque no requiere que el fallo de la primera escena exista; un control puede ser atacado y bloquear correctamente la acción.
La apariencia externa no basta para distinguir las escenas. Tres respuestas 500 podrían proceder de una carrera, una dependencia caída o una carga deliberada. Para adjudicar hay que unir propiedad esperada, entradas, autoridad, estado, tiempo y evidencia de intención. La conclusión provisional puede ser “se observaron 500 en 12 solicitudes”; sólo una investigación adicional podría sostener “se abusó del límite” o “se atacó la autorización”.
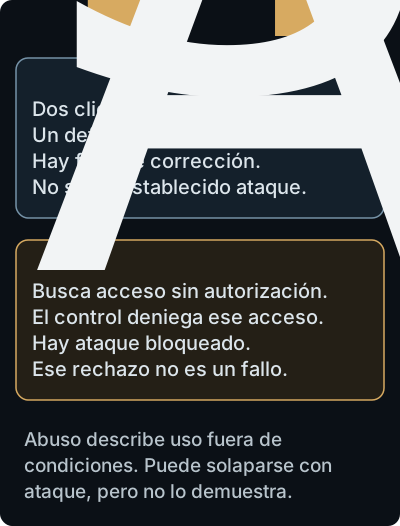
Abuso: capacidad usada fuera de su propósito
Usamos abuso para un uso de una capacidad que excede su propósito, límites o condiciones autorizadas. La frontera puede venir de una política, un contrato o una expectativa operacional. Abuso no es sinónimo de ataque: una integración mal configurada puede enviar una carga excesiva sin intención de causar daño. Tampoco todo uso intenso es abuso; una campaña autorizada puede producir tráfico alto dentro de sus condiciones.
La palabra es útil cuando la pregunta principal es de uso y autoridad, no de mecanismo. Si una API permite exportar informes a una cuenta con permiso y la cuenta descarga sus propios informes, el volumen puede ser grande sin ser abuso. Si la misma capacidad se usa para recopilar datos ajenos o eludir una cuota, la autorización y el propósito cambian. La observación debe incluir identidad, alcance y condiciones; un número alto aislado no clasifica la conducta.
El abuso puede revelar un defecto de diseño —por ejemplo, un límite que sólo se aplica a una ruta—, pero no lo presupone. Puede producir un fallo de disponibilidad sin tocar confidencialidad o integridad. La decisión defensiva debe entonces separar corrección del servicio, capacidad y autoridad: endurecer un límite no demuestra que se haya encontrado una vulnerabilidad.
Ataque: acción intencional contra una propiedad o control
Un ataque es, en este capítulo, una acción o secuencia deliberada dirigida a influir, degradar, obtener o mantener un efecto contra una propiedad o control. La intención distingue el término de una entrada accidental y la dirección contra una propiedad distingue un uso legítimo. RFC 4949, entrada «attack» ofrece una definición de ataque; sus fronteras no deben mezclarse mecánicamente con las de fallo o vulnerabilidad.
Un ataque puede aprovechar un defecto latente, pero no lo necesita. Un atacante puede usar credenciales válidas para extraer información permitida a otra identidad, saturar un canal que funciona exactamente como fue diseñado o inducir a un operador a ejecutar una acción autorizada. En esos casos el objetivo adversario está presente aunque no podamos señalar una línea de código defectuosa. A la inversa, una aplicación que duplica una reserva por una carrera no se convierte en ataque porque el efecto sea sensible.
La intención rara vez aparece en una sola señal. Una secuencia repetida, selección de objetivos, adaptación a respuestas y coincidencia con un beneficio pueden apoyar una hipótesis; ninguno de ellos debe presentarse como prueba universal. La conclusión debe declarar qué se observó y qué inferencia sigue abierta. “Se observaron solicitudes no habituales desde una cuenta” es distinto de “la cuenta atacó”.
Vulnerabilidad: frontera necesaria, taxonomía aplazada
Una vulnerabilidad es una debilidad con condiciones que pueden permitir que una fuente de amenaza produzca un efecto no autorizado o perjudicial. NIST SP 800-30 Rev. 1, §2.1 la separa de amenaza y riesgo. Esta definición mínima explica por qué un defecto puede ser inocuo respecto de seguridad, y por qué un ataque puede tener éxito sin que el defecto esté en el software local.
Un límite de interfaz mal aplicado puede ser un defecto; sólo será una vulnerabilidad cuando exista una condición de amenaza y una propiedad de seguridad comprometible. Un timeout por dependencia caída es un fallo de disponibilidad, no automáticamente una vulnerabilidad. La taxonomía de clases, puntuación, exposición y remediación pertenece a capítulos posteriores. Aquí basta con mantener la dirección causal abierta y exigir precondiciones.
Caso de transferencia: reportes y dependencia remota
Una API permite generar un reporte de una cuenta propia, acepta hasta 100 elementos por solicitud y depende de un servicio de identidad.
- Una solicitud válida de 20 elementos termina en timeout porque el servicio de identidad está caído. Hay un fallo de disponibilidad observado en esa ventana. Puede no haber defecto de seguridad ni ataque.
- Un cliente envía 100 elementos válidos, pero un parser entra en un bucle y consume toda la capacidad. Hay una discrepancia y una hipótesis de defecto; si el cliente desconocía el comportamiento, no llamamos ataque sólo por el tamaño máximo permitido.
- Una secuencia construida para acceder a identificadores de otra cuenta manipula el contexto de autorización. Si la intención y el efecto se corroboran, es compatible con un ataque; el defecto o configuración que lo permitió aún debe localizarse.
- Una integración autorizada genera miles de reportes en una ventana acordada y activa el límite de capacidad. Puede ser carga legítima, no abuso, si cumple sus condiciones.
La transferencia prueba que las etiquetas no sustituyen el análisis. En cada escena preguntamos: ¿qué se esperaba?, ¿qué se observó?, ¿qué estado quedó?, ¿qué condición latente explica la discrepancia?, ¿qué autoridad y propósito tenía la acción?, ¿qué evidencia apoya intención? El mismo código de respuesta puede aparecer en las cuatro.
Mecanismo antes de la etiqueta
Una forma práctica de no adelantarse es escribir la explicación en capas. Primero se fija la propiedad: “el reporte de una cuenta no contiene filas de otra cuenta”. Después se registra el hecho: “la respuesta de la cuenta A incluyó el identificador de B a las 09:14:03 UTC”. En tercer lugar se describe el estado que lo hizo posible: “el servicio de autorización devolvió una decisión positiva para ese contexto” o “esa decisión no pudo reconstruirse”. Sólo entonces se propone mecanismo: caché compartida, resolución de identidad incorrecta, configuración o dependencia. La palabra ataque queda fuera hasta que exista evidencia de dirección intencional.
Este orden también evita el error inverso: negar toda posibilidad de seguridad porque aún no conocemos la causa. Una exposición observada puede requerir contención aunque el defecto no esté localizado. La respuesta defensiva puede limitar la cuenta, preservar evidencia o aislar una dependencia, mientras la investigación mantiene varias hipótesis. La decisión operativa y la certeza causal son dimensiones distintas.
El tiempo es parte del mecanismo. Si el servicio de identidad cambió su respuesta entre dos peticiones, una captura del estado actual puede contradecir la evidencia de la ventana original sin que ninguna de las dos sea falsa. Si una caché conserva una decisión durante cinco minutos, el registro de configuración posterior no explica la respuesta anterior. La reconstrucción debe conservar timestamps, identificador de instancia, contexto de autorización y versión de la dependencia cuando estén disponibles. Cuando no lo estén, esa ausencia es una limitación del claim, no permiso para completar la historia.
La autoridad también se reparte. El equipo de la API puede controlar el parser y sus límites; el proveedor de identidad puede controlar la decisión de autorización; una cuenta administradora puede cambiar la cuota; un cliente puede elegir la frecuencia de sus solicitudes. Un fallo que cruza esas fronteras no tiene automáticamente un único responsable. Atribuir “el sistema” como actor único borra qué control podía cambiar cada participante y qué evidencia puede pedirle una investigación.
Decisiones defensivas proporcionales
El vocabulario sirve para elegir una siguiente observación. Si sólo hay un fallo de disponibilidad, la pregunta prioritaria puede ser salud de la dependencia, colas y recuperación. Si hay un defecto reproducible con entradas legítimas, interesa aislar la condición, corregirla y verificar que el servicio vuelva a cumplir su propiedad. Si existe uso fuera de límites, se revisan autorización, cuotas y contrato; no se etiqueta a la persona sin evidencia de intención. Si la hipótesis de ataque gana apoyo, se preservan trazas y se reduce el alcance del control comprometido, pero la contención no reemplaza la explicación.
La corrección también exige comprobar sus efectos; identificar una deficiencia y aplicar un cambio no acreditan por sí solos la recuperación. Esa secuencia no dice que toda corrección resuelva el incidente completo: un cambio de código puede dejar datos expuestos, sesiones activas o efectos externos. Tampoco toda mitigación elimina el defecto. Un límite temporal puede reducir el impacto mientras una corrección permanente sigue pendiente. Redactar la decisión con el mismo alcance que la evidencia evita prometer recuperación total.
Una matriz sencilla ayuda a no mezclar preguntas:
Desliza horizontalmente para consultar todas las columnas.
La tabla no reemplaza una investigación. Su función es impedir que una evidencia de una columna se presente como conclusión de otra.
Cómo redactar una conclusión defendible
Una nota de investigación puede usar cinco columnas: propiedad esperada; observación y ventana; estado o impacto confirmado; hipótesis de mecanismo; intención y autoridad. Si una columna no tiene evidencia, se escribe “desconocido”, no se rellena con una etiqueta.
Una buena conclusión separa niveles: “Entre 14:02:10 y 14:02:12, dos solicitudes autenticadas recibieron confirmación para la misma plaza; el inventario persistió dos identificadores. Esto establece un fallo de exclusión. Los registros son compatibles con una carrera, pero no localizan todavía el defecto ni indican intención. No se ha establecido un ataque.”
Otra podría decir: “La cuenta X superó el límite publicado durante 10 minutos y provocó respuestas 429 a terceros. Está acreditado un uso fuera de las condiciones de servicio; la intención adversaria y la existencia de una vulnerabilidad siguen abiertas.” Esta redacción es más larga que “ataque de denegación”, pero conserva las decisiones que todavía pueden cambiar.
Síntesis
El modelo causal y el diagnóstico se leen en sentidos diferentes. Una causa activada puede producir un estado erróneo; si éste afecta al servicio, aparece un fallo. Al investigar solemos comenzar por el resultado visible y buscar qué estados y condiciones lo explican. Recorrer esa búsqueda no prueba por sí solo la causa.
Abuso y ataque no son etapas posteriores al fallo. Describen uso, autoridad e intención; el resultado se evalúa aparte. Una acción deliberada puede ser bloqueada, mientras una ejecución legítima puede terminar en un fallo accidental.
Las ramas no son exclusivas: un ataque puede activar un defecto y causar un fallo; un ataque bloqueado sigue siendo ataque aunque no haya fallo; un abuso puede ser accidental o, si es deliberado contra un control, solaparse con ataque; un fallo puede ser accidental. La disciplina consiste en conservar propiedad, ventana, composición, autoridad e incertidumbre hasta que la evidencia permita una inferencia más fuerte.
Comprueba el modelo
Una acción deliberada intenta obtener datos sin permiso; el control la rechaza. ¿Hubo ataque? ¿Falló el servicio? Después, dos clientes legítimos reciben confirmaciones incompatibles por un defecto de coordinación. ¿Qué cambia en la clasificación?
Contrasta tu razonamiento
La primera escena puede ser un ataque bloqueado: la intención y el objetivo no dependen del éxito. Si el rechazo era el comportamiento exigido, ese control no falló en la escena. En la segunda se observa un fallo de corrección sin necesitar intención adversaria. Hay que separar el estado erróneo y su causa del resultado entregado, y no inferir un ataque del daño.