Cuando el sistema sigue encendido pero la función ya falló
Un servidor puede tener energía, mantener procesos en ejecución y aceptar conexiones mientras la función que importa dejó de prestarse. También puede volver a responder después de un reinicio y conservar un estado que la aplicación ya no puede interpretar correctamente. Estas situaciones se describen a veces con una sola palabra: «caída». Para trabajar con rigor hay que separar al menos tres preguntas: ¿puede el usuario obtener la función?, ¿el estado persistente sigue satisfaciendo sus invariantes?, y ¿qué parte de ese estado puede recuperarse sin introducir un error anterior?
Este capítulo usa fallo de sistema para referirse a una transición en la que una función, propiedad o umbral acordado deja de cumplirse. No implica que haya existido una intrusión. Puede causarlo un agotamiento de recursos, un dispositivo defectuoso, una dependencia inaccesible, una operación de mantenimiento, una escritura incompleta o una condición adversaria. La misma causa puede producir indisponibilidad, corrupción o ambas, pero esas propiedades no son sinónimas.
La disponibilidad no es «el proceso está vivo». La corrupción no es «un archivo tiene una suma distinta». La recuperación no es «hay una copia». Cada afirmación necesita un activo, una función, una versión, un punto temporal, dependencias y evidencia. El objetivo profesional es poder explicar la transición, limitar el daño, restaurar desde una fuente adecuada y validar antes de declarar que el servicio ha vuelto.
¿Qué ocurre entre una causa y una failure?
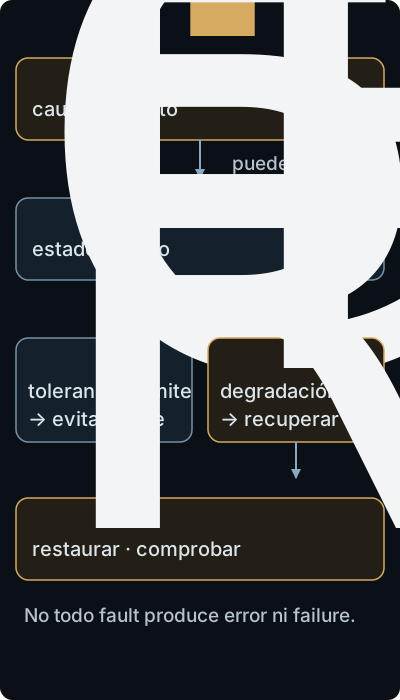
La contención puede evitar la failure observable.
Conviene distinguir cuatro términos. Un fault es una condición capaz de producir un estado incorrecto: un bloque ilegible, una configuración incompatible o una dependencia que deja de responder. Un error es ese estado incorrecto dentro de un componente: un dato en memoria no válido, una cola desbordada o un índice que ya no corresponde con sus registros. Una failure es la incapacidad observable de entregar la función requerida. Un fallo se usa aquí como término general para la transición y su consecuencia.
La relación no es lineal. La redundancia puede ocultar un fault; un timeout puede convertir una dependencia lenta en una failure aunque ningún bit esté corrupto; una aplicación puede confirmar una operación lógica incompleta y producir un estado inválido sin que el almacenamiento haya fallado físicamente. Por eso un informe no debe saltar de «apareció una alerta» a «la causa fue el disco». Debe separar observación, inferencia, impacto posible y decisión.
El dominio de fallo es el conjunto de componentes que pueden dejar de funcionar por una causa común. Dos discos en el mismo chasis, dos réplicas que reciben la misma escritura incorrecta o un backup conectado al mismo control administrativo pueden parecer redundantes y compartir un dominio de fallo. Reducir el dominio exige conocer las dependencias y, cuando corresponda, separar ubicación, credenciales, red, tiempo de propagación y autoridad de borrado.
NIST SP 800-34 Rev. 1 estructura la planificación de contingencia alrededor del análisis de impacto, controles preventivos, estrategias de recuperación, plan, pruebas y mantenimiento. Esa secuencia no convierte todos los sistemas en disponibles; obliga a relacionar una función con prioridades y recursos de recuperación. Un plan que no declara qué función recupera ni qué dependencia necesita es documentación, no todavía evidencia de capacidad.
Disponibilidad: una propiedad de la función y sus dependencias
La disponibilidad significa que una función autorizada puede obtenerse dentro de las condiciones acordadas. El alcance debe incluir qué operación, para qué principal, con qué datos y durante qué ventana. Un panel puede cargar mientras su API de escritura está bloqueada; una API puede responder con 200 y devolver un estado desactualizado; un servicio puede atender a algunos clientes y no a otros por saturación de un pool. Cada situación exige un claim diferente.
Una forma útil de reconstruir la función es seguir su camino: entrada, autenticación, autorización, proceso, almacenamiento, dependencia externa, respuesta y observabilidad. En cada paso se pregunta qué recurso consume, qué timeout aplica y qué ocurre al degradarse. Si una respuesta puede construirse sin consultar la base de datos, el health check debe decirlo; de lo contrario, un check superficial puede declarar «saludable» un servicio que no puede completar una operación crítica.
La degradación también tiene estados. Puede haber capacidad reducida, latencia excesiva, errores parciales o modo de sólo lectura. Un diseño puede aceptar el modo de sólo lectura para preservar consultas mientras impide escrituras inciertas. Esto no es una garantía universal: es una decisión que debe fijar qué propiedad se conserva, qué operaciones se rechazan y cómo se evita que una respuesta parcial se interprete como confirmación.
Los timeouts y reintentos muestran por qué la disponibilidad puede empeorar por una dependencia. Si el cliente reintenta una operación que fue recibida pero cuya respuesta se perdió, la aplicación necesita una clave de idempotencia o una forma de consultar el resultado. De lo contrario, la recuperación de conectividad puede duplicar la operación. El mecanismo de reintento trata una clase de pérdida de respuesta; no prueba que el estado se haya aplicado una sola vez.
Un claim de disponibilidad debería indicar, por ejemplo: «Para la versión V del servicio S, la operación O sobre el activo A debe devolver un resultado válido en menos de T durante la ventana W, cuando las dependencias D están dentro de sus límites; el modo de sólo lectura y las operaciones administrativas quedan fuera». La formulación permite diseñar pruebas positivas y negativas. Un puerto abierto prueba una condición de transporte; no prueba el claim completo.
¿Cómo aparece la corrupción?
Hay corrupción física cuando el medio o una capa de transporte devuelve datos que no corresponden con lo escrito o no puede leerlos. Hay corrupción lógica cuando una operación válida para una capa deja un estado que viola invariantes de la aplicación: un índice apunta a una fila inexistente, una referencia conserva un identificador antiguo o dos archivos que debían cambiar juntos divergen. Hay pérdida de durabilidad cuando un cambio que parecía confirmado no sobrevive a una interrupción. Hay inconsistencia cuando diferentes representaciones del mismo hecho no coinciden.
La corrupción puede comenzar mucho antes de ser visible. Un proceso escribe en un buffer; el sistema de archivos aplaza la asignación; el dispositivo mantiene una caché; una segunda entidad aún no se actualiza. Si el sistema se reinicia entre pasos, cada capa puede recuperar su propia estructura sin conocer la relación lógica de las demás. Una suma de comprobación puede detectar que el contenido cambió, pero no dice cuál era el contenido correcto ni si el índice y el registro pertenecen a la misma transacción.
Por eso el orden de escritura importa. Un patrón de actualización suele escribir una versión temporal, forzar su persistencia, renombrarla y forzar la persistencia del directorio. El detalle exacto depende del sistema de archivos y de la API. El objetivo es reducir la ventana en la que el nombre apunta a un archivo incompleto. Aun así, el patrón de un archivo no coordina automáticamente cambios en otra tabla, otro volumen o un servicio remoto.
La documentación del kernel para ext4 es un límite pedagógico útil, no una ley para todos los filesystems. Describe que el journal protege frente a inconsistencias de metadatos; en el modo data=ordered, los bloques de datos no reciben automáticamente una garantía de estado consistente de aplicación tras un crash. Un filesystem puede volver a montarse y dejar un archivo que la aplicación no puede usar. La conclusión correcta nombra el filesystem, el modo, la versión y la propiedad evaluada.
¿Qué aportan las capas de durabilidad?
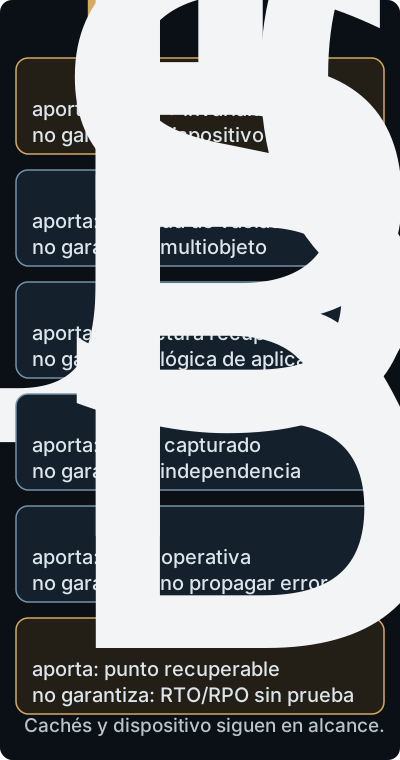
Ninguno sustituye la evidencia de los demás.
La atomicidad de una operación significa que el sistema observa el cambio completo o no observa ninguno dentro de un alcance definido. Durabilidad significa que un cambio confirmado sobrevive a la clase de interrupción declarada. Journaling registra operaciones o metadatos para facilitar recuperación tras un crash. Write-ahead logging (WAL) registra información antes de aplicar cambios para que una aplicación o motor pueda rehacerlos. Ninguno de estos términos, sin contexto, significa que el sistema completo sea consistente.
POSIX fsync() solicita transferir al dispositivo los datos asociados a un descriptor abierto. La especificación indica que, si la llamada falla, las operaciones pendientes no quedan garantizadas. Eso responde una pregunta sobre ese descriptor y esa implementación. No coordina por sí sola otro descriptor, la entrada del directorio, una base de datos remota ni una política de backup. Un programa que ignora el valor de retorno ha descartado precisamente la señal que permite saber si la solicitud tuvo éxito.
En Windows, las operaciones de archivo pueden permanecer en buffers mantenidos por el sistema. La documentación de Win32 describe FlushFileBuffers como una forma de solicitar el vaciado de esos buffers para un archivo o dispositivo. Cerrar un archivo no equivale automáticamente a ejecutar esa solicitud. Este contrato debe combinarse con el comportamiento del filesystem, del controlador y del medio; no se debe traducir sin más a «los bytes están a salvo ante cualquier pérdida de energía».
Un WAL de base de datos puede proteger páginas y permitir rehacer transacciones confirmadas, pero requiere que el log y los datos se conserven con la configuración prevista. Si el volumen que contiene el WAL se pierde, o si la aplicación confirma una operación antes de registrar una dependencia externa, el alcance cambia. Un WAL puede devolver una base de datos a un estado transaccional y no reconstruir el archivo de configuración que el servicio necesita para iniciar.
Un snapshot captura una vista en un instante. Puede ser eficaz para clonar o volver atrás, pero puede depender del mismo almacenamiento, de las mismas credenciales o de un mecanismo que no coordina buffers de aplicación. Una réplica puede reducir el tiempo de servicio, pero propaga borrados y estados lógicamente corruptos si no hay una barrera temporal o una validación independiente. Un backup está destinado a recuperación, pero sólo es útil cuando su punto temporal, procedencia, integridad, acceso y procedimiento de restauración son conocidos.
La tabla siguiente ayuda a mantener las preguntas separadas:
Desliza horizontalmente para consultar todas las columnas.
Caso conductor: inventario, índice y reinicio
Supongamos un servicio de inventario que actualiza una tabla de existencias, un índice de búsqueda y un archivo de configuración. La operación «reservar unidad» debería disminuir la cantidad y añadir una reserva consultable. El proceso escribe la tabla y el índice mediante mecanismos distintos. Durante una interrupción, la respuesta al cliente se pierde después de que la tabla se actualiza pero antes de que el índice se confirme.
La primera observación no es «la base está corrupta». Es más limitada: existe un registro de la operación, la tabla refleja una cantidad y el índice no devuelve la reserva. Hay que confirmar la procedencia de cada observación, su momento y si el sistema estaba en modo de recuperación. La inferencia provisional es una divergencia entre representaciones; la causa podría ser un orden de escrituras, un timeout o un fallo de una dependencia. La decisión de reabrir escrituras requiere más evidencia.
Si el filesystem recupera su journal, el archivo puede tener metadatos válidos y el motor puede iniciar. El servicio sigue sin cumplir la invariante «cada reserva confirmada aparece en el índice» hasta reconstruir o reparar ese índice. Si una réplica ya recibió la misma tabla, no es una alternativa independiente para esa invariante. Si un snapshot diario contiene la divergencia, volver a él recupera un estado antiguo pero no correcto.
La respuesta debe preservar el volumen original, impedir nuevas escrituras ambiguas y guardar logs y metadatos. Después se comparan puntos de recuperación y se identifica la última combinación en la que tabla, índice y configuración satisfacen sus invariantes. La reparación se ejecuta en un entorno separado, de forma repetible e idempotente. Antes de abrir tráfico se prueban lecturas, una reserva sintética, permisos, versión del esquema, dependencias y alertas. Si la validación no puede establecerse, el modo correcto puede ser sólo lectura o no reanudar todavía.
Diseñar recuperación sin convertirla en improvisación
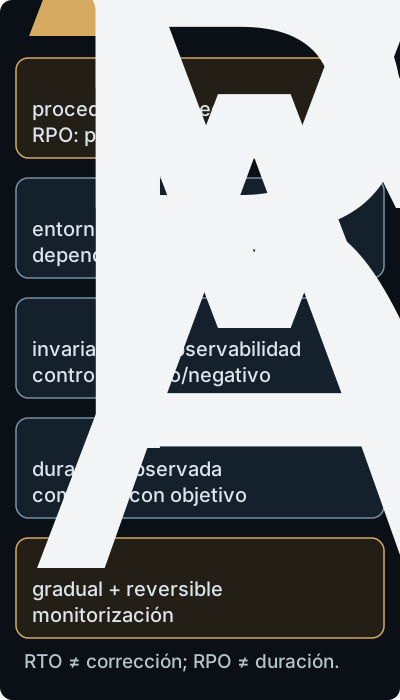
RTO no mide corrección; RPO no mide duración.
Una recuperación profesional comienza con el alcance. Se declara qué función está degradada, qué activos están implicados, qué clases de fallo se contemplan y quién puede autorizar la transición. En un evento de ciberseguridad, las actividades de recuperación deben coordinarse con la preservación de evidencia y la contención; en un fallo físico o lógico puede ser suficiente el plan de contingencia, pero la separación entre observación y decisión sigue siendo necesaria.
El Recovery Point Objective (RPO) es la pérdida temporal máxima aceptable. Un RPO de 15 minutos no significa que siempre se pierdan 15 minutos ni que una copia de 15 minutos sea correcta; exige que la estrategia pueda recuperar un punto dentro de ese límite para el escenario declarado. El Recovery Time Objective (RTO) es el tiempo objetivo hasta restaurar la función acordada. Medir que una restauración tardó 20 minutos en un ejercicio no prueba que todos los escenarios cumplan un RTO de 30 minutos.
La secuencia de recuperación puede organizarse así:
- Detectar y declarar. Confirmar qué función falla, abrir un registro de tiempo y decidir si existe un incidente que requiera respuesta adicional. No sobrescribir el único artefacto que podría explicar la causa.
- Contener. Detener escrituras inseguras, aislar dependencias defectuosas y limitar propagación. La contención debe preservar la posibilidad de inspeccionar y volver atrás.
- Preservar. Capturar estado, logs, configuración, versiones, permisos y procedencia de la fuente. La adquisición debe tener un propósito y un límite, no ser una colección indiscriminada.
- Elegir el punto. Comparar backups, snapshots, WAL o reconstrucción según RPO, integridad, independencia y contaminación posible. Un punto reciente no vale más si ya contiene el error.
- Restaurar o reconstruir. Trabajar en un entorno controlado, aplicar la configuración versionada y registrar qué se copia, rehace o descarta. La restauración debe ser reproducible y reversible en la medida exigida.
- Validar. Comprobar invariantes de datos, versión, permisos, dependencias, capacidad, observabilidad, controles de acceso y operaciones negativas que no deben funcionar. Un health check debe representar la función, no sólo el proceso.
- Reanudar gradualmente. Abrir la función con un grupo o tráfico limitado, monitorizar errores y mantener una decisión de rollback. Documentar diferencias entre el estado recuperado y el esperado.
- Aprender y mantener. Registrar la causa confirmada, incertidumbres, tiempos, pérdida real, fallos del plan y cambios necesarios. NIST SP 800-184 insiste en probar y mejorar playbooks; el aprendizaje no es una sección ornamental del informe.
La restauración debe incluir una condición de «no abrir». Ejemplos: no se conoce la procedencia del punto, no se puede verificar la invariante principal, falta una dependencia crítica, el sistema recuperado tiene una versión incompatible o la evidencia indica que el origen sigue alterando datos. Declarar esa condición protege disponibilidad futura y evita convertir una recuperación parcial en una nueva corrupción.
Errores frecuentes al diagnosticar y recuperar
Llamar disponibilidad a un proceso vivo. Se corrige definiendo la operación y comprobando un resultado válido con sus dependencias.
Llamar corrupción a cualquier pérdida. Una copia vieja puede incumplir RPO sin estar corrupta; un archivo puede ser legible y violar una invariante lógica. Describir el estado antes de asignar la etiqueta.
Confiar en el journal como transacción de negocio. El journal conoce la capa que implementa, no las relaciones que la aplicación mantiene entre tablas, archivos o servicios.
Confundir réplica con backup. Preguntar qué errores se propagan, qué retención existe y quién puede borrar ambos lados.
Restaurar sobre el original inmediatamente. Preservar la fuente y ensayar en un entorno separado permite revisar una decisión equivocada sin perder el estado de diagnóstico.
Usar RTO y RPO como decoración. Ambos deben vincularse a una función, escenario, punto de datos y medición. Cambiar una dependencia puede invalidar el objetivo sin cambiar el texto del plan.
Reabrir tráfico por presión operativa. La urgencia puede justificar un modo degradado explícito, pero no permite llamar validado a un sistema cuya propiedad principal no se comprobó.
Uso profesional: de la copia al claim verificable
Antes de elegir alta disponibilidad, snapshots o reconstrucción, conviene preguntar qué pérdida resulta inaceptable, cuánto estado puede rehacerse y quién debe autorizar una degradación. Un sistema pequeño puede preferir restauración simple y verificable; otro puede necesitar redundancia, WAL y recuperación automatizada. El mecanismo se elige por la función y el dominio de fallo, no por la etiqueta de producto.
El claim resultante podría ser: «Para el servicio S, versión V, ante la pérdida del volumen D sin corrupción previa de la fuente, el procedimiento P recupera la operación O en T minutos desde un punto con pérdida máxima R y valida las invariantes I antes de abrir tráfico». Las condiciones importan: no cubre una copia contaminada, una versión distinta, una dependencia que no se pudo restaurar o un dominio de fallo que destruya todas las fuentes. Explicitar límites no debilita el claim; evita que se aplique fuera de aquello que la evidencia sostiene.
La revisión periódica debe comprobar que el procedimiento todavía corresponde al sistema. Cambios en esquema, permisos, claves, rutas, controladores, retención o responsables pueden romper una recuperación sin producir una alerta en el servicio normal. Un ejercicio útil registra cuánto tardó cada etapa, qué supuestos fueron falsos, qué observabilidad faltó y qué datos se perdieron realmente. La prueba no es una demostración eterna: es evidencia fechada para una configuración y un escenario.
Síntesis
Un fallo de sistema no se entiende mirando únicamente el componente que dejó de responder. La función depende de procesos, recursos, almacenamiento, configuración, identidad, red, operadores y estado persistente. Disponibilidad describe la entrega de una función; corrupción describe una alteración o divergencia respecto de invariantes; durabilidad describe qué cambios sobreviven a una interrupción. Pueden ocurrir separadamente o componerse.
Journaling, fsync, FlushFileBuffers, WAL, snapshots, backups y réplicas son mecanismos con contratos distintos. Cada uno puede responder una pregunta útil y dejar otras abiertas. La recuperación exige preservar, contener, elegir una fuente, restaurar o reconstruir, validar y reanudar con un criterio explícito de no abrir. RTO y RPO expresan objetivos de esa estrategia, no etiquetas que sustituyan a las pruebas.
El modelo profesional es una cadena de estados y evidencia: qué función falló, qué estado se observó, qué causa se infiere, qué activo puede haberse afectado, qué punto se elige y qué validación autoriza reanudar. Cuando una conclusión no puede sostenerse, «recuperación todavía no validada» es más exacto que «sistema restaurado». Esa precisión convierte un procedimiento de emergencia en una capacidad que puede mantenerse, revisar y mejorar.
Fuentes principales
- NIST. SP 800-34 Rev. 1: Contingency Planning Guide for Federal Information Systems, 2010.
- NIST. SP 800-184: Guide for Cybersecurity Event Recovery, 2016.
- NIST. SP 800-61 Rev. 3: Incident Response Recommendations and Considerations for Cybersecurity Risk Management, 2025.
- The Open Group.
fsync()en POSIX.1-2008. - Linux kernel. ext4 journal y ext4 General Information.
- Microsoft Learn. Flushing System-Buffered I/O Data to Disk.