El mismo patrón puede significar cosas distintas
Una captura contiene los octetos 01 00 00 00. Un analista los lee como una longitud enorme; otro como el entero 1; un tercero como cuatro caracteres de control. Ninguno puede elegir sólo mirando la secuencia. Antes de preguntar si el valor es peligroso hay que saber quién lo produjo, qué formato especificó la interfaz, dónde empieza el campo, qué arquitectura lo interpreta y qué operación realizará después.
Éste es el problema intelectual del capítulo: los bits son necesarios para que una máquina almacene y transforme información, pero no llevan su significado escrito dentro. El significado aparece cuando una regla de representación los relaciona con un valor, una instrucción, un símbolo o un dato opaco. La misma secuencia puede ser válida bajo una regla y absurda bajo otra. En seguridad, un error de interpretación puede ocultar un desbordamiento, fabricar una alerta, romper una firma o hacer que dos componentes tomen decisiones diferentes.
También necesitamos una forma disciplinada de hablar de una máquina en el tiempo. Una máquina no es sólo una colección de bytes; es un estado que cambia mediante operaciones y eventos. El estado que interesa depende de la pregunta: para reconstruir por qué una instrucción produjo un resultado quizá basten ciertos registros y posiciones de memoria; para explicar una condición de concurrencia habrá que incluir más actores; para estudiar persistencia hay que seguir la transición hacia almacenamiento no volátil. El modelo debe decir qué incluye y qué deja fuera.
Este capítulo construye ese vocabulario. Distingue almacenamiento, representación, estado, transición y observación. Después lo aplica a orden de bytes, números, serialización e invariantes. El objetivo no es memorizar una tabla de formatos, sino poder justificar qué se sabe a partir de un artefacto y qué falta antes de tomar una decisión profesional.
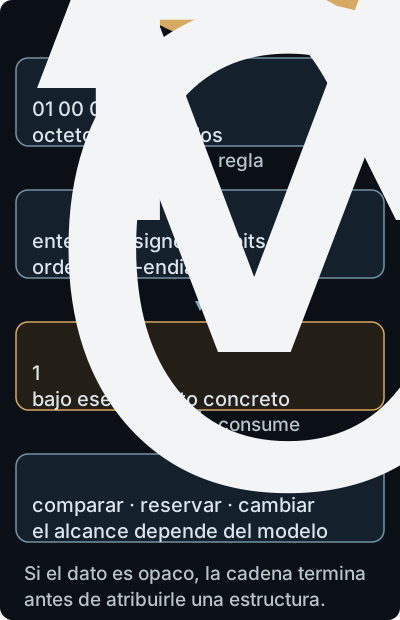
El valor 1 mostrado supone explícitamente un entero sin signo de 32 bits en orden little-endian.
De un bit a una representación
Un bit es una unidad que, dentro de un modelo binario, puede tomar dos valores. Un octeto es un grupo de ocho bits; se usa aquí para evitar que “byte” o word se entiendan como unidades universales. Una arquitectura puede definir otras unidades de transferencia y una interfaz puede agrupar octetos con reglas propias. El nombre de la unidad no aporta todavía el significado del contenido.
La primera distinción útil es entre valor y representación. El valor abstracto 1 puede aparecer como 01, 00000001, cuatro octetos 01 00 00 00, texto 31 en ASCII o una bandera encendida. La representación fija cuántos bits se usan, en qué orden, si hay signo, cómo se codifican valores especiales y qué entradas son inválidas. Intel describe en su manual de arquitectura distintos tipos y tamaños de datos, pero esas reglas son las de la familia documentada; no una ley de todo sistema de cómputo. Intel SDM, Vol. 1, revisión 093, §4.1
Una codificación asigna representaciones a símbolos o estructuras. UTF-8, por ejemplo, no significa “interpretar cada octeto como un carácter”; define secuencias válidas de uno a cuatro octetos, restricciones sobre sus valores y reglas para reconstruir puntos de código Unicode. RFC 3629, §§3–4 Un formato de mensaje puede asignar los primeros cuatro octetos a una longitud, los siguientes a una etiqueta y el resto a contenido. Si el consumidor aplica una codificación distinta, no ha descubierto una variante del mismo mensaje: ha ejecutado otra interpretación.
Un tipo reúne representación y operaciones permitidas. El patrón ff ff puede representar 65 535 como entero sin signo de 16 bits, -1 en complemento a dos, un valor reservado en un protocolo o dos octetos de una firma. La pregunta “¿qué número es?” es incompleta si no declara el tipo y el ancho. En una revisión, esta omisión debe expresarse como incertidumbre, no rellenarse con la convención que el analista usa a diario.
La cadena de interpretación puede escribirse así:
almacenamiento → representación → valor o estructura → operación → efecto observable.
En cada flecha hay una precondición. El almacenamiento debe provenir del lugar y momento correctos; la representación debe estar especificada; el valor debe ser aceptable para la operación; y el efecto debe observarse con cobertura suficiente. Si el dato es opaco, la cadena termina antes: un hash, un nonce o un ciphertext pueden transportarse sin que el intermediario les atribuya una estructura interna.
Leer una representación sin adivinar
La notación hexadecimal aparece tanto en documentación como en capturas porque permite escribir los bits de forma compacta. No añade una interpretación: es otra manera de expresar una cantidad o un patrón. Usa dieciséis símbolos, de 0 a 9 y de a a f; estos últimos representan los valores decimales de 10 a 15. Un dígito hexadecimal corresponde a cuatro bits, y dos dígitos bastan para un octeto. El prefijo 0x anuncia esa base; no forma parte del dato almacenado.
Consideremos 0xb4. La posición de la izquierda pesa dieciséis y la de la derecha pesa uno: 11 × 16 + 4 = 180. En binario, el mismo patrón se escribe 10110100. Si se interpreta como entero sin signo, sus posiciones activas suman 128 + 32 + 16 + 4 = 180. Hemos obtenido un valor aplicando una regla posicional; todavía no sabemos si el campo del que salió es realmente un entero.
El patrón tiene ocho posiciones y cada una admite dos posibilidades. Por eso existen 2^8 = 256 patrones diferentes. Un entero sin signo de ocho bits los asigna a los valores de 0 a 255. En general, con n bits hay 2^n patrones y el rango sin signo va de 0 a 2^n − 1. El número de patrones no cambia cuando cambia su interpretación.
Por ejemplo, el complemento a dos de ocho bits asigna a la posición izquierda un peso de −128 en lugar de +128. El patrón 10110100 se interpreta entonces como −128 + 32 + 16 + 4 = −76. El rango de esta representación es −128 a 127. No hemos cambiado ningún bit ni descubierto una contradicción: hemos cambiado la regla que relaciona el patrón con un número. En general, el complemento a dos de n bits abarca desde −2^(n−1) hasta 2^(n−1) − 1.
Estas cuentas también aclaran qué significa perder información al reducir el ancho. Imagina un formato didáctico sin signo de cuatro bits, con valores de 0 a 15. La suma matemática 13 + 5 vale 18 y necesita cinco bits: 10010. Si una operación definida expresamente por ese formato conserva sólo los cuatro bits inferiores, almacena 0010, cuyo valor es 2. Esa regla equivale a conservar el resto módulo16; no debe atribuirse automáticamente a cualquier suma de un programa. El comportamiento real depende de la instrucción, del tipo y de las reglas del lenguaje: puede haber comprobaciones, señales de desbordamiento u otras consecuencias.
La lectura profesional separa así tres preguntas: qué patrón se observó, qué regla lo interpreta y qué operación se aplicó. Para comparar dos registros no basta que ambos muestren «180»: uno puede ser texto decimal y otro un entero binario. Para explicar un resultado 2 tampoco basta decir «hubo desbordamiento»: hay que identificar el ancho y la regla de conversión que produjeron ese resultado. Los ejemplos anteriores son derivaciones aritméticas de representaciones declaradas, no evidencia de un defecto en un producto.
El orden de bytes no es el valor
Un valor de varias unidades necesita una regla para asociar cada octeto con sus bits más o menos significativos. En una representación big-endian, el octeto más significativo aparece primero; en little-endian, aparece último. Para los cuatro octetos 01 02 03 04, una lectura big-endian produce 0x01020304 y una lectura little-endian produce 0x04030201, si la secuencia ocupa memoria consecutiva y se aplica una lectura de 32 bits con esa convención.
La diferencia no significa que una arquitectura “cambie” el valor por capricho. Significa que emisor y receptor deben coincidir en la convención. El orden forma parte del formato de representación, igual que el ancho y el signo. Intel documenta la disposición little-endian de sus datos de varios bytes; una ISA distinta puede tener otra regla o instrucciones para intercambiarla. Intel SDM, Vol. 1, revisión 093, §1.3.1
El error frecuente es leer una captura con la convención local y describir el resultado como una propiedad del protocolo. La comprobación profesional es más corta: localizar la especificación, anotar ancho y orden, reproducir la conversión con una entrada conocida y verificar que el siguiente campo empieza donde el formato dice. Si dos extremos no coinciden, el problema puede ser un defecto de interfaz, pero aún hay que distinguirlo de una captura desalineada, una versión distinta o una vista que omite bytes.
El orden también afecta a campos parciales. Si se reciben tres de los cuatro octetos de un entero, no se puede completar el valor sin saber si falta el primero, el último o un fragmento intermedio. Afirmar “la longitud es X” a partir de una ventana incompleta es transformar una hipótesis de alineación en un hecho.
Números, signos y formatos especiales
Para un entero sin signo de (n) bits, la representación binaria suele asociar cada posición con una potencia de dos. Eso permite derivar un rango finito, pero no autoriza a ignorar la conversión que hace el lenguaje o la API. En complemento a dos, una misma secuencia se interpreta con un signo y un rango diferentes. Una comparación entre un valor firmado y uno no firmado puede convertir un dato aparentemente negativo en una cantidad grande antes de verificar un límite.
El mecanismo relevante para seguridad no es una lista de trucos, sino la conservación del rango. Si una interfaz acepta una longitud de 32 bits y el consumidor la reduce a 16 antes de multiplicarla por el tamaño de un elemento, el resultado puede dejar de representar la entrada. A partir de ahí, los bytes que el parser cree que caben y los bytes que la reserva puede recibir dejan de tener una relación evidente. La existencia de la conversión es una observación; que produzca corrupción o control del flujo exige conocer el lenguaje, las comprobaciones posteriores, el asignador y la ruta completa.
Los formatos de punto flotante muestran con claridad por qué el patrón no basta. IEEE 754 especifica campos y operaciones que incluyen ceros con signo, infinitos y NaN; no todas las secuencias representan un número real ordinario. IEEE 754-2019, §§3–6 Un analista que convierta un campo a entero porque “son ocho bytes” puede perder una condición especial que altera una comparación, una serialización o un cálculo de política. El uso profesional consiste en identificar el formato antes de aplicar aritmética y registrar qué valores especiales admite.
Una función hash ofrece otro contraste. FIPS 180-4 define cómo agrupar bits, rellenar mensajes y aplicar rondas para obtener un digest. FIPS 180-4, §§3–5 El digest permite detectar una diferencia si se compara con una referencia confiable bajo el mismo algoritmo. No demuestra por sí solo quién eligió el mensaje, que la referencia no fue sustituida, ni que el contenido tiene el significado esperado. La transformación está definida; la conclusión de seguridad necesita una relación de confianza adicional.
Estado: qué hace falta para describir una máquina
Llamaremos estado a la información que un modelo necesita para predecir o explicar el siguiente paso dentro de un alcance concreto. Un modelo mínimo de una ejecución puede incluir registros visibles al software, memoria relevante, el contador de instrucciones y una representación de las entradas. Puede añadir indicadores, modo de ejecución, estado de dispositivos, reloj o eventos externos cuando la pregunta los requiera.
La palabra “estado” no implica que todo sea visible. Una ISA describe un estado arquitectónico: lo que el software puede observar mediante instrucciones y reglas documentadas. La implementación puede conservar cachés, predictores, colas o buffers que afectan rendimiento y, en algunos contextos, observabilidad, pero no forman parte del mismo contrato. El manual de Intel expone registros, organización de memoria y ejecución; la especificación no pretende que un volcado de memoria revele todas las estructuras internas. Intel SDM, Vol. 1, revisión 093, §§3.3–3.5
Una ISA alternativa ayuda a evitar una generalización indebida. RISC-V define un conjunto de registros y una memoria accesibles conforme a su contrato, con reglas para que cada instrucción produzca efectos sobre ese estado. RISC-V Unprivileged ISA, §§1.1–1.3 El nombre de un registro, el ancho de una palabra y ciertas excepciones cambian entre arquitecturas. Lo que se conserva es el método: declarar la abstracción antes de razonar.
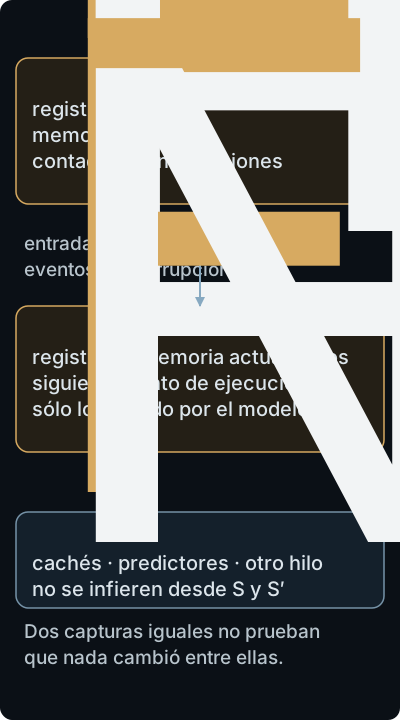
Dos capturas iguales en sus extremos no excluyen cambios intermedios ni cambios en estado no observado.
Un estado también tiene una frontera temporal. “El proceso tenía el registro R en 5” puede significar que una captura lo observó en un instante, no que el registro mantuvo 5 durante toda la operación. Una interrupción pudo modificarlo y restaurarlo; otro hilo pudo alterar memoria relacionada; la captura pudo pausar sólo una parte del sistema. La procedencia debe conservar momento, método, arquitectura, identificador de ejecución y cobertura.
Transiciones, entradas e invariantes
Una transición relaciona un estado previo con uno posterior mediante una operación y las condiciones que la acompañan. En forma abstracta:
Estado siguiente = T(estado actual, entrada, eventos del entorno).
S es el estado incluido por el modelo; I una entrada, como un octeto recibido o un valor de registro; E eventos ambientales, como una interrupción o una señal de tiempo; y T la regla que describe efectos y precondiciones. No es una afirmación de determinismo universal. Si el modelo omite un evento, dos ejecuciones con el mismo S visible pueden producir observaciones distintas. Declarar esa omisión es más riguroso que llamar “aleatorio” al sistema.
Una invariante es una propiedad que el modelo espera preservar en un conjunto de transiciones. Por ejemplo, en un parser, “la posición no supera el final del buffer” puede ser una invariante; en un contador, “el valor permanece dentro del rango representable” puede ser otra. Una invariante es útil sólo con dominio y mecanismo: si el tamaño se calcula en otra unidad, si el buffer cambia entre comprobación y uso o si la observación no cubre todos los hilos, la frase no basta para validar seguridad.
El paso profesional va de observación a hipótesis y luego a prueba. Supóngase una traza que registra que un índice vale 12 antes y después de una llamada. La observación no demuestra que la llamada no escribió fuera del índice: podría haber cambiado memoria no registrada, haber restaurado el índice o haber ejecutado una ruta alternativa. Para sostener una invariante hay que identificar la transición relevante, los estados que cubre y qué evidencia detectaría una violación.
Serializar es cruzar una frontera de significado
Serializar es convertir una estructura o valor en una secuencia para almacenarlo o transportarlo. Deserializar aplica la transformación inversa bajo un contrato. El contrato debe resolver ancho, orden, codificación, longitud, valores reservados, versión y tratamiento de entradas inválidas. Si el emisor y el receptor difieren en cualquiera, pueden aceptar los mismos bytes como estados distintos.
Considere un mensaje sintético de 8 octetos: cuatro para length y cuatro para kind. El emisor usa big-endian y limita length a 1024. El receptor lee little-endian y convierte el campo a una variable más pequeña antes de multiplicarlo por el tamaño del registro. Hay al menos tres preguntas separadas:
- ¿La secuencia capturada está completa y alineada con el inicio del mensaje?
- ¿Qué valor obtiene cada extremo bajo su propia representación?
- ¿Qué comprobaciones aplican antes de reservar, copiar o cambiar de estado?
La primera es de procedencia y framing; la segunda, de representación; la tercera, de transición y propiedad. Llamar “inyección” al resultado antes de responderlas fusiona capas diferentes. El defecto puede ser una especificación ambigua, una implementación incompatible, una conversión de rango o una entrada dañada. Cada hipótesis necesita evidencia distinta.
La serialización también puede cambiar estados legítimos. Un valor ausente, cero, cadena vacía y valor por defecto no son intercambiables sólo porque compartan una representación corta. Cuando una firma se calcula sobre bytes serializados, productor y verificador necesitan el mismo contrato sobre qué representación cubre la firma. Un ejemplo concreto es JSON Canonicalization Scheme: RFC 8785 define una representación canónica y advierte que los datos deben conservarse sin cambios entre análisis y serialización; firmar una forma y ejecutar otra rompe la correspondencia que se pretendía autenticar. RFC 8785, §§2–3 Esto no autoriza la regla universal «normalizar siempre»: otros protocolos firman los bytes recibidos o definen transformaciones distintas. La decisión debe derivarse de la especificación concreta y aplicarse antes de atribuir autenticidad semántica.
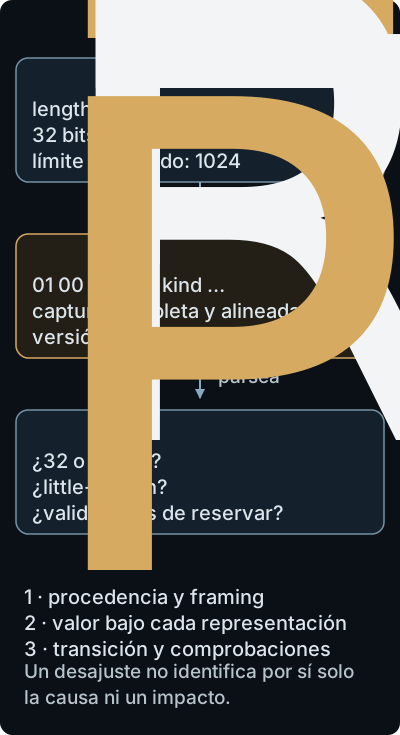
El esquema localiza preguntas; no atribuye por sí solo la causa ni el impacto de una discrepancia.
Qué cuenta como observación de estado
Los artefactos de una investigación responden preguntas diferentes. Un volcado de memoria muestra octetos en un espacio y momento determinados. Los registros añaden valores arquitectónicos y el punto de ejecución si la captura los incluye. Un log muestra lo que un componente decidió registrar, no todo lo que ocurrió. Una traza puede aportar orden relativo, pero su instrumentación y coste pueden modificar el comportamiento. Un bloque persistente muestra contenido después de una transición de escritura, no necesariamente el estado que existía antes de una caída.
Para hacer una inferencia defendible hay que conservar al menos:
- procedencia del artefacto y método de adquisición;
- arquitectura, versión y configuración que determinan la representación;
- momento, zona o identificador de ejecución y relación con otros artefactos;
- campos observados y campos omitidos;
- transformación aplicada para producir la vista humana;
- hipótesis alternativas que la evidencia no descarta.
Un mensaje de log que dice “length=1” no demuestra que el buffer recibido tuviera un octeto. El logger pudo haber usado una conversión, truncado el valor o registrado una variable posterior. La evidencia se vuelve más fuerte cuando se enlazan captura cruda, parser, registro y decisión, manteniendo la transformación auditable.
Límites del modelo y errores frecuentes
El primer error es confundir bits con significado. La corrección es escribir explícitamente “octetos observados” antes de escribir “valor interpretado”. El segundo es tratar una arquitectura como sinónimo de máquina completa. La corrección es declarar ISA, sistema operativo, procesos, dispositivos y almacenamiento que el modelo incluye. El tercero es llamar determinista a una ejecución porque una instrucción tiene efectos definidos. Entradas externas, interrupciones, concurrencia, reloj y errores pueden quedar fuera de la ecuación.
El cuarto es inferir persistencia desde memoria volátil. Un valor observado en un registro o buffer no demuestra que sobreviviera un reinicio o se escribiera en disco. El quinto es tomar una diferencia como corrupción. Cambios de versión, compresión, cifrado, normalización o una representación alternativa pueden explicar bytes distintos sin que exista pérdida de integridad. El sexto es tomar un hash como autenticación: detecta coincidencia bajo una referencia, pero el origen y la protección de esa referencia requieren otro argumento.
Un modelo útil debe declarar su abstracción y sus omisiones. Si el objetivo es explicar un desajuste de longitud, quizá no necesite modelar la caché del procesador. Si el objetivo es explicar una filtración por un canal lateral, esa omisión puede invalidar el análisis. La misma captura puede ser suficiente para una pregunta y claramente insuficiente para otra. Ésta es una aplicación directa de la disciplina de modelos del capítulo 7.
Uso profesional: de una alerta a una decisión
En triage de vulnerabilidades, el modelo de bits ayuda a separar un patrón sospechoso de una condición explotable. Se identifica el campo, su ancho, conversión y uso posterior; se formula la precondición para alcanzar la transición; se prueba el comportamiento con datos sintéticos y controles negativos; y se registra el impacto observado frente al potencial. El analista no necesita llamar “explotación” a todo desajuste para justificar una corrección.
En incident response, reconstruir estado significa encadenar fuentes. Un volcado puede mostrar un identificador; un registro de proceso puede ubicarlo; una traza puede situar la transición; y un artefacto persistente puede mostrar qué se conservó. Las fuentes no se suman como si fueran equivalentes: cada una aporta una vista con procedencia y cobertura. Si una transición clave quedó fuera de captura, la conclusión debe mantener esa limitación.
En revisión de protocolos, la pregunta central es si los extremos conservan el mismo significado. Se documentan formato, orden, codificación, rangos, valores reservados y errores. Luego se comparan implementaciones con mensajes válidos, límites y representaciones alternativas. Un resultado positivo demuestra que una ruta funciona; uno negativo puede revelar una incompatibilidad, pero no identifica por sí solo la causa.
En diseño, los estados e invariantes vuelven verificables las propiedades. En vez de “el parser es seguro”, se puede pedir “para cualquier longitud representable que acepte el formato, la posición final no excede el buffer y la conversión conserva el rango”. La afirmación aún necesita dominio, implementación y evidencia, pero ya relaciona una propiedad con transiciones que pueden revisarse.
Síntesis
Los bits son materia prima de representación, no significado autónomo. Un valor aparece cuando una regla fija ancho, orden, signo, codificación o formato; una estructura aparece cuando además se conoce la posición de sus campos. El estado es la parte de la máquina que un modelo incluye para explicar una pregunta; una transición conecta estados bajo entradas y eventos; una observación aporta evidencia parcial, fechada y situada.
La práctica segura consiste en conservar esas fronteras. No se confunde octeto con carácter, orden de bytes con valor, estado arquitectónico con toda la implementación, hash con autenticidad ni una traza con historia completa. Cuando una interfaz serializa datos, sus precondiciones deben viajar con el formato: el ancho, el orden y los límites son parte del significado.
Este modelo prepara los siguientes capítulos. CPU e instrucciones concretarán las transiciones; privilegios y cambio de contexto ampliarán el estado visible; memoria, procesos y aislamiento establecerán otras fronteras. La idea que permanece es sencilla y exigente: antes de interpretar un artefacto o afirmar una propiedad, declarar qué representación, qué estado, qué transición y qué evidencia hacen posible la conclusión.
Comprobación de comprensión
Explica por qué el patrón 0x41 no basta para afirmar que el programa recibió la letra A. ¿Qué contexto falta?
Respuesta razonada: Hay que conocer el ancho del campo, la codificación aplicada, el orden de bytes si participa un valor mayor, la posición del dato y la operación que lo consume. En ASCII o UTF-8 0x41 puede representar A, pero el mismo octeto puede ser parte de un entero, una longitud o datos opacos.
Construye un modelo mínimo de estado para un contador que lee un byte, incrementa un registro y escribe el resultado. Distingue estado previo, entrada, transición y estado posterior.
Respuesta razonada: El estado previo incluye contador, contador de programa y memoria relevante; la entrada es el byte leído y cualquier condición de lectura; la transición aplica la operación definida y actualiza registros, indicadores y memoria; el estado posterior contiene esos valores y el siguiente punto de ejecución. El modelo debe declarar qué elementos omite.
Compara representación big-endian y little-endian para los bytes 01 02 03 04. ¿Qué valor de 32 bits obtiene cada una?
Respuesta razonada: Big-endian coloca el byte más significativo primero y produce 0x01020304. Little-endian coloca el menos significativo primero y, al interpretar la misma secuencia como memoria de un entero de esa convención, produce 0x04030201. El valor no se puede discutir sin especificar la convención.
Un emisor envía una longitud de 32 bits y el receptor lee sólo 16. ¿Qué hipótesis debes probar antes de llamar al resultado un truncamiento?
Respuesta razonada: Hay que comprobar el formato pactado, el ancho real en ambos extremos, el orden de bytes, los límites permitidos, la conversión efectuada y si los dos bytes restantes pertenecen al siguiente campo. Sólo con esa evidencia puede distinguirse truncamiento de un formato distinto o de una captura incompleta.
¿Por qué un volcado de memoria no constituye por sí solo una reconstrucción del estado de la máquina?
Respuesta razonada: Un volcado es una observación parcial y temporal. Sin registros, contador de programa, arquitectura, mapa de memoria, información de concurrencia y procedencia no se sabe qué bytes estaban activos, qué hilo los interpretaba ni si pertenecen al momento causal relevante.
Un contador didáctico sin signo de cuatro bits conserva explícitamente sólo los cuatro bits inferiores de cada resultado. Parte de 13 y suma 5. Calcula el resultado matemático y el almacenado. ¿Podrías atribuir el mismo comportamiento a cualquier programa?
Respuesta razonada: La suma matemática vale18, representada como10010. La regla declarada conserva0010, cuyo valor es2: el resto módulo16. No es una regla universal del software; una operación real puede comprobar el rango, señalizar una condición o seguir reglas distintas según tipo, lenguaje e instrucción. El ejemplo prueba la consecuencia de este modelo declarado, no la existencia de una vulnerabilidad.
Una traza muestra el mismo registro en dos momentos, pero entre ellos hubo una interrupción. ¿Qué puede y qué no puede concluirse?
Respuesta razonada: Puede decirse que la observación registra el mismo valor en esos puntos bajo la convención de captura. No puede concluirse que el estado no cambió: la interrupción pudo modificar y restaurar el registro, cambiar memoria o alterar estado no observado. La conclusión debe incorporar la ventana y el mecanismo de captura.
Para revisar una alerta de integridad, ¿qué combinación de artefactos pedirías y por qué no basta un hash aislado?
Respuesta razonada: Pediría el artefacto, algoritmo y parámetros del hash, origen y momento de adquisición, referencia confiable con la que se compara, contexto de versión, registros de acceso y, si aplica, firmas o cadena de custodia. Un hash detecta diferencia bajo sus supuestos, pero no prueba por sí solo autenticidad, intención, ausencia de cambios antes de calcularlo ni significado del contenido.
Problema de transferencia
Una API registra payload_len=512, pero el servicio receptor rechaza algunos mensajes con el error “longitud fuera de rango”. El equipo entrega sólo una captura hexadecimal parcial y el log de la aplicación. Construye un plan de análisis: especifica qué metadatos y artefactos solicitarías, cómo comprobarías alineación, ancho, orden y codificación, qué transición del parser modelarías y qué conclusiones quedarían fuera de alcance si no se obtienen los registros del receptor. No supongas una arquitectura, protocolo, incidente o impacto que no estén documentados.
Fuentes principales
- Intel. Intel 64 and IA-32 Architectures Software Developer’s Manual, Volume 1: Basic Architecture.
- RISC-V International. The RISC-V Instruction Set Manual, Volume I: Unprivileged ISA, Version 20191213.
- IEEE. IEEE Std 754-2019: IEEE Standard for Floating-Point Arithmetic.
- NIST. FIPS 180-4: Secure Hash Standard.
- NIST. SP 800-160 Vol. 1 Rev. 1: Engineering Trustworthy Secure Systems.