Un programa no es sólo una transformación de valores: decide qué instrucción puede ejecutarse después, cuándo una ruta deja de ser válida y qué queda cierto si una operación no termina como se esperaba. El control de flujo es esa disciplina de selección y repetición. Las excepciones son una transferencia de control con reglas propias; un timeout o una cancelación son señales sobre el control, no pruebas automáticas de que el efecto externo no ocurrió.
Este capítulo continúa el modelo de estado y contratos de CC-0049 y el modelo de representación y errores de CC-0050. Aquí se estudia cómo las rutas preservan invariantes, cómo se abandona una ruta y cómo se comunica una pérdida parcial de certeza. No se enseña parsing (CC-0052), canonicalización (CC-0053), persistencia transaccional (CC-0054) ni concurrencia profunda (CC-0055). Cuando un ejemplo menciona una operación externa, importa su resultado y su frontera de control, no el protocolo o la base de datos concreta.
La ruta de ejecución es una hipótesis comprobable
El control secuencial ejecuta una instrucción después de otra. Esta descripción parece trivial hasta que se pregunta qué debe ser cierto entre pasos. Si reserve() debe ocurrir antes de copy(), el orden es parte del contrato; si copy() falla, no se puede inferir que release() haya ocurrido a menos que exista una ruta de cleanup verificable. Una ruta de ejecución es, por tanto, una secuencia con precondiciones, efectos y una condición de salida.
El control condicional selecciona una rama según una condición. La condición no es una explicación completa: hay que identificar qué estado observa, qué valores no puede distinguir y qué efecto tiene cada rama. Una comprobación de is_admin puede seleccionar una ruta, pero no prueba que la identidad se autenticara correctamente ni que el recurso pertenezca al principal. El tipo o el booleano son datos de control; la autorización sigue siendo una decisión contextual en el límite de confianza.
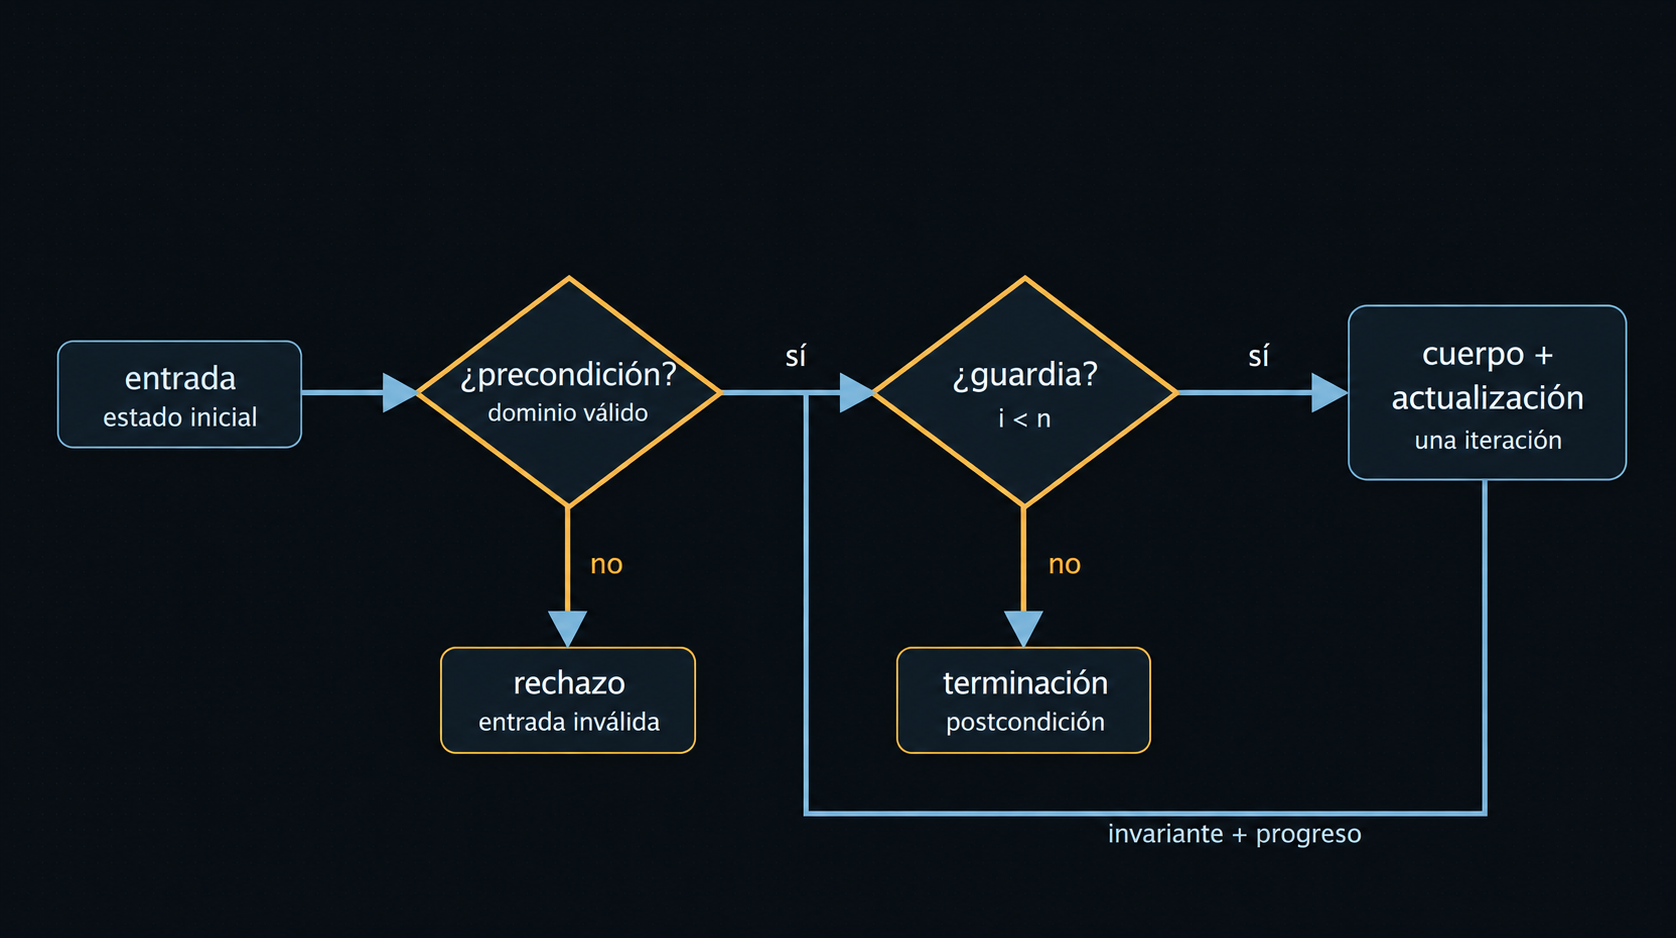
El control iterativo repite una región mientras una guardia lo permita. Para razonar profesionalmente sobre un bucle hacen falta tres piezas: una precondición antes de entrar, un invariante que se conserva después de cada iteración y una condición de terminación que pueda alcanzarse. El invariante no es un comentario decorativo. Por ejemplo, en una búsqueda sobre items, 0 <= i <= len(items) y «ninguna posición menor que i satisface el predicado» permiten justificar qué se ha descartado. La actualización debe producir progreso hacia la guardia falsa; un contador que nunca cambia conserva el invariante pero no termina.
Vista adaptada. Toca el diagrama para ampliarlo.
Terminación normal y no terminación
La terminación normal significa que una operación alcanza su salida declarada y devuelve un resultado dentro del contrato. No significa que el mundo externo haya aplicado todos los efectos imaginados. Una función que devuelve accepted puede haber aceptado sólo una petición local. La no terminación puede ser un bucle infinito, una espera sin límite o un bloqueo en una dependencia. Un timeout convierte una espera en una observación temporal: el llamador dejó de esperar bajo esa política, no que el receptor dejó de trabajar.
La prueba de terminación puede ser informal pero debe nombrar una medida: número de elementos restantes, pasos máximos o deadline. Si la medida puede aumentar, o si depende de un reloj no monotónico, la conclusión es incierta. Un límite de iteraciones evita una espera ilimitada, pero el resultado al agotarlo debe ser explícito (timed_out, incomplete o error), no un éxito vacío. En seguridad, un camino de excepción no debe saltarse una comprobación final sólo porque la ruta principal terminó.
Condiciones, invariantes y efectos
Una precondición describe lo que el llamador debe aportar; una postcondición describe lo que la operación promete si termina normalmente. Un invariante describe lo que permanece verdadero durante un tramo. Separarlos evita el error común de leer una comprobación local como garantía global. Para un procesador de lotes, un invariante razonable puede ser «cada elemento marcado done tiene un resultado persistido localmente»; no es «todos los efectos remotos se completaron», salvo que el contrato lo demuestre.
Un bucle que procesa entradas debe decidir qué hace con una entrada inválida: detenerse, omitirla con registro, devolver un resultado parcial o continuar con una política declarada. Continuar no es neutral: puede cambiar la relación entre posiciones y efectos. Detenerse tampoco deshace efectos previos. Las evaluaciones deben incluir el primer elemento inválido, el último elemento, la colección vacía y un elemento que cause un error después de otros éxitos.
Los invariantes también pueden ser negativos: «no se envía un secreto antes de autorización», «no se libera dos veces un recurso bajo este contrato» o «no se marca completo un trabajo sin evidencia de su salida». Es útil escribirlos antes del código, porque un catch amplio o un finally que sobrescribe un error puede romperlos sin alterar la ruta feliz.
Excepción como transferencia de control
Una excepción es un mecanismo del lenguaje o runtime que abandona el punto normal de una operación y busca un manejador según reglas de alcance, tipo y pila. El término no describe por sí mismo la causa ni la gravedad. Una excepción por entrada inválida, una interrupción del sistema y un bug pueden compartir sintaxis, pero exigen decisiones distintas. En lenguajes que no usan excepciones, un resultado etiquetado como Result, Either o error explícito representa la misma pregunta de diseño: ¿quién decide la ruta alternativa y con qué información?
La transferencia puede ser local o atravesar varias llamadas. Capturar significa interceptar la transferencia en un ámbito; propagar significa dejar que un ámbito superior decida; transformar significa cambiar la representación manteniendo causa, contexto y semántica; ocultar significa continuar o devolver un valor que borra el fallo. Capturar sólo para loguear y devolver [] es ocultación si el contrato no autoriza ese vacío. Una captura correcta identifica qué recuperabilidad tiene el contexto y qué invariantes conserva.
El desenrollado (unwinding) abandona marcos de llamada y puede ejecutar cleanup asociado a esos marcos. Rust documenta que, con estrategia unwind, los valores vivos que implementan Drop se limpian mientras la excepción de pánico atraviesa los marcos; la estrategia abort no ofrece esa trayectoria. Es una propiedad de ese lenguaje y configuración, no una regla universal. Python documenta que finally se ejecuta al salir del bloque por retorno, excepción u otra transferencia, aunque un error dentro de finally puede reemplazar el estado anterior. Estos ejemplos sirven para comparar contratos, no para declarar que toda excepción libera todo recurso.
Captura con causa y alcance
Un manejador debe poder responder cuatro preguntas: qué condición se capturó, qué estado se modificó, qué resultado se comunica y qué causa queda disponible para diagnóstico. Capturar una excepción genérica para mostrar un mensaje estable puede ser correcto en la frontera de usuario, si la causa se conserva internamente y se evita filtrar secretos. En una librería, capturar demasiado pronto impide que el llamador elija retry, abortar o compensar.
Transformar SocketTimeout en DependencyUnavailable puede mejorar el contrato si conserva causa, operación, deadline y si el efecto remoto quedó confirmado o no. Transformar en success no es recuperación: es falsear el estado. Un finally que retorna un valor puede ocultar una excepción pendiente en algunos lenguajes; debe evitarse salvo que el contrato lo requiera y la pérdida sea deliberada y auditable.
Cleanup, defer y RAII conceptual
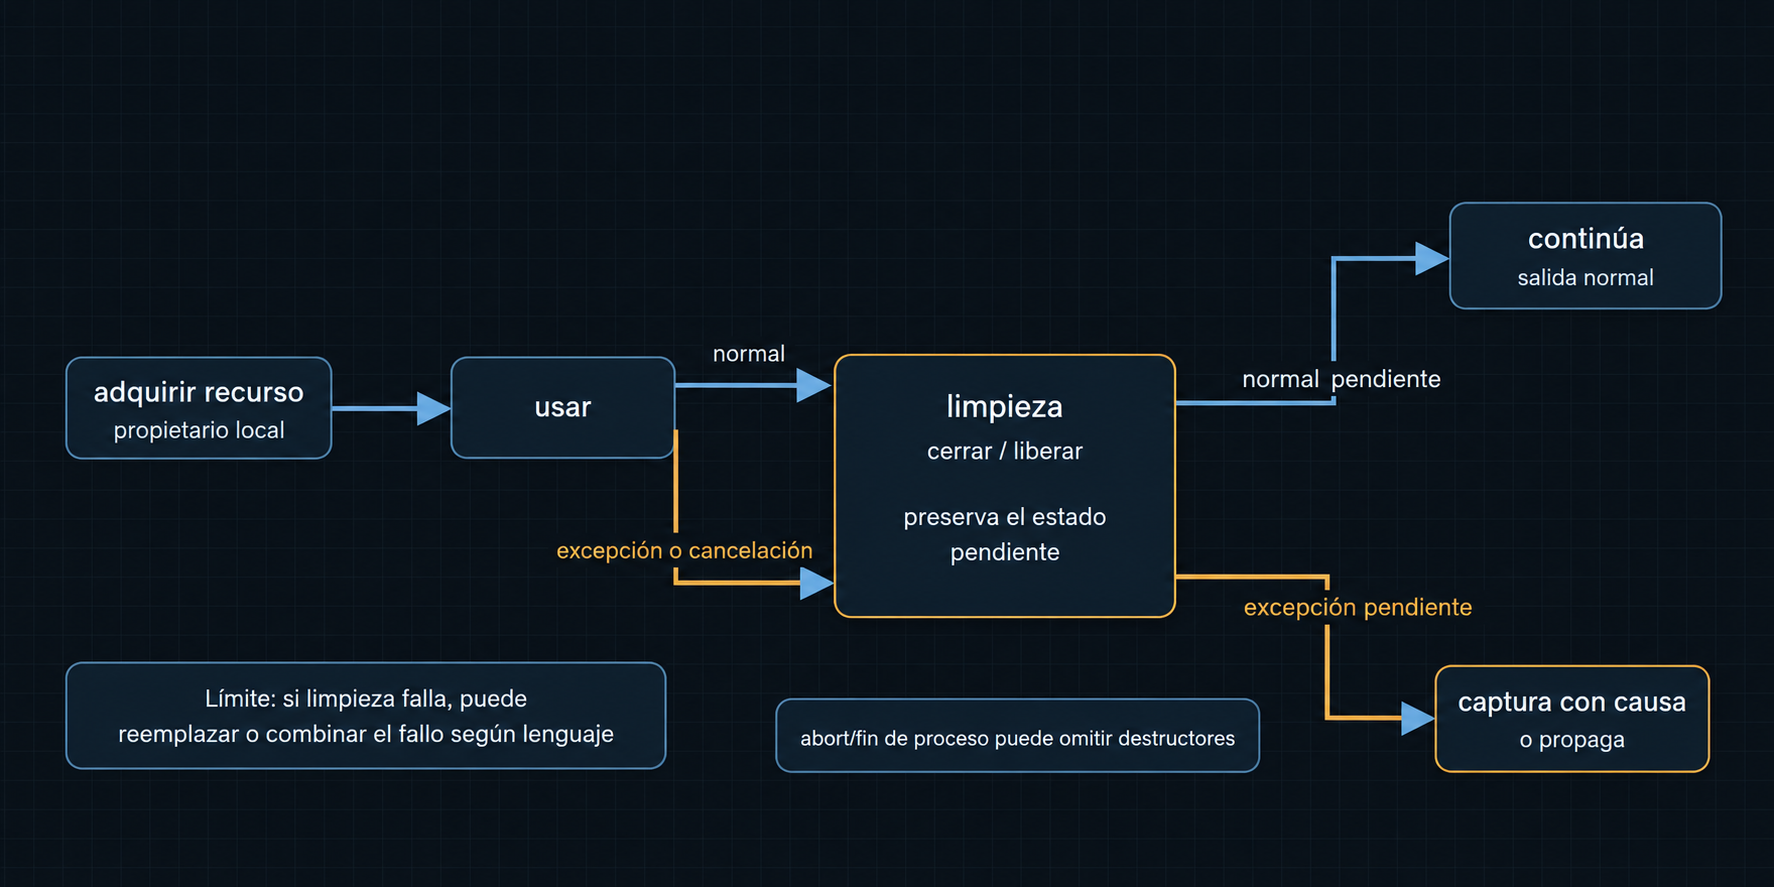
Cleanup es la acción que devuelve un recurso o estado al contrato de salida: cerrar un archivo, liberar una reserva, quitar una marca local o cancelar un registro temporal. defer (en lenguajes que lo ofrecen) registra una acción para el final del alcance; RAII (Resource Acquisition Is Initialization) vincula ownership conceptual y destrucción al lifetime de un objeto. Ambos reducen rutas olvidadas, pero no prueban que la operación de cierre haya tenido éxito ni que el recurso externo aceptara la liberación.
Hay que distinguir cleanup idempotente de cleanup que puede fallar. Cerrar dos veces puede ser tolerado por una API y error en otra. Si limpiar produce un segundo error durante el desenrollado, el programa necesita una política: conservar el error original, combinar causas o abortar. El cleanup no debe ejecutar acciones de negocio no reversibles sólo porque el control abandonó el ámbito. Un defer que confirma una transferencia, por ejemplo, no es una liberación; mezcla responsabilidades y hace difícil razonar sobre fallos parciales.
La propiedad de un recurso debe ser visible: quién lo adquiere, cuándo cambia el owner, qué ruta lo libera y qué pasa si la adquisición fue parcial. El patrón conceptual es acquire → use → release, con release en la ruta normal y en las salidas autorizadas. Si acquire devuelve una sesión pero falla al registrar su cierre, el estado no es «limpio» por defecto. La observación de que se llamó a close no prueba que el receptor la procesó.
Vista adaptada. Toca el diagrama para ampliarlo.
Cancelación y timeout
La cancelación es una solicitud o señal para dejar de continuar una operación. Puede ser cooperativa: el código observa la señal en puntos definidos y sale; o puede depender del runtime, con restricciones fuertes sobre qué cleanup se ejecuta. Cancelar una petición local no revierte un efecto ya enviado. Si una operación ignora la señal, el llamador debe reportar esa limitación, no afirmar que terminó.
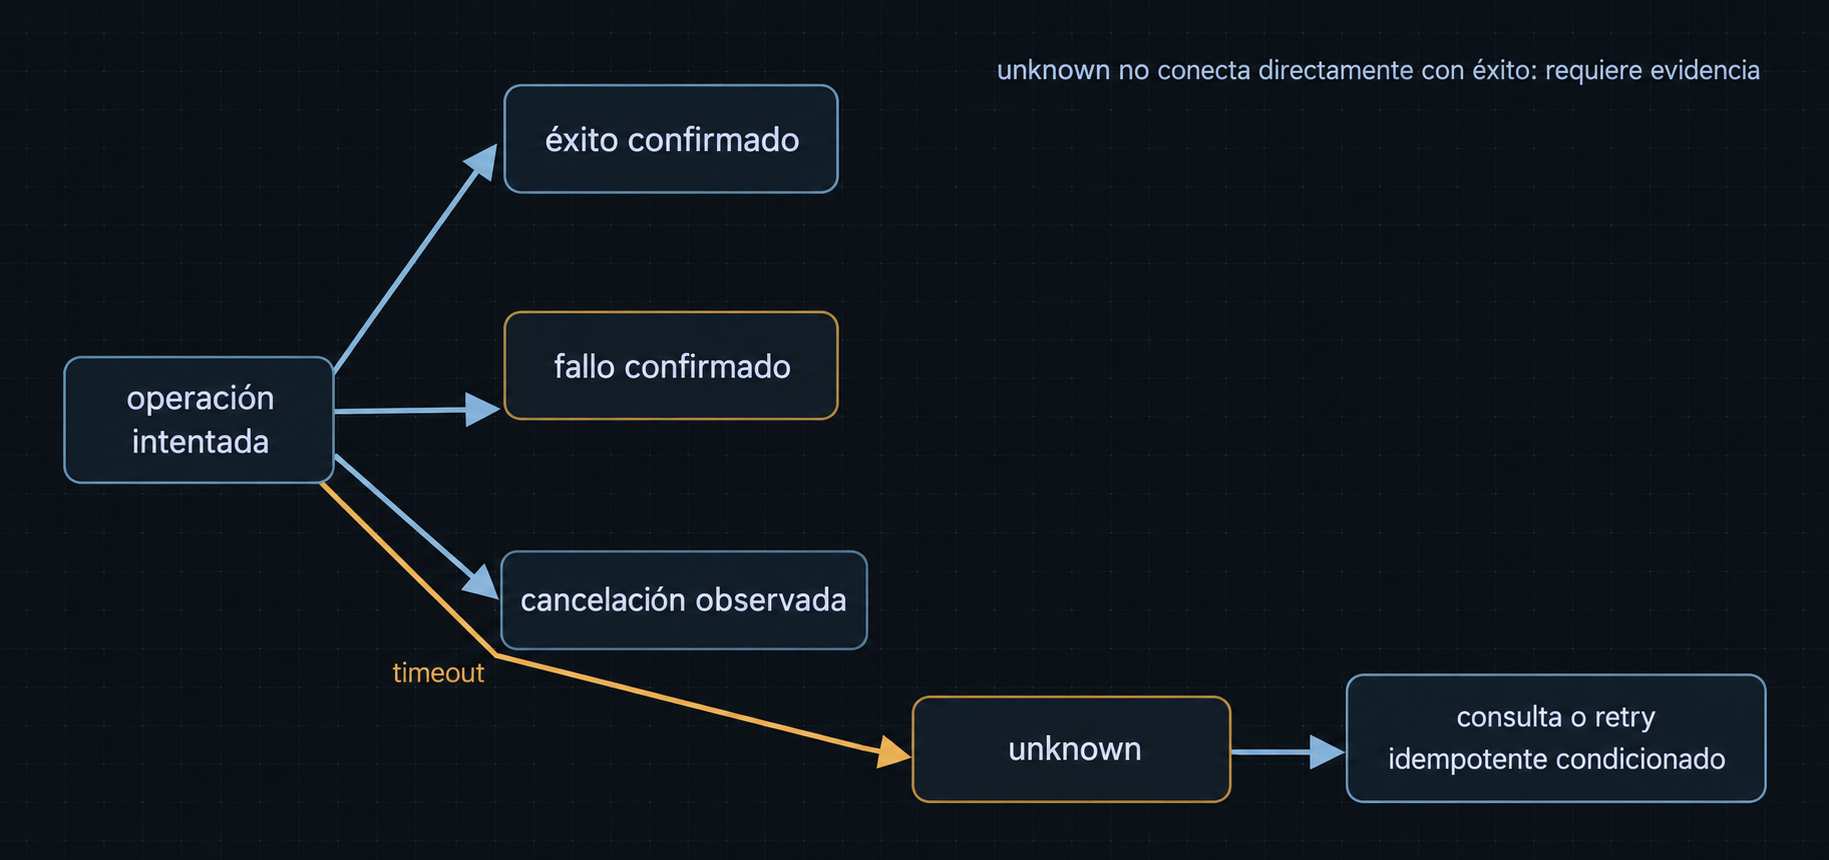
Un timeout es una decisión basada en tiempo: se agotó el presupuesto para esperar o ejecutar. No clasifica por sí mismo el resultado externo. Después de un timeout, el estado puede ser unknown: el mensaje quizá no llegó, quizá se procesó y la respuesta se perdió, o quizá terminó tarde. Reintentar a ciegas puede duplicar un efecto. La política segura es consultar estado, usar una operación idempotente con clave de deduplicación, o escalar a compensación cuando el dominio la define.
Los deadlines deben propagarse como límites y no como números mágicos separados por capa. Un cliente que tiene 100 ms y delega 90 ms no puede prometer 100 ms a la dependencia. El control de tiempo también requiere un reloj adecuado y una distinción entre cancelled, timed_out, failed y unknown. Un estado desconocido no es un fallo confirmado ni una autorización para continuar.
Fallos parciales: efectos y certeza
Un fallo parcial ocurre cuando una operación compuesta completa algunos pasos y no otros. «Parcial» se refiere a la relación entre efectos, no sólo a un porcentaje. En un lote de cuatro objetos, dos pueden haberse confirmado, uno rechazado y uno desconocido. Un booleano false no transporta suficiente información si el consumidor necesita decidir reintento o compensación.
Conviene modelar al menos not_started, in_progress, succeeded, failed_confirmed, cancelled y unknown. La transición debe registrar observación y procedencia: respuesta positiva, rechazo validado, deadline agotado o proceso perdido. La figura 3 muestra por qué unknown no conduce directamente a succeeded. Primero se necesita una consulta, una operación segura de repetir o una decisión humana/domain-specific.
Vista adaptada. Toca el diagrama para ampliarlo.
La compensación es una acción posterior que reduce o neutraliza un efecto anterior; no es un rollback mágico. Puede fallar, ser incompleta o tener semántica distinta. Si se creó una reserva y luego falló el cobro, cancelar la reserva puede ser una compensación; no borra necesariamente auditoría, notificaciones o efectos observados por terceros. La compensación debe tener precondiciones, límites, idempotencia y resultado visible.
Un sistema que continúa tras un fallo parcial debe explicar qué estado ofrece al consumidor. Puede devolver una lista de éxitos y errores con identificadores, dejar el trabajo reanudable, o detenerse y requerir reconciliación. Devolver sólo los éxitos sin advertir los desconocidos induce una conclusión falsa. Asimismo, marcar todo el lote como fallido no prueba que los efectos previos se deshicieran.
Caso conductor: importación con cuatro pasos
Considérese un servicio que recibe un lote de registros ya aceptado por una frontera previa. Por cada registro calcula un destino local, solicita una acción externa y registra un resultado. El bucle tiene el invariante «cada posición menor que i tiene un estado explícito» y una medida remaining = n-i. Antes de solicitar, valida que el estado local permite la acción; después registra succeeded, failed_confirmed o unknown.
En el registro 0 la acción tiene éxito. En el 1 el servicio recibe rechazo confirmado. En el 2 expira el deadline después de enviar la solicitud. En el 3 el proceso recibe cancelación cooperativa antes de iniciar. El resultado correcto no es false: es un informe con cuatro estados, causas y posibilidad de reanudación. El registro 2 requiere consulta o retry idempotente; el 1 quizá permite corrección de entrada; el 3 puede reanudarse; el 0 no debe repetirse sin una política de duplicación.
Si el código captura cualquier excepción dentro del bucle y continúa, conserva la disponibilidad del lote pero puede ocultar un bug de programación y romper el invariante de auditoría. La captura debe clasificar errores recuperables, conservar la posición, y dejar propagarse los que indican una violación interna. Si un cleanup local falla al cerrar el cliente, el resultado del registro debe reflejar esa incertidumbre adicional. El progreso del bucle no equivale a éxito del lote.
Método de diagnóstico y límites
- Congelar la observación: instrucción, estado de entrada, rama tomada, excepción o deadline y efectos observados.
- Nombrar el contrato de salida: resultado normal, error, cancelación, timeout o unknown; no inferir entre categorías.
- Reconstruir precondición, invariante, progreso y postcondición del tramo afectado.
- Enumerar recursos adquiridos y rutas de cleanup; separar «se invocó» de «se confirmó».
- Localizar la captura: qué contexto decidió, qué causa conservó y qué información pudo perder.
- Para efectos externos, comprobar idempotencia, consulta de estado, duplicación posible y compensación disponible.
- Probar camino válido, condición falsa, límite de iteración, fallo después de un éxito, cancelación y timeout.
La evidencia debe separar observación, interpretación, impacto confirmado, impacto potencial y unknown. Un log de timeout prueba que expiró una espera bajo un reloj; no prueba que el servidor no aplicara el efecto. Una prueba sin excepciones prueba una ruta feliz; no prueba que cleanup funcione durante desenrollado. La ausencia de un fallo observado no es evidencia de terminación universal ni de atomicidad.
Transferencia: tres decisiones distintas
Una tarea local que recorre un array, una operación que libera un recurso y una llamada que cruza una red pueden compartir una sintaxis de try/finally, pero no comparten garantías. En el array, la pregunta central es límite e invariante. En el recurso, es ownership y cleanup. En la llamada externa, es certeza del efecto y recuperación. El patrón visual o lingüístico no debe ocultar la frontera.
Al revisar código, escribe una tabla mínima: estado inicial, guardia, efecto, salida normal, salida excepcional, cleanup, estado externo y evidencia. Marca qué estados son confirmados y cuáles desconocidos. Pregunta qué ocurre si la condición cambia después de la comprobación, si la excepción atraviesa un ámbito, si cleanup falla o si la respuesta se pierde después del envío. Estas preguntas revelan defectos que una ruta feliz no muestra.
Contratos de salida y observabilidad
Un resultado de control es útil sólo si el consumidor puede distinguir sus significados. None, una lista vacía, cero y una excepción pueden representar ausencia válida, resultado vacío, valor numérico o fallo; la elección debe estar documentada. Para una operación que puede quedar incompleta, un tipo de resultado con estado, causa, identificador y evidencia es más honesto que un booleano. No hace falta que todos los lenguajes tengan tipos algebraicos para aplicar el principio: se puede usar un objeto de respuesta, un código y un registro estructurado, siempre que el contrato no deje estados implícitos.
La observabilidad también forma parte del control. Registrar que se tomó la rama timeout no requiere registrar payloads sensibles. El evento debe incluir operación, correlación, deadline y estado adjudicado, pero no convertir una sospecha en hecho: unknown_after_timeout es diferente de remote_failed. Si el sistema reanuda un trabajo, el nuevo intento debe enlazarse con el intento anterior; de lo contrario, la auditoría puede contar dos veces un efecto o perder la relación causal. Logs y métricas ayudan a reconstruir rutas, pero no sustituyen una garantía de atomicidad o una consulta de estado.
En una revisión, la métrica «errores = 0» sólo indica que una clasificación no registró errores. Puede esconder capturas amplias, timeouts contados como cancelaciones o resultados unknown descartados. Una métrica más informativa separa terminación normal, rechazo validado, excepción no recuperable, cancelación, timeout y reconciliación pendiente. Las etiquetas deben conservar cardinalidad razonable y no exponer secretos; la granularidad útil es la que permite decidir el siguiente paso.
Control negativo y pruebas de frontera
El control negativo es una ruta diseñada para demostrar que un límite se aplica. Para un bucle, se prueba la colección vacía, un único elemento, el máximo permitido y un caso que no progresa. Para una excepción, se induce un error de dependencia después de adquirir el recurso y se comprueba que cleanup ocurre sin sustituir silenciosamente la causa. Para cancelación, se solicita antes de iniciar, durante la espera y después de enviar; los tres puntos pueden tener estados distintos. Para un timeout, se verifica tanto una respuesta tardía como la consulta de estado posterior.
Estas pruebas no convierten el comportamiento en universal. Demuestran el contrato de la versión, runtime y configuración ensayados. Un runtime puede ejecutar cleanup al desenrollar y otro puede abortar; una biblioteca puede garantizar idempotencia y otra no. Por eso el informe de prueba debe registrar contexto, no sólo «pasa». Si una frontera no puede observarse, se debe marcar pendiente o unknown en lugar de inventar una conclusión.
Un caso especialmente importante es el error después de un efecto local. Supóngase que el sistema incrementa un contador, envía una notificación y falla al guardar el estado de auditoría. Repetir toda la función puede duplicar la notificación; omitir el retry puede perder trazabilidad. El diseño debe decidir qué efecto es fuente de verdad, qué operación es deduplicable y qué reconciliación se ejecuta. El control de flujo sólo organiza esas decisiones; no las resuelve por sintaxis.
Errores de modelado frecuentes
Un primer error es usar finally como una zona de éxito. Cleanup debe dejar el recurso en una condición válida o documentar que no pudo hacerlo; no debe rellenar el resultado principal por conveniencia. Un segundo error es tratar toda excepción como entrada inválida. Los bugs internos, las dependencias caídas y los límites de usuario tienen rutas de recuperación y niveles de exposición diferentes. Un tercero es llamar «rollback» a una acción que sólo envía una segunda petición y no confirma el estado anterior.
Otro error es deducir la ruta a partir de una línea aislada. La semántica depende de scopes, defer/destructores, excepciones anidadas, orden de evaluación y contrato de la llamada externa. Incluso cuando el código es secuencial, un proceso puede terminar entre el envío y el registro. La reconstrucción debe incluir los puntos de salida implícitos: retorno temprano, excepción, deadline, señal de cancelación y terminación del proceso.
Finalmente, no se debe elegir «continuar» o «detenerse» como dogma. Continuar maximiza trabajo completado cuando cada elemento es independiente y los estados quedan visibles. Detenerse puede proteger una invariancia global cuando un paso posterior depende de todos los anteriores. La decisión se justifica con dependencias, reversibilidad, coste y evidencia, no con una preferencia de estilo.
La misma cautela aplica a los nombres de estado. completed puede significar que terminó el código local, que se recibió una respuesta o que se verificó el efecto; son hechos distintos. Un contrato claro nombra el nivel («locally_recorded», «remote_confirmed», «reconciliation_pending») y evita que una etiqueta corta arrastre una garantía no demostrada. Esta precisión es especialmente importante en revisiones de seguridad, donde un estado ambiguo puede hacer que un control aparente cubra una ruta que nunca observó.
Síntesis
El control de flujo es una afirmación sobre rutas: cada rama necesita una condición, cada bucle un invariante y una medida de progreso, y cada terminación una postcondición con alcance explícito. Una excepción o cancelación transfiere control; no clasifica automáticamente el estado externo. Cleanup, defer y RAII vinculan acciones de liberación al alcance, pero sus propias fallas y límites deben permanecer visibles. Un timeout puede dejar unknown; un fallo parcial requiere estados, evidencia y una política de consulta, retry idempotente o compensación.
La consecuencia profesional es modesta pero decisiva: no rellenar incertidumbre con éxito. El capítulo 52 estudiará cómo una entrada adquiere estructura mediante parsing; el 54 estudiará atomicidad y persistencia; el 55 profundizará en interleavings y cancelación concurrente. Aquí queda el puente: antes de adjudicar impacto, reconstruir la ruta, el invariante, la transferencia de control y qué efectos están realmente confirmados.
Fuentes primarias
- ISO/IEC 9899:2011, draft público N1570 (2011), §§6.8 y 6.8.5: sentencias de selección e iteración, alcance y comportamiento. N1570.
- Python Language Reference, The try statement y The with statement, documentación vigente consultada 2026-10-05. Python reference.
- The Rust Reference, Panic y Destructors. Rust Reference, Destructors.
- The Rust Programming Language, capítulo 9, Error Handling:
Resultfrente apanic!. Rust Book. - IETF RFC 9110, §9.2.2, define la propiedad de idempotencia y su relación con retries. RFC 9110.
- Google, Site Reliability Engineering Workbook, se conserva sólo como guía secundaria de operación. SRE Workbook.