Mara y Bruno usan la aplicación móvil de una cámara doméstica. En ambos teléfonos, la pantalla de información muestra la versión 4.2.0. Mara sólo puede guardar grabaciones en la memoria local; Bruno también ve la opción de archivo remoto. La explicación inmediata sería que uno de los dos no tiene «la misma aplicación». Sin embargo, el número visible no basta para sostenerlo. También podrían diferir el sistema operativo, el artefacto construido para cada plataforma, la cuenta, la región, una opción local, el firmware de la cámara, una decisión del servicio remoto o una regla activada sólo para cierto grupo de usuarios.
Tampoco sabemos todavía cuál de esas posibilidades explica el caso. Esa cautela importa más que acertar por intuición. En sistemas reales, el comportamiento observado rara vez procede de una sola pieza llamada «el programa». Emerge de una composición: artefactos, configuración, datos, estado, plataforma, dependencias y contexto coinciden durante una ventana concreta. Dos ejecuciones con la misma etiqueta pueden formar composiciones distintas. Una sola ejecución puede cambiar de comportamiento sin reemplazar su artefacto.
Este capítulo construye un modelo para describir esas diferencias. Al terminar, el lector deberá poder preguntar qué estaba declarado, qué llegó al sistema, qué cargó la ejecución, qué se observó, quién podía cambiar cada pieza y durante qué intervalo. No aprenderemos todavía a resolver paquetes, producir inventarios de componentes, firmar artefactos, administrar una canalización de despliegue ni remediar vulnerabilidades. El objetivo es anterior: evitar que palabras como versión, configuración, actualización y rollback prometan más de lo que la evidencia permite afirmar.
El comportamiento pertenece a una composición situada
Como mapa inicial, podemos pensar en estas categorías:
artefacto ejecutable
+ configuración resuelta
+ datos y estado
+ plataforma
+ dependencias locales, transitivas y remotas
+ contexto de ejecución
→ comportamiento observado durante una ventana concreta
No es una fórmula matemática ni una enumeración exhaustiva. Sus elementos no son independientes y no siempre podemos observarlos todos. Un valor de configuración puede seleccionar una dependencia remota; la plataforma puede decidir qué artefacto se instala; el estado de una sesión puede conservar una decisión anterior. El mapa sirve para impedir una atribución demasiado rápida: si cambia el resultado, no debemos concluir que cambió el código antes de revisar las demás categorías.
El artefacto ejecutable es la pieza concreta que una máquina puede cargar: por ejemplo, un binario, un conjunto de módulos o una imagen preparada para ejecutarse. No es idéntico al código fuente ni al nombre comercial de la aplicación. La configuración resuelta reúne los valores que esa ejecución termina usando después de combinar las fuentes aplicables. Los datos y el estado incluyen tanto información persistida como condiciones temporales: una base de datos, una preferencia, una caché o una sesión pueden cambiar una ruta de comportamiento. La plataforma aporta capacidades y restricciones del sistema operativo, el runtime, el hardware o el entorno. Las dependencias suministran funciones que el artefacto no realiza por sí solo. El contexto de ejecución delimita, entre otras cosas, usuario, cuenta, región, petición, dispositivo y momento.
En el caso de la cámara, 4.2.0 podría nombrar la versión del producto móvil sin identificar de manera única el build instalado. Incluso si pudiéramos probar que el artefacto es idéntico, todavía quedarían abiertas la configuración, la cuenta, el servicio remoto y el firmware. El modelo no dice que todas esas piezas sean la causa. Dice que pertenecen al espacio de hipótesis y que cada una exige evidencia distinta.
La palabra decisiva es situada. Una composición no sólo pertenece a un dispositivo o una cuenta; pertenece también a un intervalo. Una opción puede haberse cargado al iniciar y permanecer igual durante toda una sesión, aunque la consola administrativa ya muestre un valor nuevo. Un servicio remoto puede haber cambiado entre dos pruebas. Un proceso antiguo puede continuar atendiendo solicitudes mientras otro ya usa el artefacto actualizado. Preguntar «¿qué versión tiene?» es un comienzo. La pregunta profesional es «¿qué combinación intervino en esta observación y cuándo?».
Configuración: datos que seleccionan comportamiento
La configuración no es únicamente una pantalla de preferencias. Es información que selecciona, limita o parametriza comportamiento. Puede indicar a qué servicio conectarse, si una capacidad está habilitada, cuánto tiempo conservar un dato o qué política aplicar. NIST SP 800-128 trata la configuración de un sistema en términos de componentes, ajustes y relaciones, y distingue la configuración de referencia de la configuración real que debe monitorizarse (NIST SP 800-128 Update 1, §§2.1.1, 2.3.7 y 3.4). La idea útil para este nivel es simple: describir un valor esperado no demuestra que una ejecución lo haya aplicado.
Conviene separar cuatro preguntas que suelen comprimirse en una sola:
- Declarado o deseado: ¿qué valor o composición pretende una persona, política o sistema de gestión?
- Distribuido o instalado: ¿qué archivos, parámetros o artefactos llegaron al lugar pertinente?
- Cargado o efectivo: ¿qué valor usa realmente esta ejecución después de resolver sus fuentes?
- Observado: ¿qué pudimos medir o reconstruir acerca de esa ejecución?
No son etapas obligatorias con esos nombres en todos los productos. Son posiciones desde las que se hacen afirmaciones diferentes. Una consola puede mostrar que remote_archive está habilitado para la cuenta de Mara: eso expresa un estado deseado. Si el teléfono aún conserva una respuesta cacheada, si la regla no se distribuyó o si la aplicación sólo lee el valor al iniciar, su proceso puede usar otra cosa. A la inversa, observar el botón de archivo remoto sólo demuestra que ese elemento se renderizó o fue visible durante esa ventana. No revela por sí solo qué fuente lo habilitó, si la función está disponible, si un intento alcanzaría el servicio ni si la operación podría completarse.
La configuración puede proceder de más de una fuente. Un programa podría combinar un valor incorporado, un archivo local, una política remota, un parámetro de inicio y datos asociados a una petición. No existe una precedencia universal entre esas fuentes. En un sistema, un parámetro de inicio puede sustituir al archivo; en otro, una política central puede imponerse después; en otro, las fuentes ni siquiera existen con esos nombres. Para conocer el valor efectivo hacen falta las fuentes aplicables, las reglas que las resuelven y el momento en que el consumidor las lee.
Esto permite entender por qué «el archivo dice X» es una observación incompleta. Puede que el archivo correcto no sea ése, que otro valor tenga prioridad, que la sintaxis sea inválida, que el proceso cargara una copia anterior o que el ajuste sólo afecte a una ruta distinta. Ninguna de esas explicaciones debe asumirse. Son ejemplos de preguntas que aparecen al separar declaración, distribución, carga y observación.
Un valor por defecto tampoco significa ausencia de configuración. Significa que un mecanismo elige cierto valor cuando se cumplen sus condiciones y ninguna fuente aplicable lo reemplaza. El default puede cambiar entre versiones, variar por plataforma o no ser apropiado para una función concreta. NIST advierte que configuraciones comunes pueden requerir adaptación a restricciones, funciones y roles locales (NIST SP 800-128 Update 1, Appendix F, ítems 2–3). Por eso default no es sinónimo de seguro, recomendado ni correcto para este entorno.
Una ruta distinta sin instalar otro artefacto
Una feature flag ofrece un contraejemplo útil al modelo «versión igual, comportamiento igual». Es un mecanismo que permite escoger condicionalmente entre rutas ya presentes en software desplegado. Su evaluación puede depender del sujeto y del contexto, y puede producir una variante, usar un valor por defecto o apoyarse en un resultado cacheado. Ése es el modelo definido por OpenFeature para su propio ámbito (OpenFeature Specification v0.9.0, Glossary y Evaluation Context, §3). No implica que todas las flags o aplicaciones funcionen exactamente así.
Podemos expresar el contraste de esta manera:
artefacto A + flag F + contexto de Mara   → ruta local
artefacto A + flag F + contexto de Bruno  → ruta remota
El artefacto puede ser idéntico y la etiqueta visible no cambiar. La diferencia aparece al evaluar un valor en cierto contexto. Quizá Bruno pertenece a una cohorte de prueba, tiene un plan distinto o está en una región donde el servicio existe. Quizá Mara conserva una evaluación anterior. Son hipótesis, no el diagnóstico del caso.
Este ejemplo añade cuatro preguntas. ¿Cuál fue el valor resuelto? ¿Qué datos de contexto intervinieron? ¿Quién o qué tenía autoridad para cambiar la regla? ¿Cuándo se evaluó? Mirar sólo el estado actual de una consola puede no reconstruir lo que recibió una sesión iniciada horas antes. Una explicación temporal necesita ligar el comportamiento con la evaluación relevante, no con el valor que vemos después.
La flag tampoco reemplaza todas las demás capas. Activar una ruta puede exigir una dependencia remota compatible, permisos para la cuenta y firmware capaz de producir el dato esperado. La configuración selecciona una posibilidad; no garantiza que toda la composición pueda realizarla.
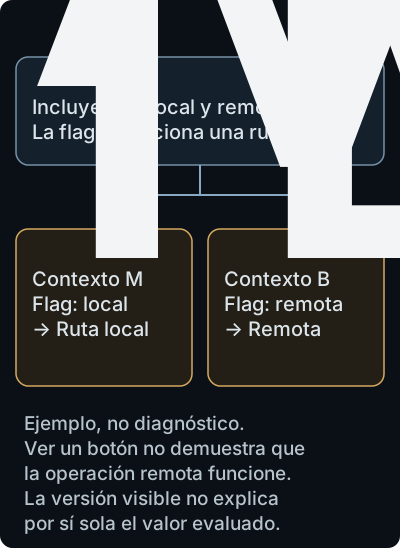
Ejemplo hipotético: contextos distintos pueden seleccionar rutas distintas en el mismo artefacto. Ver el botón no prueba que la operación se complete.
Versión de qué
Una versión es un identificador dentro de un esquema y un ámbito. Puede haber una versión de la aplicación, otra del artefacto, otra de una biblioteca, otra del formato de datos, otra de una API y otra del firmware. Algunas piezas se nombran con fechas, revisiones, canales o identificadores de despliegue en lugar de un número. Decir «el sistema es versión 4.2.0» oculta qué elemento recibió realmente esa etiqueta.
Semantic Versioning, o SemVer, muestra por qué el esquema importa. SemVer 2.0.0 propone major.minor.patch para productores que declaran una API pública y quieren comunicar clases de cambio respecto de esa API. Dentro de ese contrato, un incremento patch preserva compatibilidad de la API y corrige comportamiento; minor añade funcionalidad compatible; major admite cambios incompatibles (Semantic Versioning 2.0.0, introducción e ítems 1–8). No todos los productos adoptan SemVer. Escribir tres números separados por puntos tampoco demuestra que el productor cumpla sus reglas.
Incluso cuando SemVer se adopta correctamente, su promesa tiene frontera. Habla de la API pública declarada, no de toda conducta imaginable del sistema. Una actualización de dependencias internas puede conservar esa API. Una operación que dependía de un detalle no incluido en el contrato puede cambiar sin contradecir necesariamente la compatibilidad declarada. Antes de afirmar que una versión «rompió SemVer», habría que mostrar que el comportamiento roto pertenecía a la API pública aplicable.
SemVer separa además la precedencia de la identidad completa. La metadata de build puede distinguir versiones sin afectar la precedencia (SemVer 2.0.0, ítems 10–11). De ahí se deriva una cautela: igual precedencia no implica artefactos idénticos. Esa frase es una síntesis del contrato, no una garantía textual del estándar. Mucho menos implica misma plataforma, configuración o estado.
Una etiqueta tampoco demuestra procedencia, integridad, corrección o exposición a una vulnerabilidad. El valor 4.2.0 puede servir para comparar publicaciones dentro de un esquema; no prueba quién construyó el archivo, si fue alterado, qué dependencias contiene ni si la función observada es segura. Esas preguntas requieren mecanismos que estudiaremos más adelante. En este punto basta con rechazar una sustitución peligrosa: identificador de versión no equivale a identidad completa del sistema.
Por eso una comparación comienza con tres precisiones:
- ¿qué componente o interfaz está versionado?;
- ¿qué reglas dan significado al identificador?;
- ¿dónde y cuándo se obtuvo ese valor?
La versión mostrada por una interfaz, la registrada en un inventario y la informada por un proceso pueden coincidir. Si no coinciden, eso tampoco adjudica por sí solo un ataque o un defecto: primero hay que comprender qué nombra cada fuente.
Dependencias: un grafo, no una bolsa de paquetes
Una dependencia es un componente, servicio o capacidad cuyo comportamiento necesita el sistema dentro del modelo que estamos construyendo. La aplicación puede usar directamente una biblioteca B; B puede necesitar una biblioteca C que la aplicación nunca menciona. El artefacto puede depender además de un runtime o una capacidad del sistema operativo. Una ruta seleccionada por configuración puede llamar a un servicio remoto, y ese servicio depender de otro fuera de nuestra frontera visible.
Podemos dibujarlo como un grafo:
Aplicación A
├─ usa Biblioteca B
│  └─ B necesita Biblioteca C          (transitiva)
├─ necesita Runtime P                  (plataforma local)
└─ llama al Servicio S                 (remota)
   └─ S usa Servicio T                 (fuera de la frontera observada)
La dependencia de A sobre B es directa; la de A sobre C es transitiva. P pertenece al entorno local, mientras S cruza una frontera de comunicación. T puede afectar el resultado aunque el operador de A no pueda observarlo ni modificarlo. CycloneDX 1.7 es un ejemplo de modelo profesional capaz de representar componentes, servicios y relaciones directas o transitivas, además de declarar una composición incompleta o desconocida (CycloneDX 1.7, Components, Services, Dependencies y Compositions). Aquí tomamos de esa fuente la legitimidad del grafo; no estamos construyendo ni enseñando un SBOM.
El mapa tampoco prueba que cada arista se use en toda ejecución. Una dependencia puede ser opcional, propia de una plataforma o necesaria sólo cuando una flag activa cierta ruta. Que C aparezca en un inventario no demuestra que intervino en la solicitud de Bruno. Que T no aparezca no demuestra que no exista si nuestra vista del servicio remoto es incompleta. Un grafo declarado responde «¿qué relaciones conocemos o modelamos?». Una observación de ejecución responde «¿qué relación participó en este caso?».
Esta diferencia ayuda a localizar responsabilidad. El equipo de la aplicación puede seleccionar B, pero no controlar la operación diaria de S. El proveedor de S puede cambiar su implementación sin reemplazar ningún archivo en el teléfono. El operador de la plataforma puede actualizar P. Hablar de «las dependencias de la app» como si todas estuvieran empaquetadas, versionadas y controladas del mismo modo borraría fronteras técnicas y organizativas.
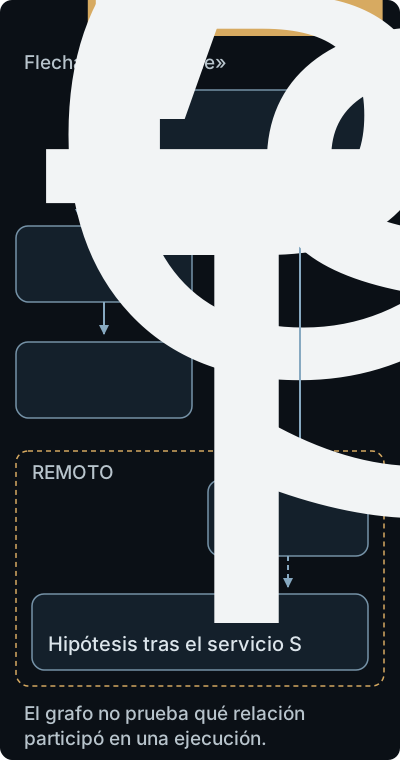
Las flechas indican dependencia, no ejecución observada. C es transitiva desde A; S es remota y la relación con T permanece como hipótesis no observada.
Compatibilidad respecto de una operación
«Compatible» no es un sello permanente adherido a una versión. Es una relación entre al menos dos extremos respecto de una interfaz, unos datos, una operación y un entorno. SemVer acota la compatibilidad hacia atrás a una API pública declarada. NIST, al tratar escenarios de respuesta al riesgo de una actualización, advierte que cambiar un componente puede exigir probar o actualizar otro software que interactúa con él (NIST SP 800-40 Rev. 4, §2.2, pp. 3–4 impresas). Ambas ideas impiden decir simplemente «4.2 es compatible» sin completar la frase.
Una afirmación comprobable se parece más a ésta: «el cliente A en la versión a pudo leer el formato X producido por el servicio B en la versión b, usando la interfaz I, en el entorno E y durante la prueba T». Esa precisión no es burocracia. Delimita qué resultado puede transferirse y qué permanece desconocido.
Imaginemos que la nueva aplicación conserva todos los mensajes de su API pública, pero actualiza una biblioteca que interpreta los metadatos de la cámara. La API puede seguir siendo compatible en el sentido declarado y, aun así, una familia de cámaras puede producir un dato que esa combinación interpreta mal. No concluimos que SemVer falló: primero debemos averiguar si ese comportamiento formaba parte de la API comprometida o de otra relación de compatibilidad.
También debemos separar disponibilidad de compatibilidad. Que una versión pueda descargarse, instalarse o arrancar no demuestra que lea datos anteriores, que coopere con el firmware presente o que preserve una operación importante. Y una incompatibilidad no dice por sí sola cuál extremo debe cambiar. La relación incluye a ambos y el contexto en que se encontraron.
No definiremos aquí una noción general de compatibilidad hacia adelante. Su significado depende de quién produce y quién consume, del formato o interfaz y de cómo se tratan extensiones desconocidas. Inventar una definición universal produciría más confusión que orientación.
Actualizar cambia el sistema que estamos evaluando
Una actualización no es un instante mágico en que v1 se convierte por completo en v2. NIST separa actividades como identificar o priorizar un cambio, adquirirlo, instalarlo y verificarlo (NIST SP 800-40 Rev. 4, resumen ejecutivo y §§2.2–2.3.4). Para razonar a nivel introductorio, podemos usar cinco preguntas:
- Disponible o identificado: ¿existe un cambio candidato para el componente pertinente?
- Obtenido: ¿el material llegó al equipo o a un punto de distribución?
- Instalado o distribuido: ¿cambió el contenido persistente o el estado que se pretende desplegar?
- Activado: ¿la ejecución relevante cargó el cambio?
- Verificado: ¿alguna observación demuestra que está activo y produce el resultado esperado dentro del alcance?
Ésta no es una máquina de estados normativa. Algunas tecnologías fusionan etapas; otras las reordenan o no usan todas. Una flag remota puede cambiar una ruta sin descargar un artefacto. Una aplicación puede instalar contenido nuevo pero continuar con el proceso anterior hasta reiniciarse. Un servicio remoto puede cambiar de manera unilateral. La secuencia es útil porque evita tratar como sinónimos afirmaciones que necesitan evidencias distintas.
Supongamos que el teléfono de Mara descargó 4.2.1. Eso demuestra obtención bajo alguna observación, no instalación. Si la pantalla de ajustes informa 4.2.1, quizá exista contenido instalado, pero aún debemos saber qué componente muestra el dato y si el proceso activo cargó ese artefacto. Si una prueba confirma la corrección buscada, hemos verificado esa propiedad en el alcance de la prueba; no todas las propiedades del sistema.
La actualización también modifica aquello sobre lo que se hicieron afirmaciones anteriores. Una prueba realizada con 4.2.0, cierta configuración y cierto firmware no se transfiere automáticamente a 4.2.1. Tampoco todo cambio es una remediación. Una versión nueva puede corregir un defecto, añadir una función, retirar compatibilidad o alterar una dependencia. «Más nueva» no significa por sí solo «segura», «adecuada» o «aprobada para este entorno».
La confianza en el material es otra pregunta. NIST trata la validación de autenticidad e integridad como actividad separada antes del despliegue (NIST SP 800-40 Rev. 4, §2.3.1). Obtener un archivo desde una fuente aparente no prueba automáticamente que sea el cambio esperado. Firmas, repositorios, attestations y procedencia pertenecen a capítulos posteriores; aquí sólo dejamos visible esa frontera.
Durante un despliegue puede no existir una sola versión efectiva
Un servicio lógico puede estar compuesto por varias instancias. Cuando se actualizan de manera gradual, durante cierto intervalo algunas pueden ejecutar la composición anterior y otras la nueva. Kubernetes ofrece un contraejemplo concreto: un Deployment con actualización gradual puede crear instancias nuevas mientras retira las antiguas, de modo que ambas revisiones coexisten temporalmente (Kubernetes v1.37, Updating a Deployment y Rolling Update Deployment). No necesitamos aprender Kubernetes ni deducir que todos los sistemas se actualizan así. Basta con abandonar la sustitución atómica como supuesto universal.
La heterogeneidad puede aparecer en más lugares. Algunos teléfonos reciben primero una publicación; un proceso conserva configuración cacheada; una sesión mantiene la ruta seleccionada antes del cambio; una región usa otro servicio; un dispositivo no puede adoptar aún el firmware requerido. En ese intervalo, decir «la organización ya está en v2» puede describir una intención o un porcentaje, pero no identifica qué composición atendió una interacción concreta.
Volvamos a la cámara. Bruno abre el archivo remoto a las 10:02 y funciona. Mara intenta lo mismo a las 10:04 y falla. Aunque ambos pertenezcan a la misma cohorte y muestren 4.2.0, las peticiones podrían haber alcanzado instancias diferentes durante una transición. También podrían diferir sus sesiones o dispositivos. La coexistencia amplía las hipótesis; no adjudica la causa.
Para describir un incidente necesitamos ligar la observación al punto atendido y al tiempo: qué instancia o dispositivo, qué artefacto cargado, qué configuración resuelta y qué dependencia respondió. Si no podemos observar una pieza, la marcamos como desconocida. Es preferible una explicación incompleta con límites honestos a una versión única inventada para todo el servicio.
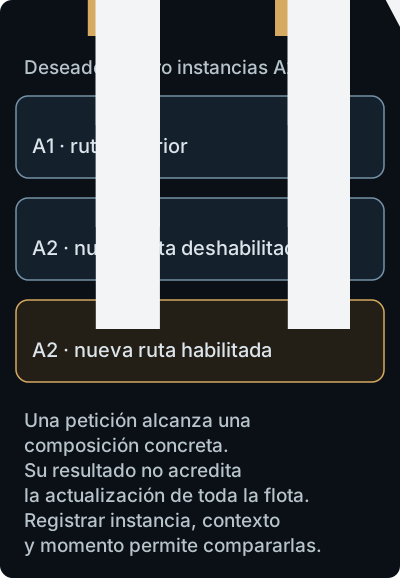
Instantánea del ejemplo de inventario: A1 y A2 coexisten y una flag distingue rutas. La nueva ruta se habilita para el contexto seleccionado, no necesariamente para toda petición.
Rollback no es borrar el cambio
Un rollback aplica una transición hacia una revisión anterior o una alternativa dentro del alcance que su mecanismo controla. Esa frase parece equivalente a «volver atrás», pero no lo es. El mecanismo puede revertir un artefacto sin restaurar datos, sesiones, mensajes enviados, acciones externas o decisiones de un servicio remoto.
El ejemplo de Kubernetes vuelve a ser útil sólo para fijar el límite: su rollback de un Deployment revierte la plantilla de las instancias que el mecanismo versiona (Kubernetes v1.37, Rolling Back a Deployment). No promete restaurar todo el estado de una aplicación. NIST también trata instalación, cambios de estado, reinicio, efectos secundarios y recuperación como preocupaciones separables. De ambas observaciones derivamos un principio general, marcado como síntesis: un rollback cubre aquello que su mecanismo versiona; no es una restauración universal.
Imaginemos que v2 escribe registros en un formato que v1 no comprende. Reinstalar el artefacto v1 puede completarse con éxito y, aun así, dejarlo incapaz de leer el estado persistido. Si v2 ya envió avisos externos, volver el binario no retira esos mensajes. Si una sesión obtuvo una capacidad temporal, el rollback del artefacto no demuestra que la sesión haya desaparecido. Si el servicio remoto también cambió, el operador local quizá no pueda revertirlo.
Por eso rollback, restauración, recuperación y reversión completa no son sinónimos. Para evaluar una reversión debemos enumerar carriles: artefacto, configuración, datos, esquema o formato, cachés, sesiones, efectos externos y dependencias remotas. Después preguntamos cuáles controla el mecanismo y cuál es la evidencia posterior. Una flecha v2 → v1 sólo describe el carril que realmente volvió.
El rollback tampoco recupera el pasado como si el cambio nunca hubiera ocurrido. Durante la ventana de v2 pudieron producirse datos, decisiones y observaciones. La transición hacia v1 crea una composición nueva: artefacto anterior más el estado que haya sobrevivido. Puede parecerse a la composición original sin ser idéntica.
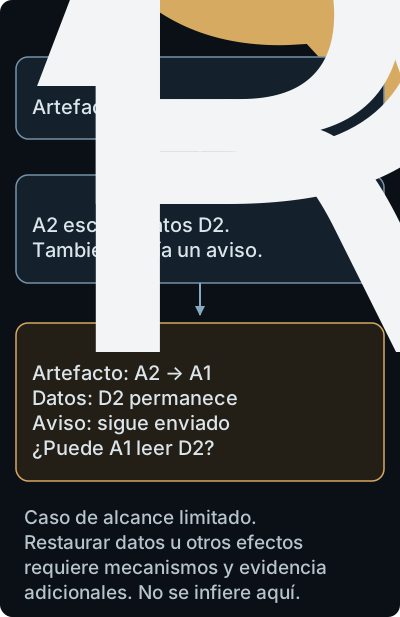
En este caso se revierte sólo el artefacto. Los datos escritos y el aviso enviado permanecen; la compatibilidad de A1 con D2 debe comprobarse.
Autoridad y evidencia están repartidas
No existe necesariamente un único actor capaz de cambiar todo el comportamiento. Un mantenedor publica un artefacto; una plataforma lo distribuye; un administrador elige configuración; una automatización activa una regla; un proceso carga valores; otro equipo opera el servicio remoto; un observador verifica una propiedad. NIST separa responsabilidades de gestión, control y monitorización de configuración (NIST SP 800-128 Update 1, §2.4), y el recorrido de actualización de SP 800-40 también distribuye actividades.
Cada acción requiere evidencia propia y permite sostener sólo una parte del recorrido:
- evidencia de publicación permite sostener que existe una propuesta identificada, no que se haya instalado;
- evidencia de distribución permite sostener que el material llegó a cierto punto, no que se activó;
- evidencia de una modificación de configuración permite sostener una intención o un estado en cierta fuente, no necesariamente el valor efectivo;
- evidencia de carga permite sostener qué usa un proceso, no que el resultado sea correcto;
- evidencia de verificación permite sostener una propiedad observada dentro del alcance y la ventana de la prueba;
- evidencia del servicio remoto puede mostrar un cambio de conducta sin que haya cambiado el cliente local.
Esta separación también delimita responsabilidad. El proveedor puede publicar una actualización sin poder instalarla en el teléfono. Mara puede aceptar la actualización sin controlar el firmware de la cámara. El equipo del cliente puede corregir su artefacto sin controlar el archivo remoto. Atribuir todo a «los desarrolladores» o «el sistema» oscurece quién podía realizar la transición pertinente.
La evidencia debe conservar el tiempo. Una baseline es una descripción acordada en un momento, no una lectura eterna del sistema. Una captura de una consola a las 11:00 no prueba por sí sola lo que un proceso cargó a las 10:00. Un registro de versión actual no reconstruye una instancia retirada. Cuando la conclusión importa, conviene formularla así: «durante la interacción I, observamos el artefacto A2 y el valor C7; la versión del servicio remoto no fue observable». El desconocimiento queda delimitado en vez de rellenarse con una etiqueta global.
Transferencia: un servicio de inventario durante el cambio
Consideremos ahora un servicio interno de inventario con cuatro instancias. El equipo desea actualizar el artefacto A1 a A2. La nueva ruta usa una revisión de biblioteca distinta y una feature flag la habilita sólo para un grupo de usuarios. Durante varios minutos conviven tres composiciones:
- dos instancias ejecutan
A1con la ruta anterior; - una ejecuta
A2, pero mantiene deshabilitada la nueva ruta; - una ejecuta
A2y activa la ruta nueva para la cohorte seleccionada.
Una empleada consulta un producto y obtiene un resultado correcto. Otro empleado repite la operación y recibe un error. «El servidor está en A2» no explica ninguno de los resultados. El nombre lógico servicio de inventario agrupa instancias efectivas distintas. La flag añade una división por contexto, y la biblioteca introduce una relación de compatibilidad que debe evaluarse para la operación concreta.
Para analizarlo, primero separamos lo deseado de lo observado. El estado deseado puede ser cuatro instancias A2; el estado distribuido puede incluir ya el artefacto en todas; el estado cargado muestra que dos procesos siguen con A1; la observación de una petición sólo alcanza una de las cuatro. Después anotamos el tiempo y la cohorte. Finalmente identificamos qué dependencia participó y qué evidencia sustenta la versión o configuración atribuida.
Supongamos que el equipo ejecuta un rollback del artefacto y deja las cuatro instancias en A1. Aún faltan preguntas. ¿La flag fue revertida? ¿La nueva biblioteca escribió estado que A1 debe leer? ¿Permanecen sesiones creadas durante la transición? ¿Algún sistema externo recibió acciones? La palabra rollback no responde; sólo nombra una operación cuyo alcance debemos inspeccionar.
El caso transfiere el modelo de la cámara a una arquitectura distinta. En ambos, una etiqueta nominal resulta insuficiente. La explicación necesita composición, contexto, tiempo, autoridad y evidencia. No hace falta dominar una plataforma de despliegue para formular esas preguntas correctamente.
Volver a Mara y Bruno
Ya podemos describir el caso inicial sin inventar su causa. Sabemos que ambas interfaces muestran 4.2.0. Esa observación identifica un valor expuesto por la aplicación, pero no prueba igualdad de build, plataforma o proceso cargado. Sabemos que Bruno ve archivo remoto y Mara no. Eso demuestra una diferencia de comportamiento en las ventanas observadas; no demuestra que el código sea distinto ni que exista un fallo.
Las hipótesis se ordenan por frontera:
- artefacto o plataforma: el mismo identificador de producto podría corresponder a builds o capacidades diferentes;
- configuración efectiva: una fuente local o remota podría resolver valores distintos;
- contexto: cuenta, región, dispositivo o cohorte podrían participar en una evaluación;
- estado temporal: caché, sesión o proceso podrían conservar una decisión anterior;
- dependencias: firmware o servicio remoto podrían ofrecer capacidades diferentes;
- ventana: alguna pieza podría estar en despliegue parcial.
Para avanzar, pediríamos evidencia específica: identificador del artefacto si existe, plataforma, valor efectivo o razón de evaluación de la flag, estado de sesión, firmware, respuesta del servicio y timestamps. No todas esas observaciones estarán disponibles, y ninguna lista es universal. El objetivo es reemplazar «son la misma versión» por comparaciones que nombren la pieza y el momento.
También podemos distinguir autoridad. El productor de la aplicación puede publicar 4.2.0; el operador del servicio remoto puede habilitar el archivo para una región; Mara puede cambiar preferencias locales; la plataforma puede decidir qué build instalar; la cámara puede ejecutar otro firmware. Una diferencia no implica engaño ni ataque. El capítulo siguiente añadirá vocabulario para defecto, fallo, abuso y ataque. Aquí sólo hemos establecido cómo describir el cambio antes de adjudicarlo.
Lo que ya puedes explicar
Ya puedes explicar por qué dos ejecuciones con la misma etiqueta pueden comportarse de modo distinto. Una versión nombra algo dentro de un esquema; no describe por sí sola la composición efectiva. Esa composición incluye artefacto, configuración resuelta, datos y estado, plataforma, dependencias y contexto durante una ventana.
También puedes separar cuatro planos que suelen confundirse: lo declarado o deseado, lo distribuido o instalado, lo cargado o efectivo y lo observado. Puedes justificar por qué una fuente de configuración no prueba el valor usado, por qué un default no es una recomendación y por qué la precedencia depende del sistema. Puedes reconocer que una feature flag puede cambiar la ruta sin instalar otro artefacto.
Puedes representar dependencias como grafo con relaciones directas, transitivas, locales y remotas; formular compatibilidad respecto de extremos, interfaz, operación y entorno; y dividir una actualización en preguntas sobre disponibilidad, obtención, instalación, activación y verificación. Finalmente, puedes explicar por qué una flota puede ser heterogénea y por qué un rollback no restaura automáticamente datos, sesiones ni efectos externos.
Fronteras que permanecen abiertas
El modelo es deliberadamente parcial. No presupone que toda configuración use archivos, variables, flags o una jerarquía concreta; un grafo declarado puede estar incompleto y una observación puede no revelar la ruta ejecutada. Tampoco convierte major.minor.patch en una garantía: no todos los productos adoptan SemVer, y una etiqueta no prueba procedencia, integridad, vulnerabilidad, corrección ni seguridad.
Disponible, obtenido, instalado, activado y verificado son preguntas pedagógicas, no una secuencia normativa universal. Declarado, distribuido, cargado y observado son posiciones conceptuales, no nombres que toda tecnología deba implementar. Las afirmaciones de compatibilidad quedan limitadas a la operación y al contrato examinados; sólo usamos compatibilidad hacia atrás en el sentido acotado de la API pública de SemVer y no definimos compatibilidad hacia adelante.
No hemos enseñado resolución de paquetes, lockfiles, producción de SBOM, firmas, attestations, CI/CD, estrategias de despliegue, migraciones de esquema, copias de seguridad, recuperación, firmware ni gestión de vulnerabilidades en profundidad. CycloneDX y Kubernetes aportaron contraejemplos que limitan el modelo simple, no procedimientos. Rollback continúa significando una transición de alcance comprobable, no restauración universal.
Por último, un cambio observado no adjudica defecto, fallo o ataque. Primero hay que fijar composición, autoridad, tiempo y evidencia; la intención y la clasificación causal pertenecen al siguiente paso del recorrido.
Comprobación
Un inventario informa que cuatro equipos tienen instalada la versión nueva. Dos procesos siguen activos desde antes de la instalación y una consola muestra que la función nueva está habilitada. ¿Qué puedes afirmar sobre los archivos, los procesos y la función? ¿Qué evidencia falta para concluir que los cuatro equipos usan el cambio?
Contrasta tu razonamiento
El inventario informa de instalación, no necesariamente de carga por los procesos. La consola informa de un valor en una fuente, no por sí sola de su evaluación efectiva. Hay que identificar qué cargó cada ejecución y qué configuración aplicó durante la operación pertinente. Que un proceso sea antiguo no demuestra automáticamente que no pueda recargar componentes: depende de su mecanismo. Una prueba satisfactoria sólo verifica su alcance, no toda la flota.
Ahora supón que la versión nueva escribió datos en otro formato y envió una notificación. El equipo vuelve al artefacto anterior. Explica qué podría seguir cambiado y por qué una reinstalación correcta no basta para demostrar recuperación del servicio.
Contrasta tu razonamiento
El artefacto anterior puede coexistir con datos nuevos que no sabe interpretar. La notificación ya enviada tampoco desaparece al revertirlo. Deben distinguirse la reversión del artefacto, la compatibilidad de los datos y los efectos externos. Recuperar el servicio requiere comprobar la operación esperada sobre la composición resultante.
Fuentes principales
- NIST, SP 800-128 Update 1, Guide for Security-Focused Configuration Management of Information Systems, actualización incorporada el 10 de octubre de 2019, §§2.1.1, 2.3.7–2.3.8, 2.4, 3.3–3.4 y Appendices B y F.
- NIST, SP 800-40 Rev. 4, Guide to Enterprise Patch Management Planning, abril de 2022, resumen ejecutivo, §§2.2–2.3.4, §3.4 y Appendix A.
- Semantic Versioning 2.0.0, introducción, especificación 1–11 y FAQ; consultada el 5 de octubre de 2026.
- OpenFeature, Specification v0.9.0, 29 de julio de 2026; Glossary, Provider §2.2 y Evaluation Context §3; consultada el 5 de octubre de 2026.
- CycloneDX, Specification 1.7 Overview, Components, Services, Dependencies y Compositions, release del 21 de octubre de 2025; consultada el 5 de octubre de 2026.
- Kubernetes, documentación v1.37 sobre Deployments, Updating a Deployment, Rolling Update Deployment y Rolling Back a Deployment, modificada el 7 de julio de 2026; consultada el 5 de octubre de 2026.
Comprobación
Un servicio interno tiene cuatro instancias. La consola administrativa muestra como estado deseado el artefacto A2 y la flag nuevo_calculo = activa. Una persona obtiene el resultado nuevo; otra, dos minutos después, recibe el resultado anterior. El equipo confirma que A2 ya fue distribuido a las cuatro máquinas, pero dos procesos no se han reiniciado. Una dependencia remota no expone su versión.
Construye una explicación que no reduzca el sistema a «está actualizado» o «no está actualizado». Distingue declarado o deseado, distribuido o instalado, cargado o efectivo y observado. Formula al menos cuatro hipótesis compatibles con los datos, asigna a cada una una ventana temporal y señala qué evidencia la apoyaría o la descartaría. Después responde:
- ¿Qué demuestra que
A2esté distribuido y qué no demuestra? - ¿Por qué dos respuestas distintas no prueban por sí solas un ataque ni un defecto?
- ¿Qué relación de compatibilidad concreta habría que comprobar si
A2cambia el uso de la dependencia remota? - Si el equipo hace rollback del artefacto, ¿qué estado debe examinar antes de afirmar que el sistema «volvió a A1»?
- ¿Cómo escribirías una conclusión que deje explícita la versión desconocida de la dependencia remota?