La concurrencia no es simplemente ejecutar más de un hilo. Es permitir que varias acciones avancen sobre estado compartido mientras sus pasos se intercalan, se observan o se hacen visibles en órdenes distintos. Una secuencia que funciona en una prueba puede fallar cuando cambia el interleaving, la latencia, el planificador o el aislamiento de una base de datos. El problema profesional es reconstruir qué relaciones causales existen y cuáles se han supuesto sin evidencia.
Este capítulo enlaza las transacciones e invariantes del capítulo 54 con el razonamiento de control, memoria y fallos del 51. El 54 explica qué estado debe conservar una operación y qué contrato ofrece el motor; aquí se estudia cómo dos operaciones compiten por ese estado. El 56 tratará distribución y protocolos entre nodos; aquí no se presenta una garantía local como si resolviera particiones, relojes o consistencia entre servicios.
Interleavings y happens-before
Un interleaving es un orden posible de pasos de acciones concurrentes. Si dos retiros leen el mismo saldo antes de escribir, una ejecución posible es R1-read, R2-read, R1-write, R2-write. No es la única ejecución ni una predicción: sirve para comprobar si el programa conserva sus invariantes ante todos los órdenes admitidos. Un diagrama debe mostrar operaciones y dependencias reales, no una película representativa presentada como universal.
La relación happens-before expresa orden causal, no sólo orden temporal observado. En el modelo de memoria de Java SE 21, una operación puede preceder a otra dentro del mismo hilo; una sincronización puede publicar escrituras. Si no existe relación de orden, dos accesos pueden ser concurrentes aunque un log los muestre en líneas consecutivas. El tiempo de registro no crea causalidad.
Vista adaptada. Toca el diagrama para ampliarlo.
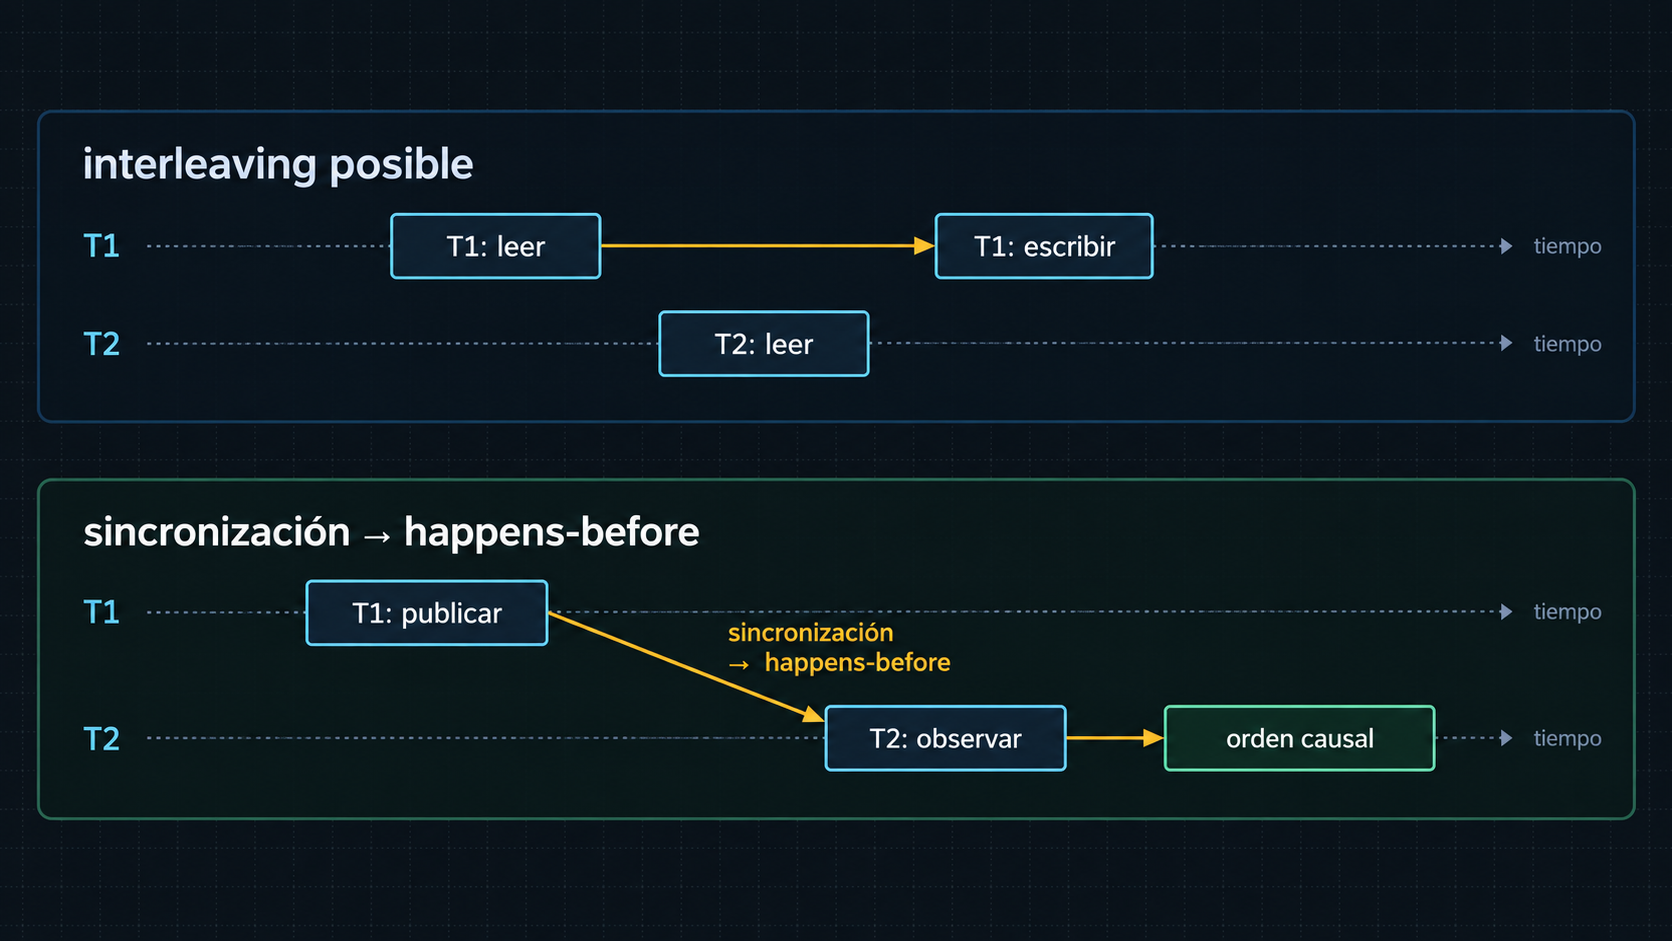
La figura (fig-0055-01) compara un interleaving peligroso con una sincronización que introduce happens-before. Las flechas representan dependencias declaradas, no una garantía derivada de que una ejecución concreta haya salido bien.
Para diagnosticar, enumere eventos: lectura, cálculo, escritura, adquisición, liberación, publicación, cancelación y commit. Después anote el recurso, el modo de acceso y las relaciones de orden. Un acceso concurrente puede ser intencional si el contrato lo permite; el defecto aparece cuando el resultado depende de un orden que no está protegido o cuando una observación se usa fuera del intervalo en que es válida.
Data race y race condition
Una data race es una categoría del modelo de memoria, no un sinónimo de cualquier carrera. En C++ [intro.races], la definición y consecuencias dependen del modelo formal; en otros lenguajes pueden existir restricciones distintas. Suele involucrar accesos concurrentes a la misma ubicación, al menos uno de escritura, sin sincronización requerida. La documentación del lenguaje, no una intuición sobre hardware, fija el contrato.
Una race condition es más amplia: el resultado o la seguridad depende del orden de eventos. Puede existir entre dos llamadas a una API, entre una comprobación y un uso, o entre transacciones que no comparten memoria. Un sistema puede no tener data race en sentido del lenguaje y aun permitir un check-then-use incorrecto. Inversamente, una operación atómica puede eliminar una data race sobre un contador, pero no preservar una invariante que relaciona saldo, límite y registro de auditoría.
La distinción evita dos errores. Primero, aplicar un mutex a todo y asumir que cualquier carrera de negocio desapareció. Segundo, llamar «race» a una posibilidad abstracta sin demostrar los accesos, el orden y el efecto. Un hallazgo debe indicar cuál categoría se probó, qué precondiciones la hacen alcanzable y qué estado puede quedar inconsistente.
Atomicidad, memoria y visibilidad
Atomicidad significa que una operación se observa como una unidad respecto del contrato elegido. No significa que una secuencia de varias operaciones sea atómica por estar escrita en una función. Visibilidad significa que una escritura publicada puede ser observada por otro agente según el modelo de memoria; no equivale a que una variable «se actualice inmediatamente» en todos los núcleos. Ordenamiento significa qué reordenamientos son permitidos. Son propiedades relacionadas pero distintas.
Un incremento x = x + 1 contiene lectura, cálculo y escritura. Hacer atómica sólo la lectura o sólo la escritura no hace atómico el incremento. Un compare-and-swap (CAS) compara un valor esperado y, si coincide, instala uno nuevo como una operación indivisible; el bucle que reintenta CAS todavía debe ser correcto ante cambios, overflow, cancelación y contención.
La memoria compartida necesita una publicación definida: lock/unlock, operación atómica con orden apropiado, canal, future o mecanismo equivalente. Un log que muestra que el productor escribió antes no prueba que el consumidor pudiera observar la escritura bajo el contrato del lenguaje. Para cada variable, documente propietario, sincronización, invariantes y vida útil. La seguridad de memoria del lenguaje tampoco concede seguridad de negocio.
Locks, composición y deadlock
Un lock protege una región según su ámbito y disciplina. Para ser útil, todos los accesos relevantes deben respetar el mismo protocolo; bloquear una referencia mientras otro camino escribe sin lock no preserva la propiedad. La granularidad cambia el coste y la contención: un lock global simplifica el razonamiento pero puede serializar el servicio; locks finos permiten más paralelismo y más órdenes posibles.
Un deadlock es una espera circular: cada participante retiene un recurso que otro necesita. La prevención puede imponer un orden global de adquisición, evitar retener locks durante llamadas externas, limitar tiempos de espera o diseñar operaciones sin bloqueo. Un timeout no prueba ausencia de deadlock: puede convertirlo en fallo parcial, duplicación de reintentos o estado desconocido. El diagnóstico debe capturar quién retiene, quién espera y desde cuándo.
Los locks no atraviesan automáticamente una base de datos, una cola o un proceso. Un lock de aplicación que protege una fila sólo tiene efecto si todos los escritores lo usan y si el ciclo de vida cubre el commit. El capítulo 54 conserva el contrato de transacción; aquí se comprueba si el lock y la transacción abarcan la misma invariante. Si una llamada remota ocurre dentro del lock, la latencia y cancelación amplían la ventana de contención.
La composición exige especial cuidado cuando una operación toma dos recursos. Un código puede ser correcto al proteger cada recurso por separado y fallar al transferir valor entre ambos si libera el primero antes de reservar el segundo. El orden global de locks debe ser parte del contrato compartido, incluidos caminos de error y funciones auxiliares. Si no puede imponerse ese orden, una alternativa es reducir el ámbito, usar una primitiva transaccional o detectar y deshacer con un resultado explícito.
También hay que distinguir exclusión de coordinación. Un lock puede impedir que dos hilos entren simultáneamente, pero no garantiza que un consumidor observe un estado completo si el productor publica referencias antes de inicializar todos sus campos. Una condición de espera debe asociarse a un predicado protegido y reevaluarse después de despertar; una notificación aislada no es evidencia de que el predicado sea cierto. Las bibliotecas documentan si una espera puede despertar espuriamente y qué sincronización establece.
Los locks reentrantes, lectores-escritores y semáforos tienen contratos distintos. Un lock reentrante puede ocultar una llamada recursiva costosa; un lector-escritor puede permitir inanición de escritores; un semáforo cuenta permisos y no necesariamente identifica al propietario que debe liberar. Elegir por nombre («más rendimiento», «más seguro») no sustituye declarar el recurso, la invariante y el comportamiento de fallo.
Optimistic concurrency y CAS
El control optimista no evita el conflicto; lo detecta. Una versión, etag o nonce acompaña al recurso. El escritor lee versión v y solicita actualizar sólo si continúa siendo v; si otro escritor cambió el recurso, la operación falla y el cliente debe volver a leer, fusionar o abandonar. El camino de éxito y el de conflicto tienen que estar diseñados simétricamente: ambos deben verificar autoridad, límites, invariantes y efectos de auditoría.
CAS ofrece la misma forma a menor escala: leer esperado, intentar comparar e instalar, y tratar el fallo como información. Un bucle CAS que reintenta sin límite puede producir inanición o agotamiento. Uno que recalcula sobre un valor obsoleto puede perder una actualización aunque nunca tenga una data race. El ABA problem muestra otra limitación: el valor puede volver a A después de pasar por B; una comparación sólo de valor no prueba que el estado intermedio no importara. Versiones o tags ayudan si el contrato los mantiene.
Vista adaptada. Toca el diagrama para ampliarlo.
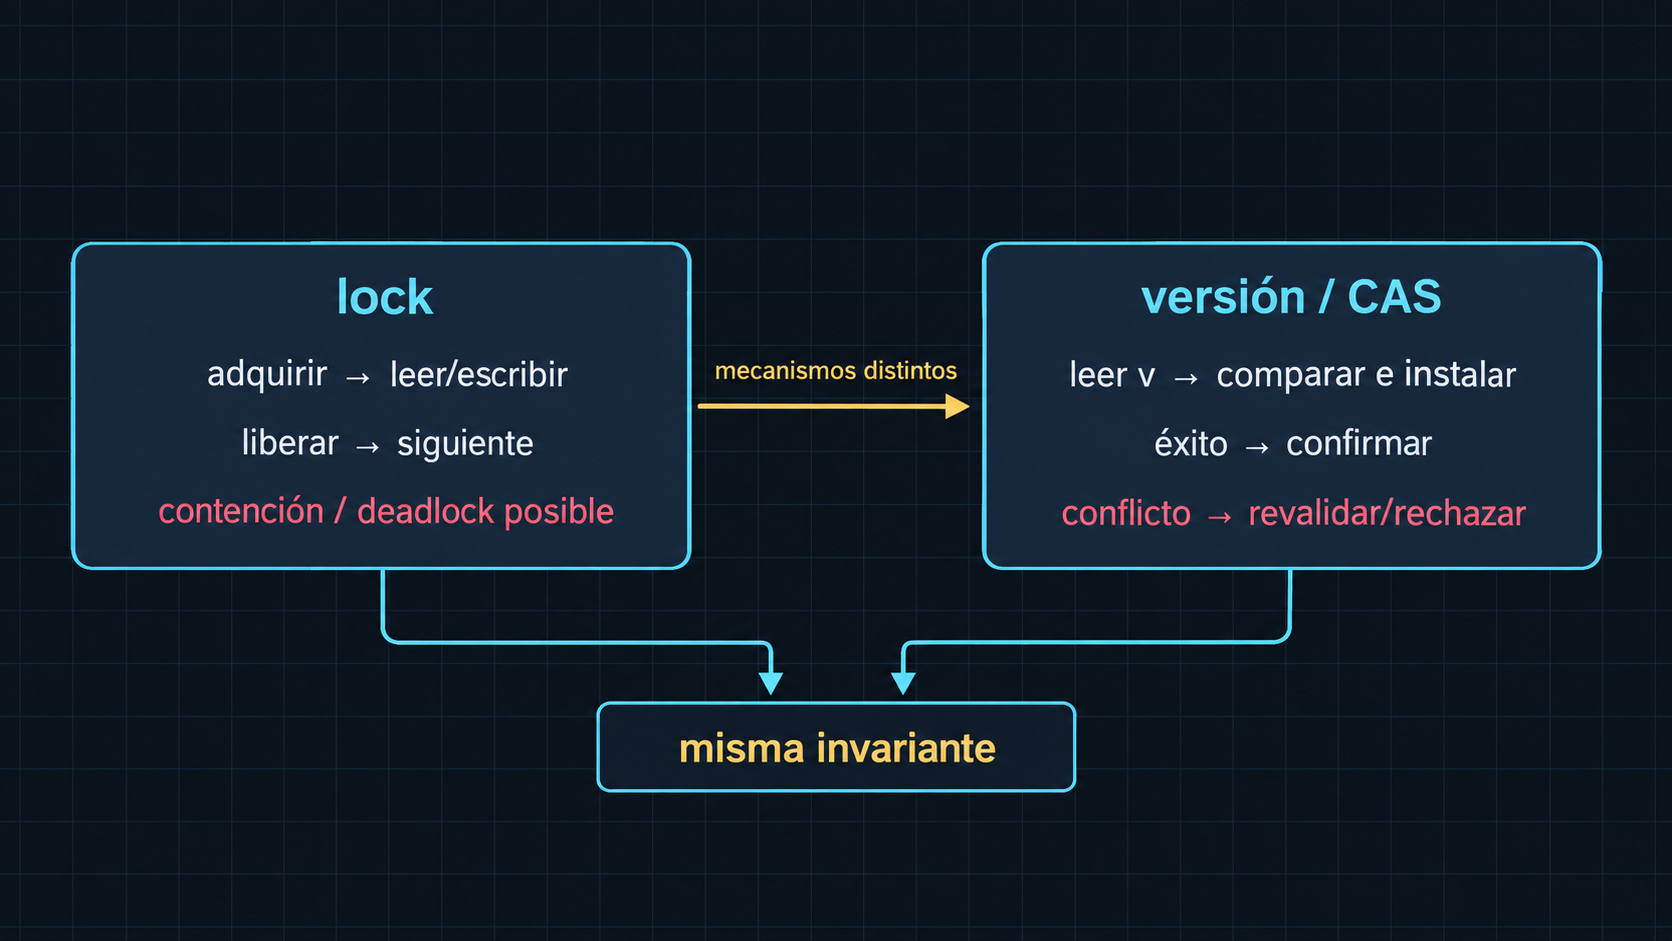
La figura (fig-0055-02) contrasta lock y versión/CAS. Ambos tienen camino de conflicto y ambos requieren comprobar la misma invariante al producir el efecto; CAS no es una autorización ni una transacción por sí solo.
La memoria también puede contener referencias a objetos cuyo ciclo de vida ya terminó. Un hilo que publica un puntero y otro que lo usa después de liberar el objeto tiene un problema de lifetime aunque la lectura parezca atómica. El orden de memoria no prolonga la vida del objeto. Las estrategias de ownership, conteo de referencias, hazard pointers o reclamación por épocas tienen precondiciones diferentes y deben elegirse junto con el modelo del runtime. Un garbage collector puede evitar ciertos accesos a memoria liberada, pero no impide que dos operaciones de negocio sobrescriban un valor.
La palabra «volatile» tampoco es una abreviatura universal de sincronización. En algunos lenguajes expresa interacción con memoria especial o evita ciertas optimizaciones, pero no necesariamente ofrece atomicidad, exclusión o una relación happens-before entre hilos. El contrato del lenguaje y de la biblioteca atómica debe ser la fuente. Del mismo modo, una variable declarada atómica no convierte automáticamente en atómico el conjunto de campos que una función actualiza.
Una operación linealizable es una abstracción útil para preguntar si cada llamada parece ocurrir en un punto entre su invocación y respuesta, pero no debe extrapolarse a una colección de llamadas sin probar su composición. Una cola linealizable puede combinarse con una base no linealizable y producir un workflow incoherente. Herlihy y Wing ofrecen un modelo de historial; el diagnóstico debe indicar cuál operación se pretende linealizar y qué observaciones la contradicen.
Aislamiento, lost update y consistencia
Vista adaptada. Toca el diagrama para ampliarlo.
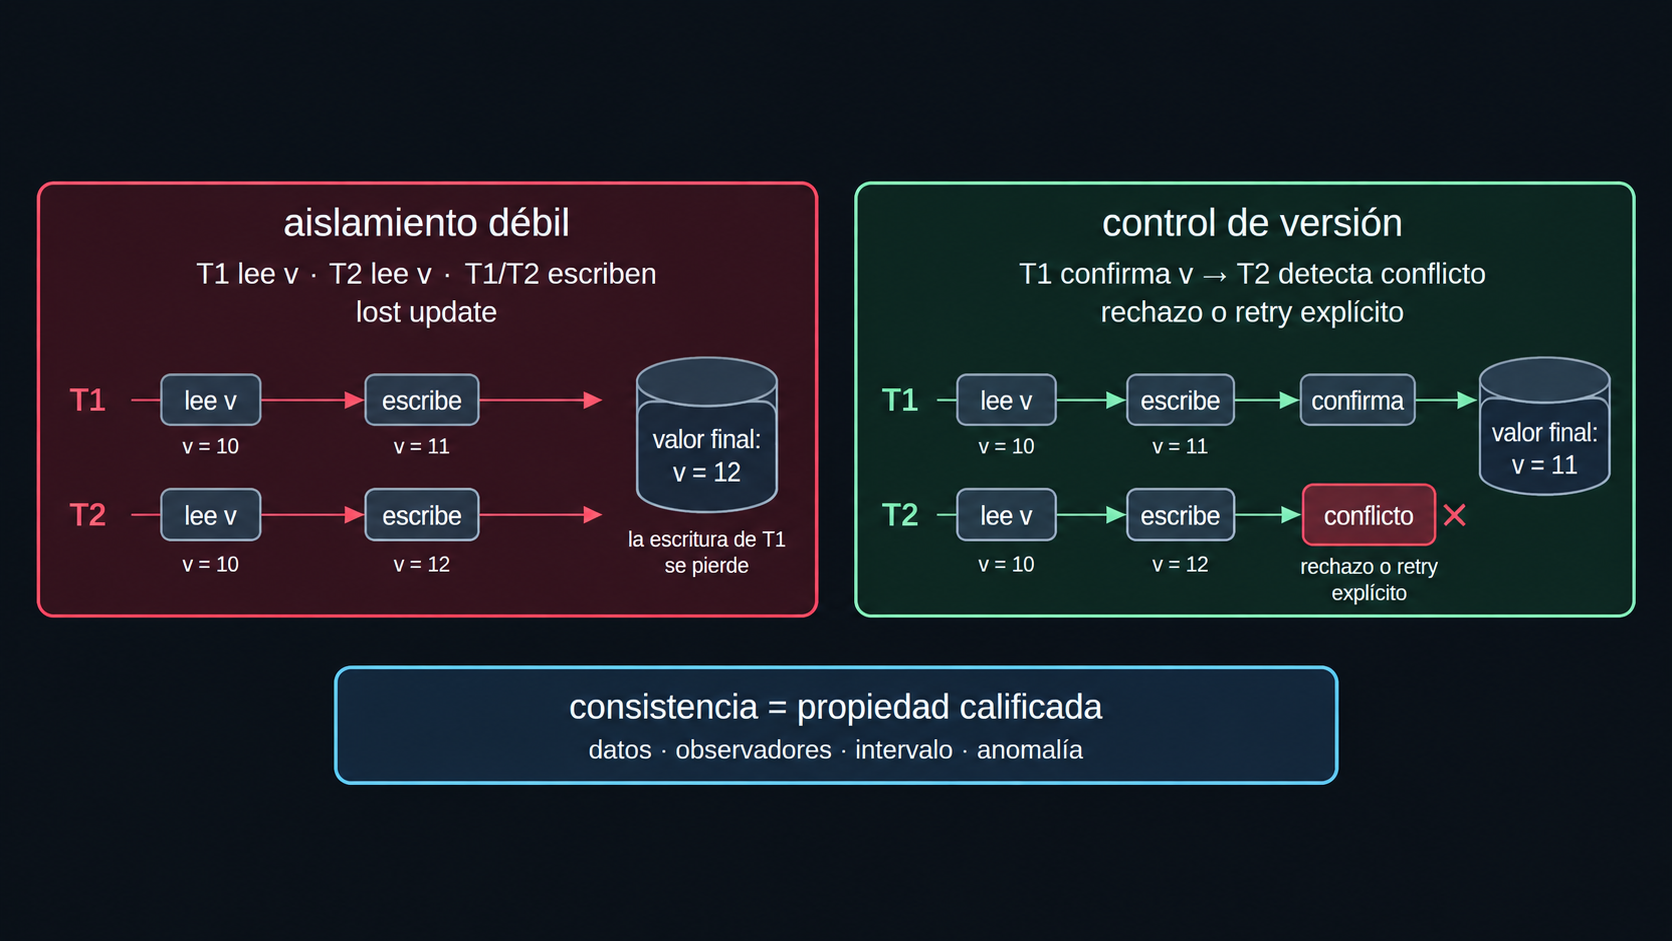
El aislamiento describe qué observaciones concurrentes permite una transacción. La documentación de PostgreSQL 18 sobre aislamiento muestra que nombres como read committed, repeatable read o serializable tienen significado dentro del motor y versión concretos; no deben usarse como adjetivos universales. Un nivel puede impedir una anomalía y permitir otra, o necesitar retry ante serialización fallida. La documentación del motor y la operación real son la fuente.
El lost update ocurre cuando dos escritores leen una base común y el último sobrescribe el efecto del primero sin detectar el conflicto. Puede prevenirse con lock, comparación de versión, una actualización condicional o serialización suficiente. Una restricción de unicidad puede proteger una clave y no proteger el saldo total. Una transacción puede ser atómica para sus statements y no cubrir un recurso que otro servicio modifica fuera de ella.
Un ejemplo ayuda a no confundir lectura repetible con serialización. Dos transacciones pueden observar un conjunto de filas estable y aun así competir por una condición global, como «si hay menos de diez reservas, inserta una». Si ambas comprueban el mismo predicado y el nivel permite la anomalía, las dos pueden confirmar. La solución puede ser una restricción, un lock de predicado, una actualización condicional o serialización, según el motor y el modelo. No se debe escoger el mecanismo antes de escribir la invariante.
Las cachés añaden otra forma de carrera. Invalidar después de escribir puede dejar una ventana en que otro lector recupera un valor viejo y lo vuelve a almacenar. Invalidar antes puede exponer un miss mientras la base todavía no confirma. La consistencia de caché debe especificar quién puede observar qué versión y qué ocurre durante rollback; la palabra «consistente» no decide por sí misma si se acepta stale data.
Los reintentos por fallo de serialización son parte de la semántica de la aplicación. Reintentar una transacción pura puede ser razonable; reintentar una transacción que envió correo, cobró una tarjeta o publicó un evento puede duplicar efectos. El código necesita separar el trabajo transaccional de efectos externos, usar una identidad idempotente o dejar el resultado en estado reconciliable. El motor no conoce automáticamente esos efectos.
«Consistencia» tiene varios usos: una invariante de dominio, consistencia de lectura, consistencia de caché, consistencia de réplica o el C de ACID. Antes de afirmar que un sistema es consistente, nombre qué propiedad, sobre qué datos, entre qué observadores y durante qué intervalo. La ausencia de una anomalía en una prueba no demuestra que el nivel, el plan o la carga real la excluyan.
Cancelación y fallos parciales
Una operación concurrente puede cancelarse después de adquirir un lock, después de escribir memoria o después de que el motor confirme un commit. El código debe definir qué se libera, qué se revierte, qué queda confirmado y qué estado es desconocido. Cancelar el contexto del cliente no necesariamente cancela el trabajo ya enviado al servidor. Un retry ciego puede duplicar un efecto que sí llegó a commit.
Los efectos externos complican la atomicidad: una base puede confirmar y un mensaje no publicarse, o el mensaje puede publicarse y la respuesta perderse. El 56 desarrollará coordinación distribuida; aquí basta exigir que el contrato identifique la frontera y el estado incierto. Idempotency keys, outbox o reconciliación son patrones posibles, no garantías intercambiables. Cada uno debe probar su relación con la invariante y el ciclo de vida.
La cancelación cooperativa debe tener puntos seguros. Si un hilo abandona entre retirar una reserva y registrar su auditoría, la recuperación debe saber si el retiro fue confirmado. Si abandona mientras sostiene un lock, la liberación debe estar vinculada a un bloque de alcance o a un mecanismo equivalente; una ruta excepcional que omite la liberación puede convertir un error de entrada en bloqueo de otros actores. Si el trabajo no puede cancelarse después de una operación irrevocable, la API debe documentar esa frontera y devolver «en curso» o «resultado desconocido», no fingir que el efecto fue deshecho.
Los fallos de proceso y de máquina cambian qué evidencia sobrevive. Una variable en memoria puede volver a su valor inicial aunque la base confirme; un log puede perderse antes de fsync; una respuesta puede no llegar al cliente. El diagnóstico debe distinguir estado local, estado confirmado por el recurso y estado observado por el solicitante. Una métrica de éxito basada sólo en respuestas puede subcontar commits; una basada sólo en commits puede omitir efectos externos fallidos.
Método de diagnóstico
Empiece por el estado protegido y su invariante, no por el nombre del lock. Catalogue actores, operaciones, lecturas, escrituras y efectos externos. Dibuje al menos dos interleavings válidos y anote las relaciones happens-before. Luego pregunte qué modelo de memoria o aislamiento aplica, qué sincronización publica el dato y qué ocurre si una operación es cancelada en cada punto.
Construya un control negativo: una ejecución donde el conflicto no sea alcanzable o donde la versión cambie y el sistema rechace. Construya un control positivo: dos operaciones realmente concurrentes que fuerzan la ventana. Observe estado final, respuestas, commits, reintentos y trazas. Un test que «pasó» sin forzar el interleaving sólo prueba esa ejecución. La instrumentación debe correlacionar operación, versión, lock, transacción y decisión, sin convertir logs no sincronizados en orden causal.
Al adjudicar, separe observación, inferencia, impacto y decisión. «Se observaron dos lecturas con versión 7» es evidencia; «hay lost update» requiere demostrar dos escrituras y ausencia de control; «podría perderse un saldo» es impacto potencial hasta reproducirlo bajo las precondiciones. Esta disciplina evita severidad inflada y evita declarar seguridad por ausencia de fallo.
La revisión debe comprobar también los límites del arreglo propuesto. Cambiar un lock por CAS puede reducir bloqueo y aumentar reintentos; elevar aislamiento puede convertir una anomalía en errores de serialización que el cliente no trata; hacer una operación idempotente puede ocultar una respuesta perdida pero no reparar un efecto externo ya duplicado. Cada mitigación necesita una propiedad objetivo, un mecanismo, precondiciones y una prueba de regresión. «Usar transacciones» o «hacerlo atómico» no son especificaciones suficientes.
Cuando el estado se comparte entre una caché y una base, documente cuál es la fuente de verdad durante la transición. Una invalidación tardía puede entregar datos viejos; una actualización temprana puede exponer que el nuevo valor aún no está confirmado. Si el consumidor puede escribir desde dos rutas, ambas deben participar del mismo control de versión o la propiedad queda abierta en una ruta lateral. El análisis de un solo endpoint no acredita todo el recurso.
Los errores de diagnóstico más costosos suelen estar en los caminos poco frecuentes: expiración del lock, excepción durante una actualización, timeout después de commit, cancelación mientras se espera una condición y retry después de una respuesta perdida. Pruebe esos puntos de salida como estados propios. Un sistema puede ser correcto en la trayectoria de éxito y dejar una reserva, lock o mensaje pendiente en la trayectoria de fallo. Esa diferencia conecta concurrencia con el modelo de fallos parciales del capítulo 51.
La conclusión debe conservar incertidumbre cuando falte una observación. Si sólo se conoce que dos respuestas devolvieron éxito, no se puede inferir por ello que ambas escrituras fueron durables o que ningún tercer actor escribió entre ellas. Pida el commit, la versión y el estado final que permitan resolver la hipótesis. Si no están disponibles, clasifique el caso como no adjudicado y describa la prueba mínima que cerraría la incertidumbre.
La misma cautela aplica a métricas agregadas: un promedio puede ocultar una cola bloqueada y una tasa baja de conflictos puede ocultar una ruta que no informa rechazos. Segmente por recurso, operación, versión y causa antes de decidir que la coordinación funciona.
Un contrato útil especifica qué ve cada participante después de un rechazo. Puede conservar la versión nueva, exigir una nueva lectura o devolver un conflicto recuperable. Si el cliente recibe sólo un error genérico, puede repetir con datos obsoletos y reabrir la carrera. La respuesta, la telemetría y la documentación deben coincidir sobre si el efecto fue aplicado, rechazado o quedó desconocido.
Un informe reproducible debe incluir versión del runtime o motor, configuración de aislamiento, número de actores, datos iniciales, forma de sincronizar el arranque y condición que fuerza la intercalación. También debe guardar qué operaciones devolvieron conflicto, qué commits se observaron y qué reintentos ocurrieron. Sin esa información, «falló una vez bajo carga» es una señal útil, pero no una explicación causal.
Para una prueba controlada, use una barrera que haga que dos actores terminen sus lecturas antes de permitir las escrituras. Para un control negativo, serialice los actores o cambie la versión entre lectura y escritura y compruebe que el resultado esperado es rechazo. Repita con cancelación en puntos definidos. La barrera de prueba no debe confundirse con una sincronización presente en producción: sirve para hacer alcanzable una ventana, no para atribuir al sistema una garantía que la prueba introdujo.
El análisis estático puede localizar accesos y locks, pero no demuestra por sí solo un interleaving ejecutable. El análisis dinámico puede observar una violación, pero no agota órdenes posibles. Un detector de data races puede operar bajo el modelo del lenguaje y no conocer una carrera de negocio entre APIs. La conclusión debe indicar qué técnica cubrió qué clase de defecto y qué queda pendiente. La revisión independiente debe intentar falsar tanto el control como el supuesto de alcanzabilidad.
Síntesis
Concurrencia exige un modelo explícito de eventos, memoria, aislamiento y fallos. Interleavings ayudan a falsar una invariante; happens-before explica qué orden está garantizado. Data race y race condition tienen alcances diferentes. Atomicidad, visibilidad y orden deben nombrarse por separado. Locks previenen ciertos conflictos y pueden introducir deadlock; CAS y versiones detectan conflictos pero necesitan límites, reintentos y simetría entre éxito y rechazo. Aislamiento no es una palabra única: el nivel, el motor y la anomalía importan.
Una revisión madura pregunta además qué parte de la propiedad se mantiene bajo carga y cuál depende de parámetros operacionales. El número de hilos, el tamaño de la cola, la duración de una transacción, la política de retry y el tiempo de espera pueden cambiar qué interleavings son alcanzables. Una configuración que evita deadlock en una prueba pequeña puede sufrir inanición con prioridades distintas. Un retry que estabiliza una operación breve puede amplificar la carga cuando el conflicto es persistente. Esos efectos son parte del mecanismo, no simples detalles de rendimiento.
La instrumentación debe ser proporcional: suficientes identificadores para correlacionar una operación y su versión, pero sin registrar secretos o convertir cada acceso en una nueva fuente de contención. Si el tracing cambia el orden y hace desaparecer la carrera, la evidencia debe declararlo. Reproducir con barreras o inyección de latencia ayuda a controlar la ventana; no prueba que todos los horarios reales estén cubiertos.
La práctica defendible es pequeña y concreta: declarar la invariante, identificar la frontera de sincronización, probar interleavings controlados, incluir cancelación y fallos parciales y conservar evidencia suficiente para distinguir un resultado observado de una garantía. La consistencia de un componente no resuelve por sí sola la coordinación del sistema que el capítulo 56 estudiará.