Un diagrama puede parecer una fotografía del sistema, un registro puede sonar como un testimonio y una explicación puede presentar una secuencia limpia. Los tres son más modestos. Cada uno conserva ciertas decisiones de quien lo produjo y deja otras fuera. La habilidad profesional no consiste en desconfiar de todo, sino en preguntar qué representa cada marca, qué relación permite sostener y qué conclusión aún necesita otra observación.
Antes de interpretar: identificar el artefacto
Un diagrama es una representación seleccionada de entidades y relaciones. Una leyenda asigna significado a símbolos, colores, líneas y niveles. Topología describe qué componentes están conectados o dependen de otros; secuencia describe un orden de transiciones bajo condiciones. No son sinónimos. Un registro es una representación persistida o transmitida de un evento que un productor decidió registrar. Un evento es aquí un cambio, decisión, observación o intento nombrado por ese productor, no necesariamente el efecto completo que una persona imagina. Una inferencia es una conclusión derivada al combinar campos, contexto y modelo; queda más lejos del texto producido que una observación.
Antes de leer, anotemos cinco preguntas: ¿quién produjo el artefacto?, ¿qué población o ventana cubre?, ¿qué significa cada símbolo o campo?, ¿qué relación se declara y cuál se observó?, ¿qué parte está ausente? Esta pequeña ficha evita que una línea de arquitectura se convierta en un cronograma o que un nombre de campo se convierta en una garantía.
Leer un diagrama sin inventarle tiempo
Empieza por la leyenda. Una flecha continua puede significar dependencia configurada, flujo de datos, permiso o llamada; sólo el documento que la acompaña decide. Una flecha discontinua puede ser una relación opcional, una frontera administrativa o una observación parcial. Si no hay leyenda, la lectura debe describirse como hipótesis.
Después identifica el nivel. En un nivel lógico, cliente → servicio puede expresar que el cliente necesita esa interfaz. En un nivel físico, puede representar enlaces o ubicaciones. En un nivel de proceso, puede representar una llamada. Dibujar las tres relaciones alineadas no las vuelve equivalentes. Una caja llamada «nube» puede ocultar proveedores, colas y regiones; su tamaño no informa la topología interna.
La dirección también necesita semántica. A → B puede significar que A envía un mensaje, que A depende de B o que una decisión se propaga. La dirección de lectura no prueba dirección de red. Un diagrama de secuencia sí añade un eje temporal, pero aun así sus barras suelen resumir estados; no muestran cada reintento, cola o retraso salvo que la leyenda lo prometa.
La topología declarada y el tránsito observado son capas distintas. Si una arquitectura dibuja cliente, gateway y servicio, puede sostenerse que esa es la ruta prevista o autorizada según la fuente. Para afirmar que un mensaje pasó por el gateway durante una ventana hacen falta captura, contador o registro correlacionable en ese punto. El capítulo 0.08 ya introdujo el límite de caminos; aquí lo convertimos en una regla de lectura.
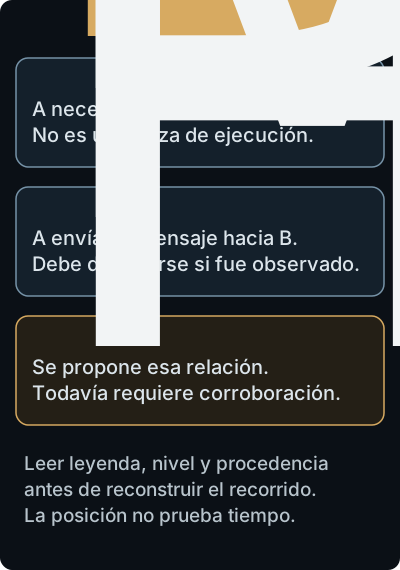
Tres convenciones distintas, no tres etapas de un proceso. Una conexión dibujada necesita leyenda y procedencia para interpretarse.
Ejemplo mínimo
Supongamos un dibujo con cuatro nodos principales: Terminal —(TLS)— API → Cola → Worker, más un nodo externo Proveedor conectado mediante una flecha discontinua desde Worker. La leyenda dice que las líneas continuas representan el recorrido configurado para mensajes y la discontinua una dependencia externa no observada. El recorrido previsto entrega trabajo desde API a Cola para que Worker lo consuma. Eso no prueba una entrega concreta ni demuestra que TLS esté bien configurado. No podemos decir que cada solicitud de terminal alcanzó al proveedor ni que el worker completó la operación. Un registro del proveedor podría fortalecer esa conclusión, pero sólo para sus propias entradas y ventana.
Del registro a una afirmación
Un registro sintético útil separa al menos cinco piezas: productor, evento, tiempo, identificador y observado. El productor es el componente o colector que escribe el registro; no necesariamente la persona o sistema que originó la acción. El evento es la etiqueta y contexto que ese productor declara. El tiempo debe distinguir el reloj de fuente del instante de recepción. El identificador permite correlación dentro de un espacio; no es por sí mismo identidad autenticada. Lo observado es lo que el registro dice que vio o decidió.
RFC 5424 organiza un mensaje syslog en campos como TIMESTAMP, HOSTNAME, APP-NAME, PROCID, MSGID y structured data (RFC 5424, §§6.2–6.4). Esa estructura ayuda a leer, pero no convierte el mensaje en una prueba completa de integridad, cobertura o autenticidad. El valor HOSTNAME=gw-2 es un valor del mensaje; establecer quién pudo producirlo exige conocer transporte, control de acceso, retención y cadena de custodia.
Consideremos cuatro registros ficticios. El formato clave-valor es pedagógico: no son mensajes conformes al formato syslog de RFC 5424.
producer=gw-2 receiver=central-log event=accepted source_time=2026-10-05T10:00:04-04:00 arrival=2026-10-05T10:00:09-04:00 request_id=r7 principal=acct-4
producer=api-1 receiver=central-log event=enqueued  source_time=2026-10-05T10:00:05-04:00 arrival=2026-10-05T10:00:06-04:00 request_id=r7 queue=q9
producer=worker-3 receiver=central-log event=started   source_time=2026-10-05T10:00:07-04:00 arrival=2026-10-05T10:00:08-04:00 request_id=r7 job=j2
producer=worker-3 receiver=central-log event=completed source_time=2026-10-05T10:00:12-04:00 arrival=2026-10-05T10:00:13-04:00 request_id=r7 result=ok
Las horas son sintéticas y se escriben con fecha y offset para hacer visible la convención; el ejemplo no prueba que los relojes de los productores estén sincronizados. producer identifica el componente que afirma el evento y receiver=central-log el sistema que recibió y conservó la línea. Por tanto, arrival es llegada al receptor central, no llegada al productor ni tiempo de ejecución. Si el receptor reenviara o reordenara, necesitaríamos un segundo campo de recepción y su contrato.
La primera línea declara a gw-2 como productor de un evento llamado accepted, asocia r7 y conserva acct-4 como campo. Por sí sola no autentica al productor, no acredita quién se autenticó ni demuestra que una operación de negocio se completara. La segunda aporta una afirmación diferente: api-1 dice que encoló trabajo en la cola q9; q9 no es el identificador del trabajo. La tercera declara un inicio del trabajo j2; la cuarta declara una finalización con resultado ok.
Hay dos órdenes. Por llegada, el segundo, tercero, primero y cuarto registros aparecen en el colector: 10:00:06, 10:00:08, 10:00:09, 10:00:13. Por tiempo de fuente, el productor sugiere primero gateway, luego API, worker y finalización. Esa narración es razonable si los relojes son comparables y los campos tienen el contrato esperado. No es un orden total demostrado. El primer registro puede haber viajado tarde; el productor puede tener deriva; un reintento puede haber omitido una entrada intermedia.
El identificador r7 ayuda a tratar las cuatro líneas como una posible cadena. No prueba que todos los componentes recibieran la misma petición si un sistema permite colisiones, propagación incorrecta o reuso. j2 añade otro namespace: una relación entre request y job que debe estar documentada. El campo result=ok es una observación del worker; no prueba que el cliente recibiera respuesta ni que un proveedor externo aceptara el efecto.
Las incógnitas son parte del resultado: ¿quién emitió realmente accepted?, ¿qué política produjo esa decisión?, ¿se perdió un intento?, ¿la cola persistió el trabajo?, ¿el reloj de worker estaba sincronizado?, ¿hubo otro consumidor?, ¿qué significa completed en el contrato? Un buen lector no rellena esos huecos con una historia única.
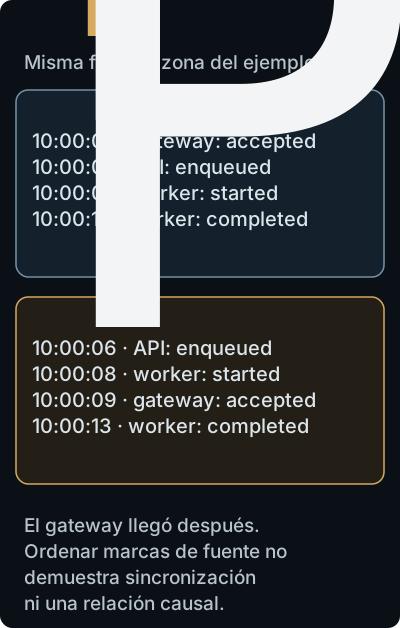
Las mismas cuatro líneas del ejemplo, ordenadas por campos diferentes. Son marcas declaradas: no acreditan sincronización ni causalidad por sí solas.
Dos relojes y un contraejemplo
Un timestamp expresa una representación temporal. RFC 3339 especifica formas con UTC y offset (RFC 3339, §§5.1–5.6); no promete sincronización entre productores. El reloj de fuente responde «qué hora declaró el componente». El reloj de llegada responde «cuándo lo recibió este observador». Son preguntas distintas.
Contraejemplo: el gateway registra A a las 12:00:01, pero una pausa de red hace que llegue a las 12:00:08; API registra B a las 12:00:03 y llega a las 12:00:04. B aparece primero en la colección aunque A pudo ocurrir primero. También puede darse un reloj adelantado: A declara 12:00:01 cuando físicamente ocurrió después de B. Una secuencia lineal dibujada por orden de archivo sería una explicación posible, no una observación suficiente.
Pseudocódigo: precondiciones, estados y alcance
Leer una explicación técnica también exige localizar las precondiciones. En:
if token_valid:
    state = ready
    send(message)
token_valid es una condición cuyo significado falta: ¿qué token, qué verificador, qué reloj, qué audiencia y qué política? ready es un estado del proceso, no necesariamente del receptor. send(message) puede escribir en un socket, encolar trabajo o iniciar una operación asíncrona. Para afirmar entrega, necesitamos un resultado del transporte o del receptor con el mismo alcance. Para afirmar autorización, necesitamos la política y sus entradas; un registro de validación no concede por sí solo permiso para todas las operaciones.
La explicación debe declarar si una transición es atómica, si puede repetirse y qué ocurre al fallar entre ready y send. Un contraejemplo sencillo rompe la lectura ingenua: el proceso cambia a ready, la cola acepta el mensaje, pero el worker cae antes de procesarlo. La línea ejecutada existió; el efecto final no queda demostrado.
Leer MUST, SHOULD y MAY
En una especificación, MUST expresa una obligación dentro del alcance del documento; MUST NOT, una prohibición. SHOULD expresa una recomendación fuerte: el implementador debe comprender y ponderar las implicaciones de otra elección, porque puede haber razones válidas para apartarse. MAY deja una opción. RFC 2119 §1 define esta convención y RFC 8174 §2 aclara que el sentido normativo depende de las mayúsculas (RFC 2119, RFC 8174).
Hay que leer el sujeto, el objeto y la condición: «el cliente MUST enviar X cuando Y» no obliga a un servidor, ni cubre una situación distinta de Y. «El cliente SHOULD reintentar» no es equivalente a «todos los sistemas deben reintentar siempre». Una explicación propia puede recomendar algo en minúscula; esa recomendación no hereda automáticamente la fuerza del estándar. Tampoco una mayúscula aislada fuera de un lenguaje normativo convierte un consejo en obligación universal.
Preguntar por observación, inferencia e impacto
Una interpretación profesional puede escribirse en cuatro capas. Observación: worker-3 registró completed result=ok. Inferencia: el worker considera terminada su tarea j2, posiblemente relacionada con r7. Impacto posible: si un operador trata ese campo como confirmación del proveedor, puede cerrar una operación que aún no fue aceptada externamente. Decisión: consultar el acuse del proveedor o marcar el estado como pendiente.
Esta separación sirve también para diagramas. Observación: la captura contiene una conexión en el punto P. Inferencia: P participó en esa ruta. Impacto posible: se atribuye a P una función que otro intermediario ejecutó. Decisión: buscar una segunda observación en el borde siguiente. La disciplina no retrasa el análisis; indica qué dato cambiaría la conclusión.
Misma topología, ejecuciones distintas
Una topología puede mantenerse estable mientras dos ejecuciones difieren radicalmente. Considérese Cliente → API → Cola → Worker. En la ejecución E1, la API acepta r7, publica un mensaje en q9, el worker lo retira y el proveedor confirma. En E2, la API acepta r8, publica dos veces por un retry después de un timeout y el worker procesa una copia; la otra expira en la cola. El dibujo es idéntico. La diferencia vive en estados, tiempos y reglas de reintento que el mapa no contiene.
El retry tampoco implica necesariamente duplicación de efecto. Puede haber un identificador de idempotencia que haga que el proveedor trate la segunda entrega como repetida; puede faltar ese control; o puede que el primer mensaje se haya procesado pero su acuse se perdiera. Tres historias producen una topología igual y un síntoma parecido. Para separarlas se necesitan registros de publicación, recepción, entrega y respuesta con el mismo espacio de identificadores, además del contrato de la cola: retención, visibilidad, reentrega y orden. Una flecha API → Cola no dice si la publicación fue confirmada, si la cola persistió bytes o si el worker recibió una copia posterior.
La lectura correcta conserva dos grafos: el grafo de componentes y el grafo de la ejecución. El primero cambia lentamente y puede provenir de configuración. El segundo es una secuencia parcial de eventos observados. Confundirlos hace que «existe una ruta» se convierta en «esta operación recorrió la ruta». Una buena explicación escribe explícitamente: «la arquitectura permite X; los registros de esta ventana apoyan Y; queda sin observar Z».
Qué produce y qué recibe cada campo
En el ejemplo, producer=api-1 no dice que el receptor central haya visto directamente la acción del cliente. Dice que api-1 produjo la afirmación. receiver=central-log dice dónde se recibió la línea. event=enqueued nombra la interpretación del productor, no un hecho universal sobre la cola. queue=q9 delimita un identificador de recurso o namespace; para interpretarlo necesitamos saber si q9 es global, regional, efímero o reutilizado.
request_id=r7 permite buscar relaciones, pero su alcance puede ser sólo una API, una instancia o una ventana. Si el gateway genera r7 y API lo regenera, dos líneas visualmente parecidas no son la misma solicitud. job=j2 puede ser un identificador distinto que enlaza una tarea derivada. El lector debe preguntar quién asigna cada ID, cuándo se propaga, si puede colisionar y cuánto tiempo se conserva. Sin esas respuestas, «correlacionado» es una hipótesis, no una propiedad del texto.
Los datos omitidos importan tanto como los visibles: método y recurso, resultado de política, versión de esquema, intento de entrega, región, estado de cola y razón de reintento. No hay que exigir todos esos campos en cada registro; sí declarar cuándo su ausencia impide una conclusión. Un registro mínimo puede servir para depuración local y ser insuficiente para atribuir un efecto externo. La calidad se evalúa contra la pregunta, no por cantidad de pares clave-valor.
Pseudocódigo paso a paso
Tomemos una versión más explícita:
state = received
if verify(token, audience=payments) == valid:
    state = ready
    enqueue(request_id, message)
    state = queued
else:
    state = rejected
Antes de la primera línea, token existe en una entrada concreta y state no conserva necesariamente un estado previo. verify puede fallar por firma, audiencia, expiración o formato. La transición received → ready describe el estado local después de una decisión; no prueba que una persona se haya autenticado ni que el pago esté autorizado. La autorización puede depender también de cuenta, recurso, importe y política posterior.
Si enqueue devuelve éxito, queued puede significar «el broker aceptó una solicitud» o «el proceso la puso en memoria», según el contrato. Entre la escritura del mensaje y la asignación de queued puede ocurrir un cierre; entre queued y el consumo, el mensaje puede expirar. Si el pseudocódigo no declara atomicidad, no debemos inventarla. La observación de state=queued prueba como máximo la transición registrada por ese proceso, no entrega ni ejecución del worker.
Un fallo en la rama else tampoco prueba ausencia de intento: una capa anterior pudo haber reintentado, o el verificador pudo registrar sólo la última evaluación. La explicación completa debe nombrar precondiciones, estados alcanzables, transiciones repetibles y puntos de pérdida. Así el lector puede pedir evidencia concreta: resultado de verificación, confirmación de cola, recepción del worker y acuse del proveedor.
Fragmento normativo y observación de implementación
Supongamos que una especificación ficticia dice: «A client MUST include request-id. A client SHOULD retain it across a retry when the operation is repeatable. A client MAY add trace-state». Presentamos el fragmento como una convención normativa declarada por ese documento; no es una cita de RFC ni una regla general del lenguaje.
La primera frase impone al cliente, dentro de la operación cubierta, incluir el campo. La segunda recomienda conservarlo cuando la operación es repetible y exige valorar las consecuencias de cambiarlo: si se renueva sin contrato, puede romper la correlación o la deduplicación; si se conserva cuando el servidor espera un ID por intento, puede ocultar intentos distintos. La tercera permite trace-state, pero no obliga al receptor a usarlo.
Después se observa una implementación: el cliente envió dos requests, uno con request-id=r7 y otro con request-id=r8. Eso puede ser conforme si cada retry es un intento nuevo o puede ser una desviación si el contrato exige conservación. La especificación no prueba lo que hizo el cliente; el log tampoco decide por sí solo cuál versión normativa aplica. Primero se identifica la edición y alcance; luego se compara el comportamiento observado con el deber pertinente.
Transferencia: seis preguntas razonadas
- ¿Qué significa cada flecha y cuál es su leyenda? Criterio: distingue topología, secuencia y observación.
- ¿Quién produjo cada campo del registro? Criterio: no convierte
principaloHOSTNAMEen identidad verificada. - ¿Qué reloj representa cada timestamp? Criterio: ordena llegada y fuente por separado y declara sincronización desconocida.
- ¿Qué precondición habilita cada transición del pseudocódigo? Criterio: nombra estados, fallos y efectos asíncronos.
- ¿Qué sujeto y alcance tiene cada MUST/SHOULD/MAY? Criterio: aplica RFC 2119/8174 sin universalizar una especificación.
- ¿Qué contraejemplo produciría el mismo síntoma? Criterio: ofrece una explicación legítima alternativa y una evidencia discriminante.
Caso resuelto: ¿podemos anunciar que terminó?
Una operadora recibe las cuatro líneas del ejemplo y pregunta si puede informar al cliente de que la operación terminó. La respuesta depende de qué signifique «terminó». Si el compromiso es haber aceptado trabajo para procesamiento, la evidencia necesaria no es la misma que si se promete la confirmación de un proveedor externo. Antes de buscar más registros, hay que fijar ese criterio de finalización.
Con lo mostrado, la conclusión defendible es limitada: el conjunto contiene una declaración de finalización atribuida a worker-3, con resultado ok y correlación r7. No hay un acuse del proveedor ni una observación del cliente. Tampoco hemos establecido la autenticidad de los productores. Por eso no corresponde transformar esa declaración en «el cliente recibió el resultado».
Hay al menos dos historias compatibles: el proveedor confirmó y el worker registró el éxito; o el worker sólo terminó su tarea local de preparar el envío. No son equivalentes para el cliente, aunque ambas puedan usar completed. El primer dato discriminante es el contrato del evento: qué condición autoriza emitirlo. Si exige confirmación externa, el siguiente paso es buscar esa confirmación y su relación con r7, no acumular líneas que repitan ok.
Si no aparece el acuse, tampoco se deduce inmediatamente que no existió. Debemos conocer qué entradas conserva la búsqueda, durante cuánto tiempo y con qué posibles pérdidas. RFC 5424 contempla información de calidad temporal en timeQuality y advierte sobre la falta de entrega garantizada en su modelo (§7.1, §8.5). Esto no determina el comportamiento de nuestro colector ficticio: obliga a comprobar su contrato concreto. La decisión provisional puede ser «confirmación externa pendiente», manteniendo separadas la tarea local terminada y la promesa al cliente todavía no acreditada.
Límites y síntesis
Este método no reemplaza una especificación de UML o BPMN, un sistema de logging, una cadena de custodia ni una investigación de incidentes. Tampoco determina por sí solo autenticación, intención o causa raíz. Enseña a conservar fronteras: la flecha necesita leyenda; el registro necesita productor y alcance; el tiempo necesita reloj; el pseudocódigo necesita precondiciones; la palabra normativa necesita sujeto y documento.
El modelo final es una lectura por capas. Primero se identifica lo que el artefacto representa. Después se reconstruyen relaciones compatibles. Por último se separan inferencias, incertidumbres y decisiones. Una explicación se vuelve fuerte no cuando elimina todos los huecos, sino cuando hace visible cuáles quedan y qué observación podría reducirlos.