Responder 202 Accepted desplaza una parte del trabajo fuera de la conexión HTTP. Desde ese instante ya no basta preguntar si el request llegó. Hay que seguir una cadena: ¿se registró la intención?, ¿el broker aceptó el mensaje?, ¿qué consumidor lo recibió?, ¿el efecto hizo commit?, ¿el acknowledgement llegó?, ¿puede aparecer otra entrega? Cada respuesta pertenece a una frontera distinta.
La mensajería asíncrona desacopla tiempos y disponibilidad, absorbe ráfagas y permite que varios componentes reaccionen a una ocurrencia. También sustituye una llamada visible por estados intermedios, reintentos y copias que pueden observarse en órdenes diferentes. El diseño profesional no empieza eligiendo Kafka o una cola gestionada. Empieza declarando qué significa el mensaje, quién tiene autoridad, dónde se conserva, qué confirma cada señal y cómo se repara una ejecución parcial.
Mensaje, comando y evento
Un mensaje es una unidad transportada entre componentes. Es un contenedor: headers, identificadores, metadatos y payload. Por sí solo no dice si el emisor ordena una acción, afirma un hecho o solicita una respuesta.
Un comando expresa intención: «crea esta factura», «revoca esta sesión», «recalcula este reporte». Suele tener un destinatario lógico responsable de aceptar o rechazar. Puede fallar porque la acción no está autorizada, el estado cambió o la instrucción es inválida. Conviene nombrarlo en imperativo y asignarle una identidad de operación estable cuando admite retries.
Un evento registra que ocurrió algo: InvoiceIssued, SessionRevoked, ReportGenerated. Se nombra en pasado porque no pide al consumidor que haga suceder el hecho original. Puede tener cero, uno o muchos interesados. Cada consumidor decide qué consecuencia local produce, pero no reescribe retroactivamente la ocurrencia.
CloudEvents define un evento como un registro que expresa una ocurrencia y su contexto. Distingue source, donde ocurrió, de producer, que construye la representación del evento. Una fuente puede abarcar varios productores. Además, una ocurrencia puede dar lugar a varios eventos: distintas vistas, esquemas o audiencias pueden describir el mismo hecho sin ser el mismo registro.
La pareja source + id identifica un evento distinto en CloudEvents. Si se reenvía el mismo evento por un fallo de red puede conservar el mismo id, y los consumidores pueden reconocerlo como duplicado. Ese identificador no debe cargarse con significados ajenos: no es automáticamente el ID de la entidad, el trace ID, la clave de partición ni una autorización.
Cambiar el nombre no cambia la semántica. Un mensaje llamado UserCreatedEvent que ordena a un único servicio crear al usuario sigue siendo un comando disfrazado. Uno llamado SendWelcomeEmail publicado para diez consumidores tampoco se vuelve un hecho. La revisión debe preguntar qué ocurrió antes de emitirlo, quién puede rechazarlo y cuántas consecuencias independientes son legítimas.
Cola, topic, stream y suscripción
La semántica del mensaje y la topología de distribución son ejes separados. Un comando puede viajar por una cola o un log; un evento puede distribuirse por un topic, almacenarse en un stream o entregarse directamente. No hay una correspondencia obligatoria.
Una cola de trabajo suele repartir entregas entre consumidores competidores. Añadir workers aumenta paralelismo; no pretende que cada worker reciba cada mensaje. El broker conserva el elemento hasta una condición de retiro: acknowledgement, expiry, rechazo o política específica.
Un topic o intercambio de publicación-suscripción permite que varias suscripciones independientes reciban la publicación conforme a reglas de routing. Cada suscripción tiene su propio progreso y fallos. «Publicar una vez» no significa «cada consumidor procesará exactamente una vez»: una suscripción puede estar mal configurada, atrasada, expirada o repetir.
Un stream o log retenido conserva registros durante una política y permite a consumidores llevar una posición u offset. El consumo no necesariamente elimina el registro. Esto habilita replay, nuevos consumidores y reconstrucción, a cambio de administrar retención, compatibilidad de schemas y posiciones.
La suscripción representa el interés y estado de un consumidor o grupo: filtros, permisos, posición, reintentos y política de expiración. Es una entidad operacional que debe inventariarse. Un topic sin una suscripción correcta es sólo una publicación potencial.
Vista adaptada. Toca el diagrama para ampliarlo.
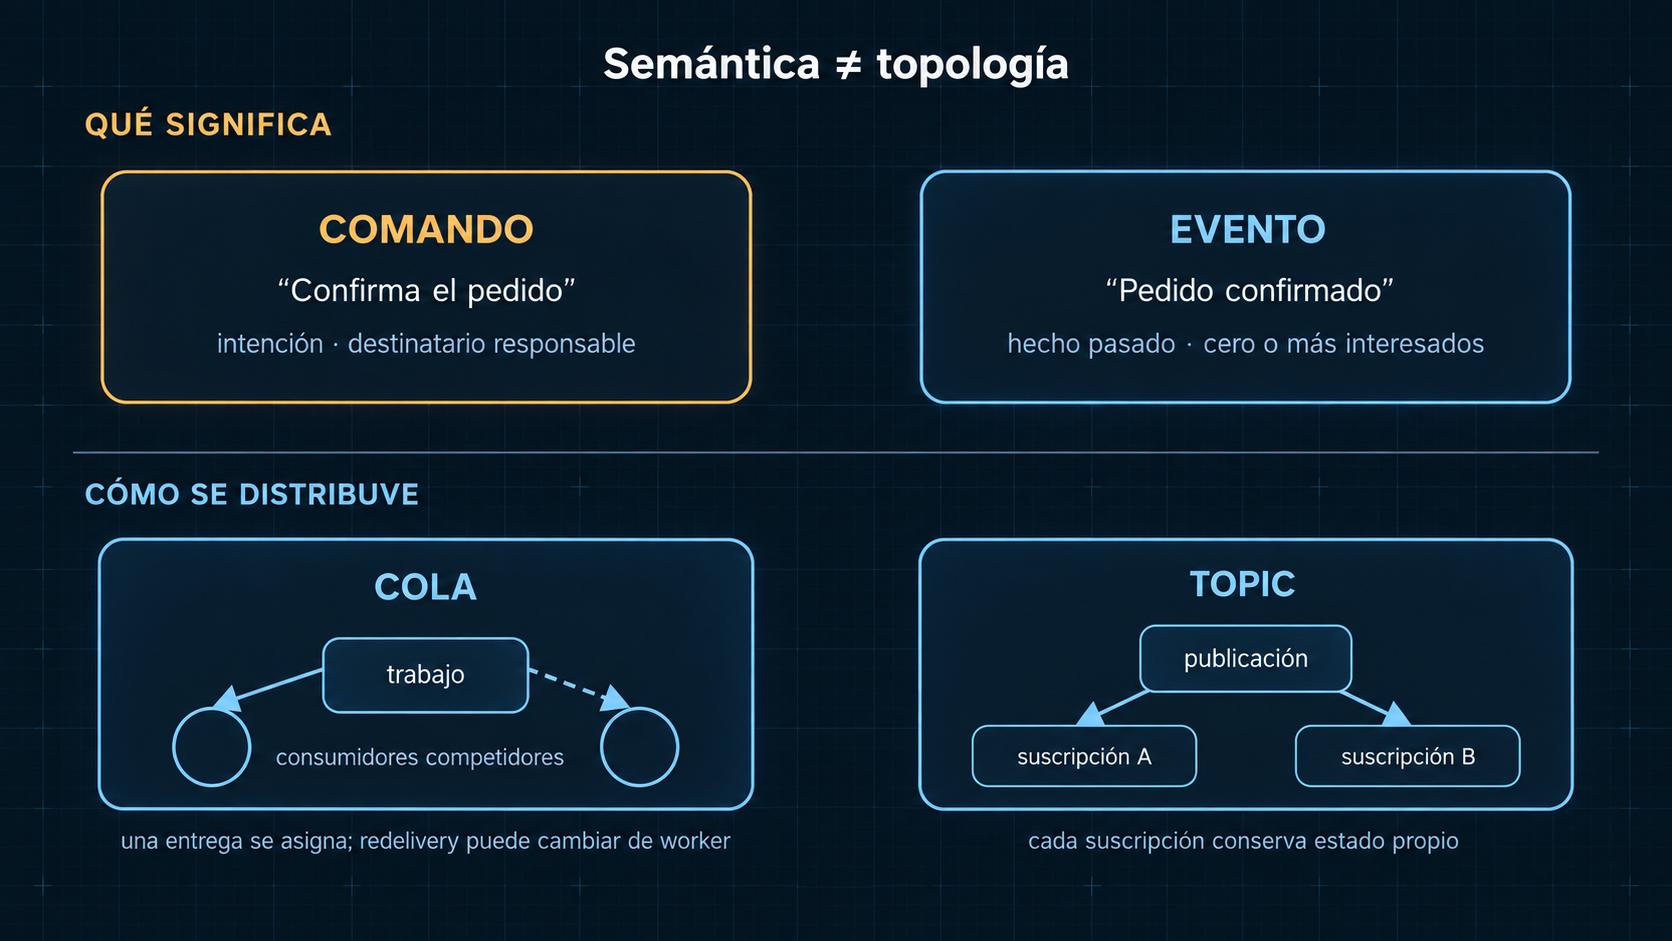
La figura conserva dos ejes. Arriba, un comando dirigido expresa una acción solicitada y un evento factual expresa una ocurrencia. Abajo, una cola ofrece trabajo a consumidores competidores; un topic alimenta suscripciones independientes. Dibujar un topic como una cola con dos flechas esconde que cada suscripción conserva su propio estado.
Publicar no es procesar
Cuando un productor escribe bytes en un socket, sólo sabe que intentó enviarlos. La conexión puede romperse antes de llegar, después de llegar o durante el retorno de una confirmación. Para una publicación durable necesita un protocolo donde el broker asuma responsabilidad conforme a una política verificable.
RabbitMQ distingue publisher confirms de consumer acknowledgements. El confirm cubre la relación productor-broker: el broker comunica que aceptó responsabilidad en el alcance de su configuración. No sabe si algún consumidor recibió, validó o aplicó el mensaje. El acknowledgement del consumidor cubre otro salto: el consumidor comunica al broker que la entrega puede retirarse según el contrato.
Ambas señales son ortogonales. Un confirm sin routing apropiado puede no significar que la publicación llegó a la cola pretendida si el contrato no exige mandatory o una ruta verificable. Un ack automático al recibir puede retirar un mensaje antes de que el efecto se haga durable. La palabra «confirmado» siempre necesita sujeto: confirmado por quién, sobre qué estado y hasta qué frontera.
AMQP 1.0 modela transferencias, delivery state y settlement. Un mensaje puede estar disponible, adquirido y luego archivado en un nodo de distribución. Esos estados describen la relación con ese nodo, no el estado de una factura o un correo. El mismo mensaje en otro nodo tiene otro estado. Trasladar una etiqueta del broker al dominio crea una falsa garantía.
Acknowledgement después del efecto durable
En el patrón ordinario at-least-once, el consumidor recibe una entrega, valida, ejecuta y hace acknowledgement sólo después de que el efecto necesario sea durable. Si cae antes del ack, el broker puede entregar de nuevo. Esta regla evita retirar trabajo no confirmado, pero abre una duplicación inevitable cuando la caída ocurre después del commit y antes del ack.
Vista adaptada. Toca el diagrama para ampliarlo.
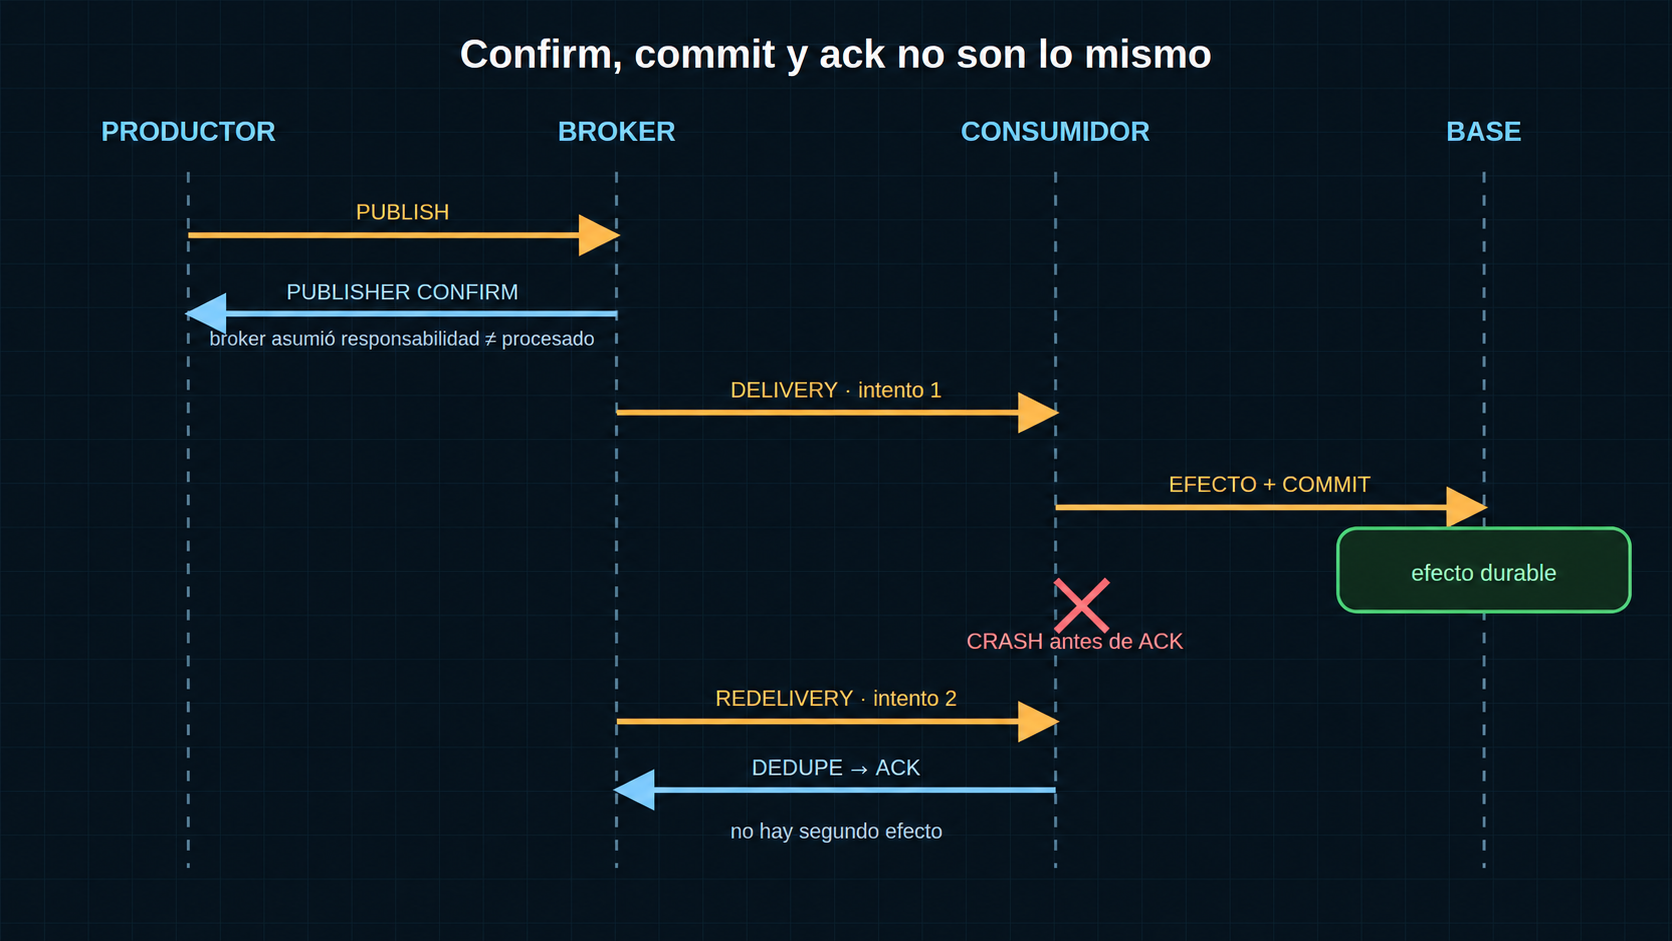
La secuencia crítica es:
- el productor publica;
- el broker persiste o asume responsabilidad y confirma;
- el broker entrega al consumidor;
- el consumidor hace commit del efecto;
- el consumidor cae antes de enviar ack;
- al expirar la entrega o cerrarse la sesión, el broker reentrega;
- el consumidor reconoce el mismo message-id, no repite el efecto y hace ack.
Si el consumidor hubiera hecho ack en el paso 4 antes del commit, una caída posterior perdería trabajo. Si el broker promete visibility timeout, el mensaje queda oculto temporalmente, pero SQS documenta que su modelo at-least-once no garantiza ausencia absoluta de otra entrega durante ese intervalo. El timeout es una coordinación útil, no un lock distribuido universal.
El procesamiento largo necesita extender la visibilidad o dividir el trabajo. Una visibilidad demasiado corta causa concurrencia duplicada; una demasiado larga retrasa recuperación tras una caída. El valor debe relacionarse con la distribución real de duraciones, límites de extensión y capacidad de detectar workers muertos.
At-most-once, at-least-once y exactly-once
Las etiquetas sólo son útiles si nombran la frontera.
At-most-once delivery permite pérdida pero no redelivery dentro del contrato. Puede lograrse retirando antes de procesar o sin acknowledgements, pero una caída puede borrar trabajo. No significa que el efecto nunca se duplique por otra ruta.
At-least-once delivery busca no perder mensajes confirmados y admite redelivery. No promete que el efecto ocurra al menos una vez: el mensaje puede ser inválido, no autorizado, expirar o terminar en cuarentena. Tampoco promete que el efecto ocurra muchas veces; un consumidor idempotente puede aplicarlo una sola.
Exactly-once debe completarse con una frase: exactamente una vez, ¿qué? ¿La escritura en un log, la visibilidad para un grupo, una transición en una base o un cargo externo? Apache Kafka documenta exactly-once al leer, procesar y escribir sobre topics Kafka mediante Kafka Streams o productor transaccional y consumidores read_committed. Esa frontera es real y útil. No incluye automáticamente una API de pagos, un email o una base ajena a la transacción.
La expresión «exactly-once delivery» suele ocultar dos problemas: durabilidad al publicar y efecto al consumir. Incluso si el broker elimina duplicados de producción, un consumidor puede ejecutar dos veces tras una caída. Incluso si el consumidor registra offsets con una salida Kafka en la misma transacción, un side effect externo puede ocurrir y perderse su confirmación.
La formulación defendible es más larga: «para este grupo, los offsets de entrada y las salidas a estos topics hacen commit en una transacción Kafka, y los consumidores sólo leen datos comprometidos». Para un efecto externo: «puede repetirse; se protege por clave de negocio y reconciliación». La precisión evita vender una garantía fuera de su dominio.
Un consumidor idempotente no es sólo un if
Una estrategia común consulta processed_messages y, si no encuentra el message_id, aplica el efecto y luego inserta el ID. Bajo concurrencia, dos entregas pueden observar ausencia y ambas ejecutar. El check no es atómico.
El patrón robusto introduce una constraint única por alcance apropiado —por ejemplo, (consumer, source, event_id)— y registra la deduplicación en la misma transacción que el efecto local. Una entrega obtiene el derecho; la otra colisiona y se trata como duplicado. Si la transacción aborta, ni el efecto ni la marca deben quedar confirmados.
No siempre hay una transacción común. Enviar correo, llamar a un proveedor o accionar hardware puede quedar fuera. Entonces se necesita una operación externa idempotente con clave estable, un estado de workflow y reconciliación. Registrar «sent» antes del envío arriesga pérdida; después del envío arriesga duplicado. La arquitectura debe conservar ese resultado incierto, no esconderlo bajo un booleano.
Una operación de dominio puede ser naturalmente idempotente: fijar status=closed bajo una transición válida. O puede usar un identificador de negocio único: crear el pago payment_id=P17. Un contador balance += 10 no lo es. Deduplicar mensaje y diseñar efecto idempotente son capas complementarias.
Outbox: cerrar el primer dual write
Un servicio modifica una orden en su base y publica OrderConfirmed. Si confirma la base primero y cae antes de publicar, existe una orden confirmada sin evento. Si publica primero y luego aborta, existe un evento sobre un estado que nunca se confirmó. Dos sistemas distintos no forman una transacción sólo porque el código los llama uno detrás de otro.
El patrón transactional outbox escribe el cambio de dominio y un registro publicable dentro de la misma transacción local. Un relay posterior lee el outbox y publica. Así, todo commit de negocio incluye la intención durable de publicar; un rollback elimina ambos.
El relay puede caer después de publicar y antes de marcar el registro como enviado. Publicará otra vez. Outbox resuelve ausencia de evento, no exactly-once de extremo a extremo. El evento requiere un ID estable y consumidores capaces de reconocer duplicados.
Debezium puede capturar cambios del outbox y convertirlos en eventos. La herramienta reduce polling y acopla la publicación al log de cambios, pero no elimina la necesidad de schemas, routing, retención, control de acceso y deduplicación. El outbox tampoco debe convertirse en un almacén eterno sin política de limpieza verificable.
Inbox: cerrar el segundo dual write
En el consumidor aparece otra ventana: registrar que vio el evento y producir el efecto. El patrón inbox o processed-message table inserta la identidad del mensaje junto con el efecto local en una transacción. Si el ID ya existe, la entrega se reconoce como duplicada y no vuelve a ejecutar.
Vista adaptada. Toca el diagrama para ampliarlo.
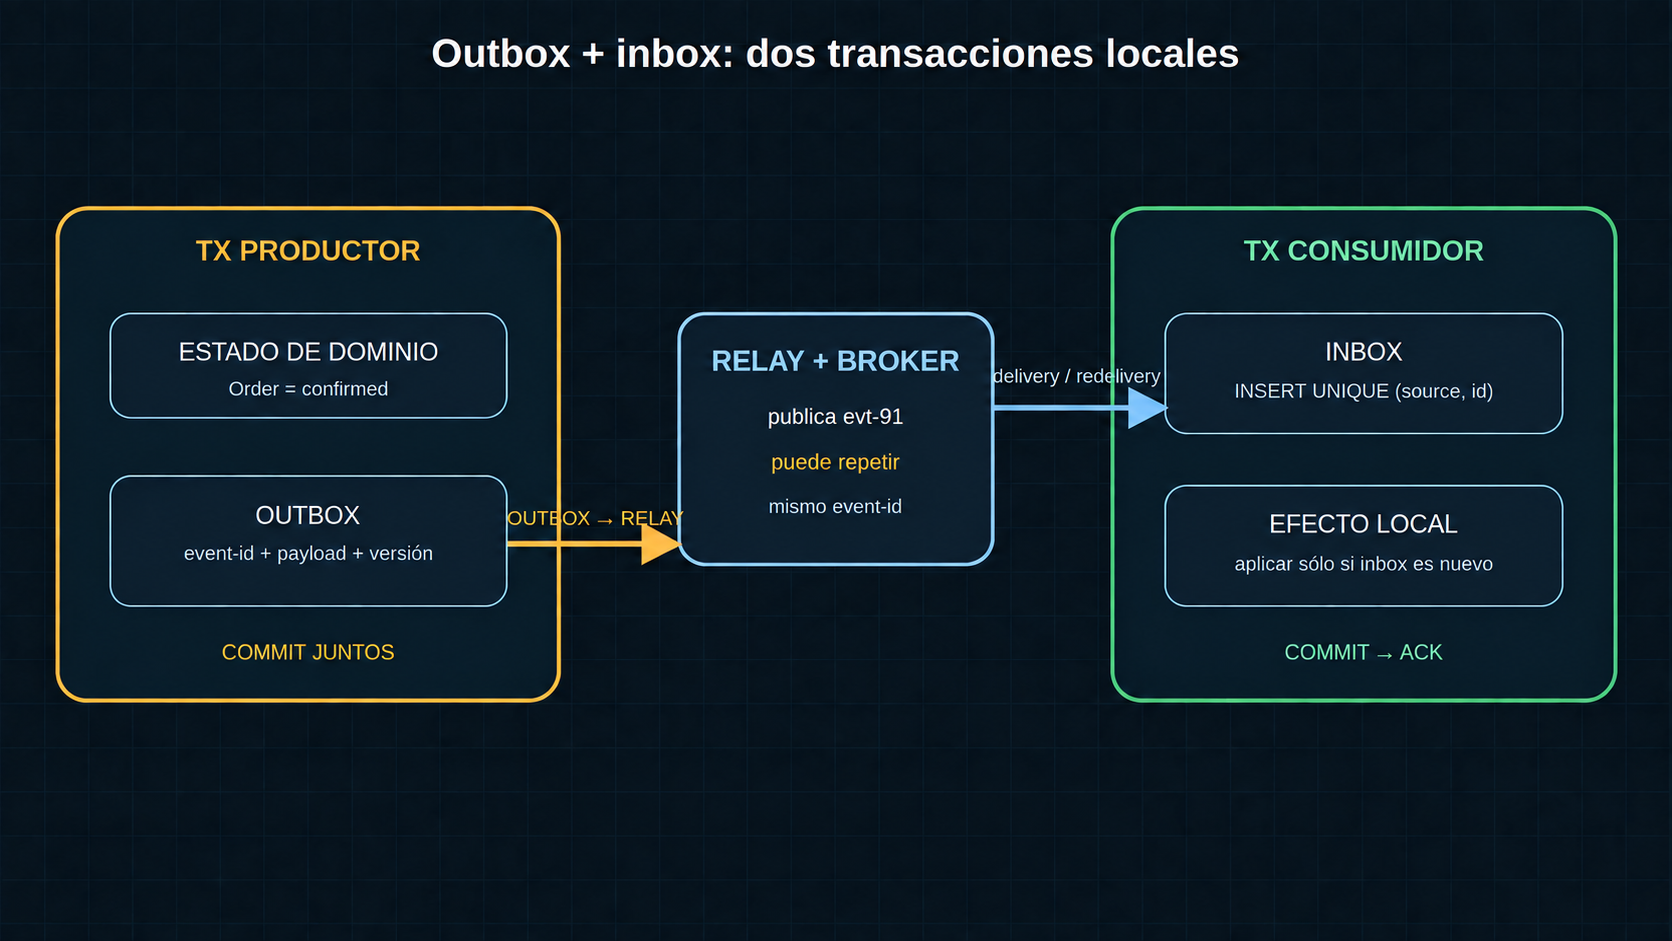
El pipeline completo es:
- transacción del productor:
estado + outbox; - relay: publica, quizá más de una vez;
- broker: conserva y entrega según su contrato;
- transacción del consumidor:
inbox(message-id) + efecto; - consumer ack sólo después del commit.
Hay dos transacciones locales, no una transacción distribuida global. Entre ellas puede haber duplicados y demora. La corrección proviene de identidades estables, constraints, reintentos y reconciliación. Si el efecto del consumidor está en otro servicio, reaparece otra frontera y necesita su propio protocolo.
La clave del inbox debe incluir el scope correcto. CloudEvents define duplicado por source + id, no por id aislado. Si dos fuentes pueden usar 42, una tabla global por ID descartaría un evento legítimo. A la inversa, si un relay cambia el ID en cada intento, impide reconocer redelivery.
Orden, particiones y causalidad
Un timestamp no crea un orden total fiable. Relojes derivan, mensajes viajan por rutas distintas y la ocurrencia puede registrarse después de otro hecho causal. Ordenar por hora puede ser útil para UI, pero no debe decidir transiciones irreversibles sin una regla de versión.
Un log particionado conserva un orden dentro de cada partición conforme a su contrato. Elegir account_id como clave coloca eventos de una cuenta en la misma secuencia, mientras cuentas distintas avanzan en paralelo. Esto permite escala y orden local. No produce un orden global entre todas las cuentas.
La clave debe corresponder al invariante. Si transferencias afectan dos cuentas, particionar sólo por origen no serializa el destino. Puede requerirse un coordinador, locks/versiones o un modelo contable que tolere concurrencia. La partición es una herramienta de routing, no una prueba de consistencia del dominio.
Rebalances, retries y procesamiento paralelo pueden alterar el orden de finalización aunque el broker entregue en orden. Un consumidor debe usar versiones o secuencias: aplicar v8 y luego recibir v7 no debe retroceder estado. «Ignorar si version <= current» funciona sólo si el productor define una secuencia completa para ese agregado y el consumidor conserva atomicidad entre check y update.
Backpressure, capacidad y fairness
Una cola absorbe diferencias temporales, no capacidad infinita. Si la tasa de llegada supera sostenidamente la de servicio, el backlog crece hasta agotar retención, almacenamiento o plazo de negocio. La métrica decisiva no es sólo tamaño: edad del mensaje más antiguo, percentiles de espera, throughput, errores y capacidad disponible describen impacto.
Prefetch y batch aumentan throughput pero amplían trabajo en vuelo. Un worker que reserva demasiados mensajes puede perjudicar fairness y prolongar recuperación. Batches grandes reducen overhead, pero un elemento venenoso no debe obligar a repetir efectos ya confirmados del resto. El contrato debe decidir atomicidad por mensaje o batch y registrar resultados parciales.
El backpressure puede limitar publicación, escalar consumidores, degradar trabajo no crítico o rechazar temprano. «La cola lo aguanta» pospone el fallo y oculta el SLA. Los límites deben conectarse a presupuesto de memoria, retención y tiempo máximo útil.
Reintentos y mensajes venenosos
No todo fallo merece retry. Una desconexión transitoria puede resolverse; un schema incompatible, una firma inválida o una referencia inexistente de forma definitiva no mejora esperando. Clasificar errores evita tormentas.
Los retries necesitan backoff exponencial, jitter, límite y presupuesto por operación. Sin jitter, miles de workers vuelven a golpear a la vez. Sin límite, un mensaje venenoso bloquea particiones, infla métricas y consume capacidad. El número de intentos forma parte del estado observable.
Una dead-letter queue aísla entregas que superan la política. No significa «procesadas» ni «basura». Debe conservar payload conforme a privacidad, razón, contador, timestamps, versión de schema y procedencia suficiente para investigar. Su acceso es sensible: puede contener datos válidos, secretos o mensajes hostiles.
Redrive no es vaciar la cola. Antes hay que clasificar causas, corregir código o datos, verificar compatibilidad, probar deduplicación, autorizar la acción y limitar velocidad. AWS recomienda comenzar con una tasa pequeña para no sobrecargar la fuente. La observabilidad debe separar mensajes recuperados, reincidentes y efectos rechazados.
Seguridad del plano asíncrono
«Viene del broker interno» no es un límite de confianza. Productores comprometidos pueden publicar mensajes válidos en sintaxis pero no autorizados. Consumidores deben verificar esquema, tamaño, tipo, tenant, versión, frescura y autoridad de la fuente para la acción resultante.
Las políticas del broker aplican mínimo privilegio: quién publica en qué destino, quién crea bindings o suscripciones, quién consume, quién hace purge o redrive y quién administra retención. Una cuenta capaz de publicar AdminGranted puede escalar privilegios aunque no acceda a la base directamente.
El payload y los headers son entrada no confiable. Deserialización, compresión, expansión de JSON, schemas recursivos y nombres de routing ofrecen superficie de denegación o inyección. Usa formatos con límites, validación estricta y parsers seguros. No cargues clases arbitrarias desde un campo type.
CloudEvents advierte que atributos de contexto pueden inspeccionarse y registrarse por intermediarios; no deben transportar información sensible. El data puede requerir cifrado y control de acceso. Firmar mensajes puede aportar integridad y procedencia si se gestionan claves, canonización, replay y rotación; no sustituye autorización del efecto.
Los mensajes viejos pueden ser replays legítimos o ataques. Una política necesita event-id, tiempo, versión y ventana, pero no debe rechazar trabajo legítimo sólo por reloj desajustado. Para comandos sensibles, usa nonce o identidad de operación y estado server-side. Para eventos históricos, el replay puede ser una función deliberada y debe ejecutarse en un entorno controlado.
Observabilidad sin confundir correlación con autoridad
Un flujo asíncrono necesita correlacionar publicación, entrega, intento, efecto, ack y redrive. Conserva event_id, correlation_id, causation_id, destino, partición, offset o delivery tag, intento, versión de schema y resultado. No todos deben viajar en el payload; algunos pertenecen al protocolo o a telemetría.
traceparent permite continuar una traza distribuida. W3C exige tratar traceparent y tracestate con límites y sin PII; tracestate puede cruzar fronteras y revelar información. OpenTelemetry define inject/extract sobre carriers, incluidos mensajes. Esa propagación une observaciones, no demuestra que el productor esté autorizado.
Un trace ID no es idempotency key. Puede representar muchos mensajes o cambiar en un retry. Tampoco es un ID de negocio. Usa cada identificador para su contrato y enlázalos en logs estructurados.
Las métricas mínimas incluyen publish latency y failures, confirms pendientes, backlog y edad, deliveries/redeliveries, intentos, processing latency, ack latency, DLQ ingress/egress y lag por partición. Un promedio oculta consumidores atascados; los percentiles y la cardinalidad por destino ayudan, cuidando no convertir IDs de usuario en labels explosivos.
Caso trabajado: confirmar un pedido
La API recibe un comando idempotente ConfirmOrder con operation-id. Autoriza al principal y, en una transacción, cambia Order 77 de pending a confirmed y añade outbox evt-91, tipo OrderConfirmed, aggregate 77, versión 12. Responde cuando el estado y la intención publicable son durables.
El relay lee evt-91, publica y recibe confirm del broker. Cae antes de marcar el outbox; al reiniciar publica otra vez el mismo evento, conservando source + id. Dos copias pueden llegar a la suscripción de inventario.
El consumidor valida schema, tipo, tenant y versión. En su transacción intenta insertar (orders-service, evt-91) y reservar stock. La primera entrega confirma inbox y reserva. La segunda colisiona con la constraint y no reserva otra vez. Ambas pueden terminar en ack, pero sólo una ejecutó el efecto.
La suscripción de email no comparte inbox ni efecto con inventario. Puede enviar un correo una vez o duplicarlo, según el contrato del proveedor. Si no admite idempotency key, el servicio registra un workflow y reconcilia estados desconocidos. Que inventario haya procesado no prueba que email lo haya hecho.
Si llega OrderConfirmed v11 después de v12, inventario no retrocede. La versión del agregado permite detectar stale, pero una brecha v10→v12 puede exigir consultar snapshot o esperar según política. El timestamp se conserva para auditoría, no decide por sí solo.
Si cinco intentos fallan por schema desconocido, el mensaje va a DLQ con causa y metadata. El equipo despliega compatibilidad, prueba el evento en aislamiento, verifica dedupe y redrive a baja velocidad. No edita silenciosamente la historia ni cambia el ID para forzar procesamiento.
Método de revisión
Para cada flujo asíncrono, completa estas preguntas:
- Semántica. ¿Es comando, evento o respuesta? ¿Quién es responsable y quién puede rechazar?
- Identidad. ¿Qué identifica mensaje, evento, ocurrencia, operación y agregado? ¿Cuál sobrevive a retry?
- Topología. ¿Cola competidora, suscripciones, log o combinación? ¿Qué estado conserva cada una?
- Autoridad. ¿Quién publica, consume, redrive y administra? ¿Cómo se valida tenant y acción?
- Confirmación. ¿Qué demuestra publish confirm? ¿Cuándo se hace consumer ack?
- Fallo. ¿Qué ocurre antes y después de cada commit? ¿Qué estados quedan unknown?
- Duplicado. ¿Qué constraint o efecto idempotente impide una segunda consecuencia?
- Orden. ¿Cuál es el scope real: partición, clave, agregado? ¿Cómo se detecta stale o gap?
- Compatibilidad. ¿Cómo evolucionan type y schema? ¿Qué hace un consumidor ante versión desconocida?
- Operación. ¿Qué métricas, DLQ, backoff, límites y procedimiento de redrive existen?
Una respuesta como «el broker garantiza exactly once» no completa ninguna fila hasta declarar configuración, frontera y efecto. Una respuesta como «reintentamos tres veces» tampoco explica clasificación, backoff ni lo que ocurre después.
Transferencia al capítulo 60
La mensajería introduce dependencias de cliente, serializers, schemas, conectores y brokers. La corrección ya no depende sólo del código escrito: una actualización de librería puede cambiar defaults de acknowledgement, compatibilidad o seguridad. El capítulo 60 estudiará dependencias, paquetes, builds y procedencia del software.
La frontera será clara. Este capítulo explica qué garantías requiere el flujo en runtime. El siguiente explicará cómo saber qué componentes entraron al artefacto, de dónde vinieron, cómo se reprodujo el build y qué confianza merece la cadena de suministro.
Síntesis
Comando y evento expresan semánticas distintas; mensaje es el contenedor. Cola, topic, stream y suscripción expresan distribución y estado. Un publisher confirm termina en el broker, no en el consumidor. El consumer ack debe seguir al efecto durable, y una caída entre commit y ack hace normal la redelivery.
At-most-once, at-least-once y exactly-once sólo tienen sentido con una frontera explícita. Kafka puede ofrecer una transacción exactamente-once dentro de su ecosistema sin controlar un efecto externo. Orden por partición no es orden global; timestamps no sustituyen causalidad ni versión.
Outbox conserva estado e intención de publicar en una transacción local. Inbox conserva identidad del evento y efecto local en otra. Entre ambas hay demora y duplicados, no una transacción global. Backoff, DLQ, redrive, schemas, autorización y observabilidad completan el sistema. La robustez no consiste en evitar toda repetición, sino en hacerla visible, acotada y segura.
Fuentes primarias y documentación técnica
- CNCF, CloudEvents Specification 1.0.2 y Primer; repositorio oficial, consultado 2026-10-06.
- OASIS, AMQP Version 1.0, Part 3: Messaging, §§3.3–3.4; OASIS, 2012.
- RabbitMQ, Consumer Acknowledgements and Publisher Confirms y Reliability Guide; documentación, consultada 2026-10-06.
- Apache Kafka 4.1, Design — Message Delivery Semantics; documentación, consultada 2026-10-06.
- Amazon Web Services, SQS Standard Queues, Visibility Timeout y Dead-letter Queues; SQS Developer Guide, consultada 2026-10-06.
- Debezium 3.6, Outbox Event Router; documentación, consultada 2026-10-06.
- W3C, Trace Context §§6–7; Recommendation, consultada 2026-10-06.
- OpenTelemetry, Propagators API; Specification 1.61.0, consultada 2026-10-06.