Un archivo no es «un texto» ni «un objeto» esperando ser abierto. Es una secuencia finita de bytes asociada a metadatos y a un estado observable del sistema de almacenamiento. El programa que lo consume aplica una interpretación: framing, versión, tipos, codificación y reglas semánticas. Cada paso puede rechazar, transformar o conservar información. La seguridad depende de no convertir una señal parcial —nombre, extensión, cabecera MIME, magic number o hash— en una garantía que no contiene.
Este capítulo continúa el límite de representación del 50 y la propagación de fallos del 51. El parsing detallado del 52 aporta estructura y validación; aquí se estudia qué objeto se parsea, cómo se identifica, cuándo dos representaciones son equivalentes y qué fronteras aparecen al escribir. La atomicidad, el fsync y la durabilidad entre procesos quedan reservados para el 54: aquí se llega hasta la decisión de materializar y se deja explícito el contrato que el siguiente capítulo debe cerrar.
La unidad observable: bytes, metadatos y estado
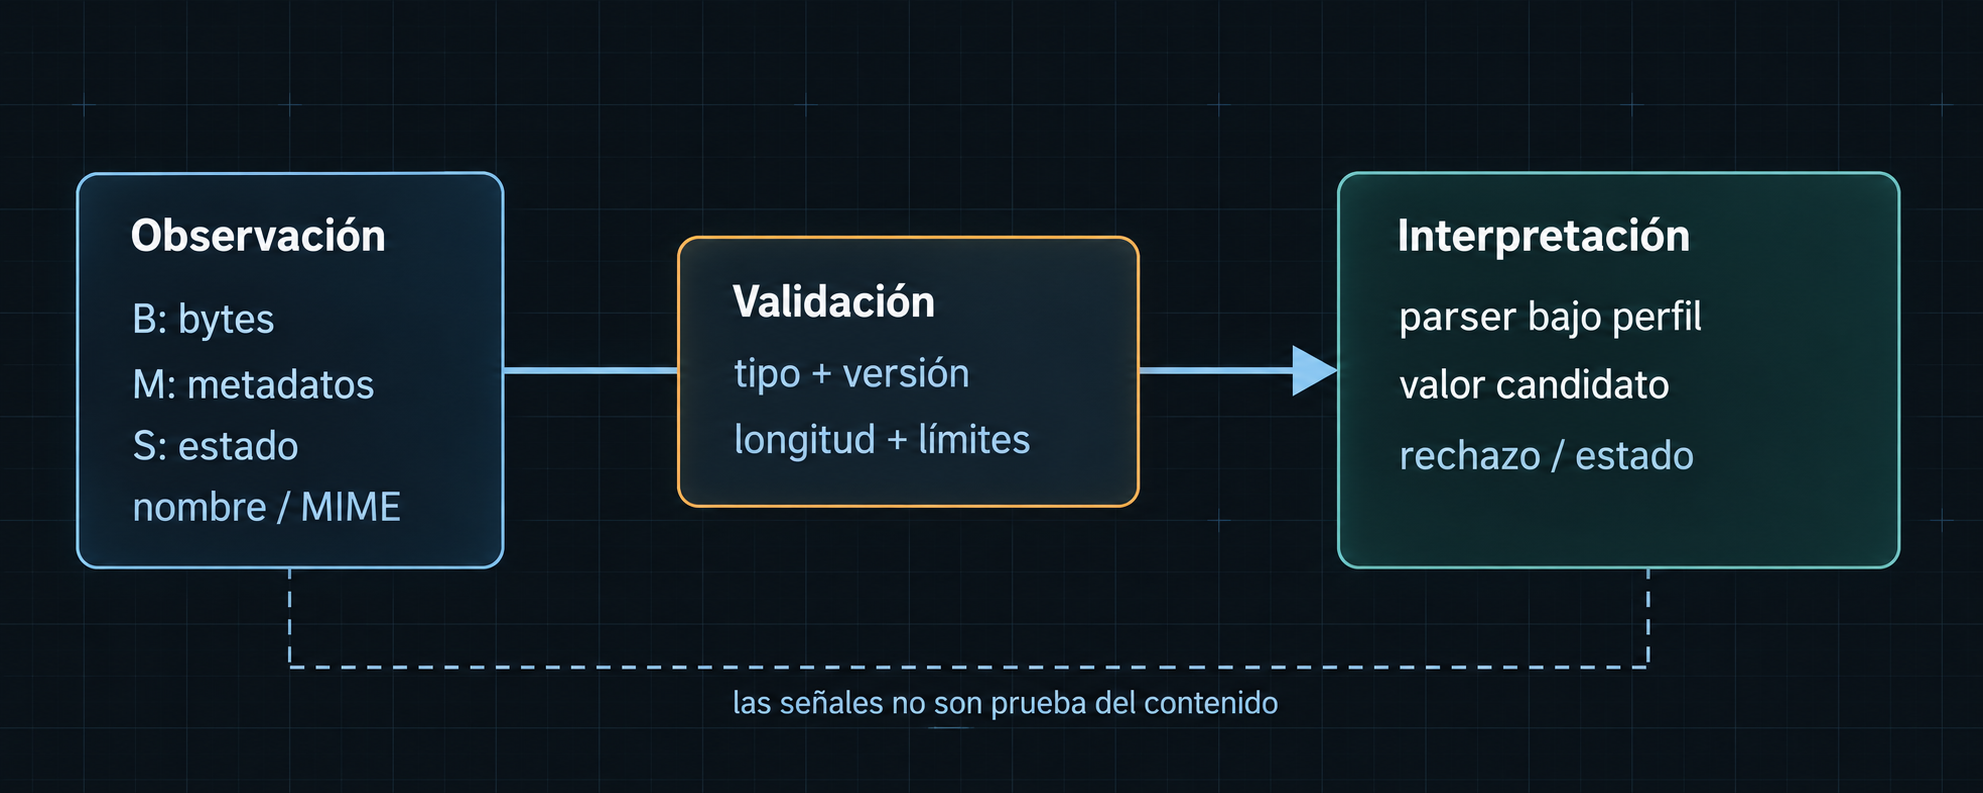
Sea B = b0 … bn-1 una secuencia de bytes, M sus metadatos y S el estado observable de la entrada. M puede incluir tamaño, permisos, propietario, timestamps, tipo de entrada y enlace simbólico; S incluye existencia, visibilidad, concurrencia y si la lectura terminó o fue truncada. El nombre es parte del espacio de nombres, no una prueba del contenido. Un path que resolvió hoy puede resolver a otro objeto mañana; un descriptor abierto mantiene una relación diferente con el objeto que una nueva búsqueda por nombre.
La operación de lectura debe distinguir al menos: bytes completos, bytes truncados, error de transporte o almacenamiento, y resultado desconocido tras una interrupción. Un read que devuelve 0 puede significar fin de archivo según el contrato del sistema, no «contenido vacío» en todos los niveles. El tamaño de metadatos puede ser una pista y puede cambiar entre stat y lectura. Por eso la evidencia mínima conserva bytes observados, operación, instante, identidad del objeto cuando el sistema la expone y límites aplicados; no basta registrar «extensión .png».
Un archivo regular no es la única entrada. Un directorio, FIFO, socket, dispositivo y symlink tienen semánticas distintas. Abrir una ruta como si siempre designara bytes puede bloquear, seguir una referencia o producir efectos laterales. El componente de confianza debe fijar qué tipos admite y fallar cerrado ante los demás. La propiedad «el destino permanece bajo esta raíz» no se hereda de haber validado un string: depende de cómo se resuelvan componentes, enlaces y cambios concurrentes.
Vista adaptada. Toca el diagrama para ampliarlo.
Formato: estructura antes que significado
Un formato es un contrato de representación: framing, campos, orden, longitudes, versión, restricciones y semántica. Un magic number identifica una familia o versión probable; no valida el archivo completo. Un campo length limita una región sólo si se comprueba que cabe en el input, que no desborda al convertirse, que respeta un máximo operativo y que es coherente con los campos vecinos. Una versión desconocida debe producir rechazo o ruta explícita de compatibilidad, no una interpretación «parecida».
Un formato puede ser autocontenido o depender de metadatos externos. En PNG, por ejemplo, una firma inicial orienta la detección pero el decodificador todavía debe validar chunks, tamaños y CRC según su contrato. En un documento firmado, el formato define qué bytes cubre la firma; los metadatos fuera de ese alcance pueden cambiar sin invalidarla. En un contenedor, la entrada puede declarar un tamaño comprimido y otro expandido; ambos requieren límites y el segundo no puede inferirse de la confianza en el primero.
La detección debe separar cuatro preguntas: ¿qué bytes se observan?, ¿qué formato parece compatible?, ¿qué versión se puede interpretar?, ¿qué significado de negocio se autoriza? Una extensión es una sugerencia de interfaz. Content-Type es una etiqueta de representación en un protocolo y puede ser errónea o no ser una aserción criptográfica. La inspección por contenido mejora la hipótesis, pero un detector no sustituye al parser que valida toda la estructura. Tampoco «rechazar tipos desconocidos» impide polyglots: una misma secuencia puede satisfacer más de una gramática parcial.
El caso conductor es una subida de report.dat. El cliente anuncia application/pdf; los primeros bytes coinciden con %PDF, pero el parser descubre una versión no soportada y un stream cuyo tamaño supera el presupuesto. La decisión correcta no es «MIME gana» ni «magic gana»: registrar señales, aplicar el parser y límites, rechazar con razón operable, y no guardar un artefacto bajo un nombre confiable antes de esa decisión. Si se almacena para análisis, debe conservarse como bytes no confiables, con aislamiento y tamaño acotado.
Texto, Unicode y codificaciones
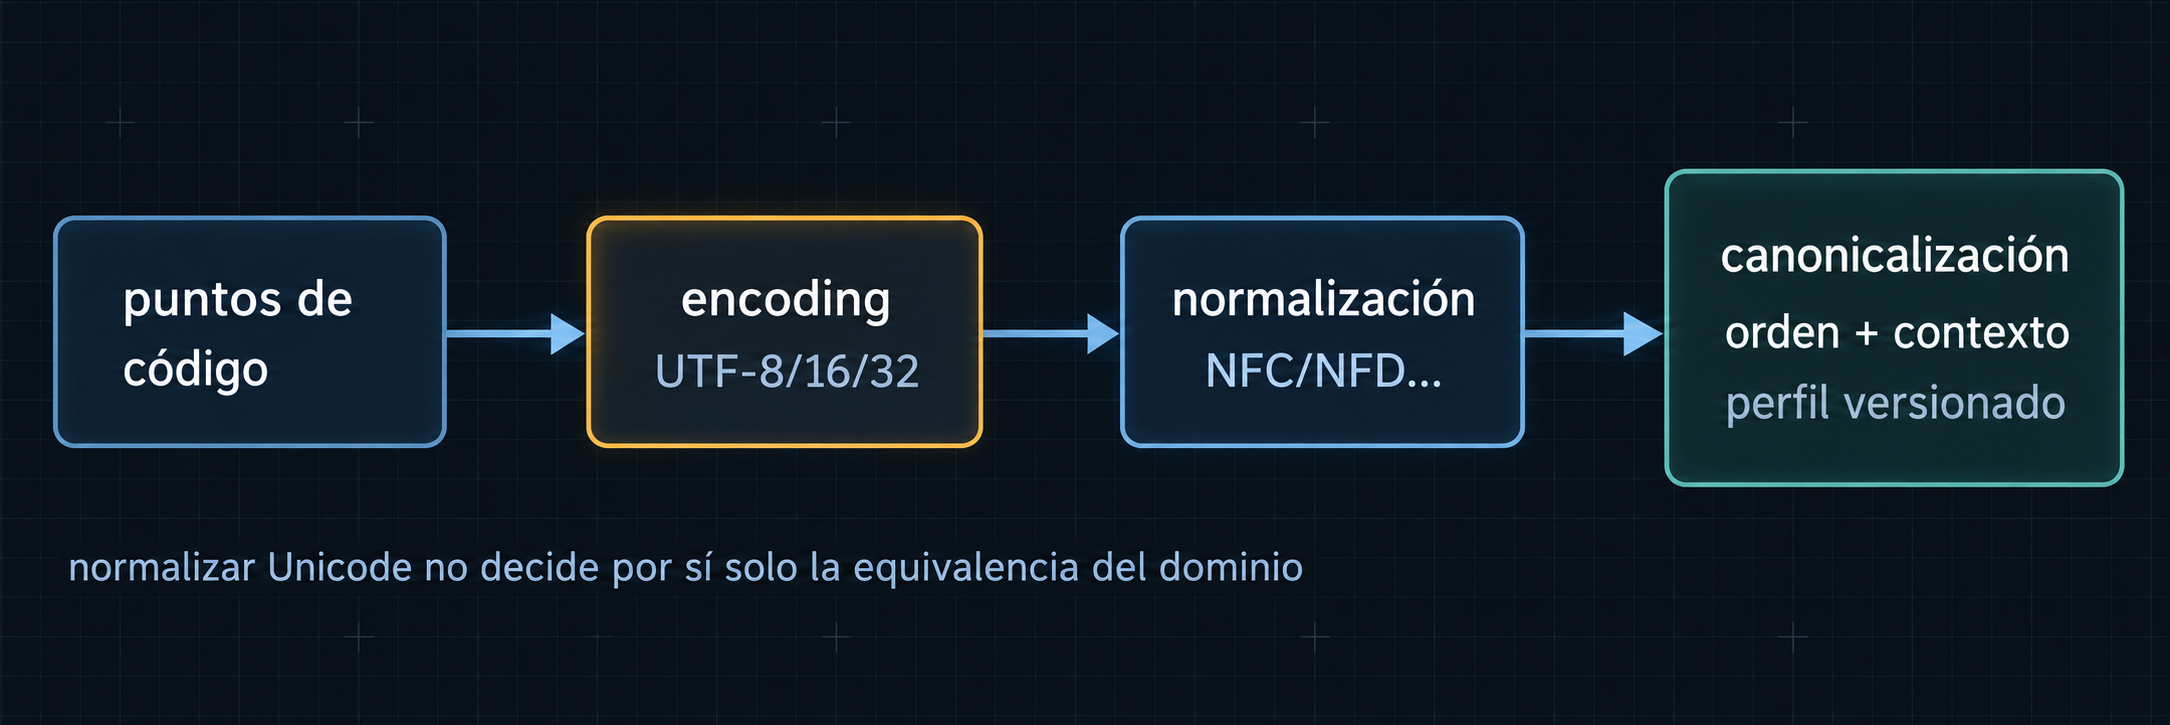
Unicode define un repertorio de caracteres y propiedades, no una única secuencia de bytes. Encoding asigna puntos de código a bytes; UTF-8 es una codificación variable definida por RFC 3629, mientras UTF-16 y UTF-32 tienen otras unidades y reglas. Decodificar no es validar intención: un decodificador puede rechazar secuencias no mínimas, sustituciones o unidades no válidas según su política. La aplicación debe declarar qué hace ante error —rechazo, reemplazo explícito o preservación binaria— porque «limpiar» puede borrar evidencia o colisionar identificadores.
Una cadena puede contener unidades de código, puntos de código y grafemas percibidos por el usuario; no son sinónimos. Longitud en bytes, longitud en puntos y número de grafemas pueden diferir. Cortar por bytes puede producir una secuencia UTF-8 inválida; cortar por puntos puede separar una combinación que el usuario percibe como un carácter. Los límites de almacenamiento y UI deben expresar cuál unidad cuentan y en qué etapa.
La normalización de Unicode transforma secuencias a formas definidas por UAX #15. NFC y NFD tienen objetivos distintos; NFKC y NFKD aplican compatibilidad y pueden perder distinciones relevantes. Normalizar puede hacer equivalentes dos secuencias de puntos de código para una comparación concreta, pero no decide si dos nombres de archivo son el mismo recurso, si dos identificadores son la misma cuenta o si dos firmas deben coincidir. La elección de forma, momento y alcance es un perfil de aplicación.
La canonicalización es más amplia: establece una representación única (o una regla de comparación) para un dominio que puede incluir Unicode, orden de campos, whitespace, rutas, valores por defecto y codificación. La normalización es una transformación Unicode específica; canonicalización puede usarla, pero añade semántica. Canonical JSON (RFC 8785), por ejemplo, fija reglas para serializar ciertos valores JSON; no convierte automáticamente cualquier objeto de negocio, archivo o firma en equivalente. Si una aplicación firma JSON, debe fijar el perfil exacto, prohibir valores fuera de su dominio y comprobar que el verificador usa el mismo perfil.
Vista adaptada. Toca el diagrama para ampliarlo.
Los identificadores exigen una política más estricta que el texto mostrado. Confusables, caracteres invisibles, bidireccionalidad y equivalencias de compatibilidad pueden producir nombres visualmente similares sin ser el mismo punto de código. Unicode Technical Standard #39 aporta mecanismos de detección, pero un identificador de cuenta debe además fijar alfabeto permitido, comparación, unicidad y migración. Mostrar una cadena escapada en logs ayuda a la evidencia; no sustituye la decisión de autorización.
Rutas, nombres y límites de confianza
Una ruta es una instrucción para resolver un nombre en un namespace, no una ubicación neutral. .., separadores alternativos, nombres reservados, bytes NUL, percent-encoding, case folding y normalización del filesystem pueden producir resoluciones distintas. La defensa contra path traversal debe validar el objeto y el destino con APIs de resolución segura, una raíz permitida y políticas de symlink; eliminar simplemente la cadena ../ no modela el namespace.
La comprobación «canonical path empieza por /srv/uploads/» tiene límites: la canonicalización puede seguir enlaces y la ruta puede cambiar después de la comprobación. Hay una condición TOCTOU (time-of-check to time-of-use) si se valida un nombre y luego se abre por nombre en un directorio mutable. Cuando el sistema lo permite, abrir relativo a un descriptor de directorio, restringir enlaces y usar flags de no-follow reduce la ventana; la garantía concreta depende de la API y del sistema operativo. Un inode o file descriptor no equivale a un path estable para todas las operaciones.
Los symlinks son referencias que pueden cruzar fronteras de tenant, montaje o raíz. Un archivo regular que contiene datos aparentemente inocuos puede ser un enlace a credenciales. En extracción o upload, validar cada entrada y la resolución final; no confiar sólo en realpath previo. También hay hard links, bind mounts y sistemas remotos donde la identidad y atomicidad observables cambian. El control debe declarar qué namespace cubre y qué carreras no cubre.
Los nombres no son contenido. La política debe limitar longitud, encoding, caracteres de control, colisiones por case folding y reservados del destino. El nombre visible, el nombre normalizado y el identificador interno pueden ser tres valores distintos. Conservar el nombre original para forensics no obliga a usarlo como path de escritura. Generar un identificador interno opaco y almacenar el nombre como dato separado reduce colisiones, pero no resuelve autorización ni retención.
MIME, contenido y polyglots
MIME es un etiquetado de medios; el detector puede usar cabecera HTTP, extensión, magic y parsing. Ninguna señal aislada prueba la intención del productor ni la seguridad del consumidor. El contrato de un endpoint debe decir cuál señal decide el flujo, qué discrepancias se rechazan y qué se conserva para revisión. Aceptar una imagen y después entregarla como HTML es una confusión de contexto aunque el detector inicial fuese correcto.
Un polyglot es una secuencia válida bajo más de una interpretación parcial. No es necesario afirmar que todo polyglot sea malicioso: el problema es que distintos consumidores pueden tomar decisiones divergentes. Un pipeline seguro fija un parser y perfil por etapa, limita transformaciones automáticas y no permite que una re-serialización borre la procedencia. Si se convierte una imagen, la salida debe recibir un nuevo formato y hash, no heredar sin más la clasificación del input.
Compresión y archives: expansión como efecto
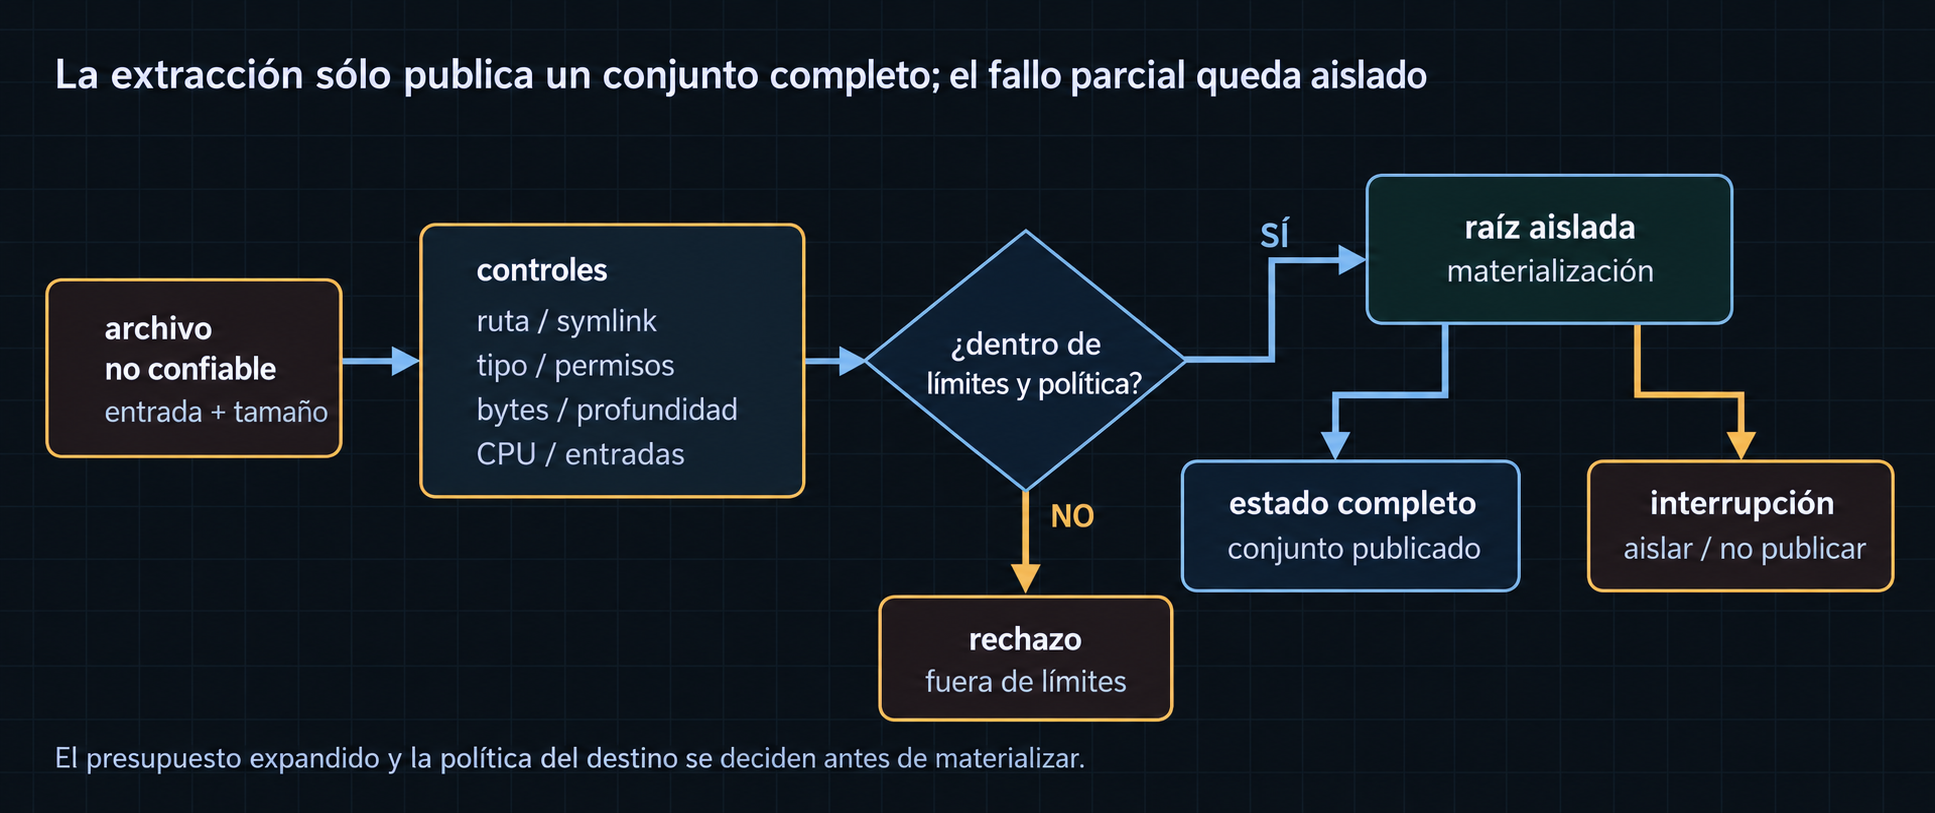
Un archive empaqueta entradas; una entrada puede ser archivo, directorio, enlace o metadato. La compresión reduce bytes almacenados, pero el presupuesto relevante incluye bytes expandidos, número de entradas, profundidad de anidamiento, ratio, tiempo de CPU y espacio temporal. Un Content-Length pequeño no evita una archive bomb. Los límites se acumulan de forma global y por entrada, y deben aplicarse antes de reservar o materializar.
La extracción segura resuelve cada nombre bajo una raíz destinada a ese job, rechaza rutas absolutas y escapes de .., decide qué hacer con symlinks y hard links, limita permisos, y evita que una entrada sobreescriba una ya validada. La comparación de prefijos de strings es insuficiente: /out/a no debe aceptar /out/another por coincidencia textual, y la resolución puede cambiar entre validación y creación. La política más conservadora rechaza enlaces en archives no confiables; si se admiten, el destino debe verificarse en la operación de creación, no después.
La expansión puede producir estados parciales. Si la entrada 37 excede el presupuesto, el extractor no debe presentar 36 archivos como un conjunto completo. Puede usar un directorio temporal aislado y descartar el resultado o marcarlo incompleto; la decisión de hacer visible el conjunto pertenece al contrato de escritura del 54. Los errores deben conservar qué entrada, límite y bytes se observaron sin registrar secretos del contenido.
Vista adaptada. Toca el diagrama para ampliarlo.
Equivalencia, hashes, firmas y forma canónica
Dos secuencias de bytes son idénticas si cada posición coincide. Dos archivos pueden ser semánticamente equivalentes bajo un formato y no byte-equivalentes: whitespace, orden permitido de miembros o metadatos pueden variar. Un hash criptográfico compromete una secuencia de bytes bajo supuestos del algoritmo; no prueba que el parser la interprete como el mismo documento ni que sea auténtica. La colisión práctica, la longitud del digest, el algoritmo y la procedencia forman parte de la afirmación.
Una firma digital liga una clave a bytes o a una digest, según el protocolo; no firma automáticamente nombres, permisos, contexto, ruta ni comportamiento del consumidor. Verificar una firma demuestra una relación criptográfica con la clave y los bytes cubiertos bajo la política de validación; no demuestra que la clave esté autorizada para ese tenant ni que el formato sea seguro de procesar. La cadena de confianza, algoritmo permitido, contexto y anti-replay deben estar fuera del parser pero dentro del contrato.
La canonical form es útil cuando el dominio define equivalencia: serializar campos en orden determinista, normalizar texto según perfil, fijar números y omitir o incluir metadatos explícitamente. Debe ser idempotente (C(C(x)) = C(x)) dentro del dominio y no colapsar valores distintos por accidente. Los valores fuera de dominio se rechazan, no se canonicalizan con heurísticas. Si el formato cambia de versión, la forma canónica y los bytes firmados pueden cambiar; versionar el perfil es obligatorio.
En el caso del informe, un productor firma un JSON antes de enviarlo. Un verificador que ordena claves pero no fija números, Unicode o escapes puede aceptar una representación diferente de la intención del productor. RFC 8785 ayuda sólo si ambos lados cumplen su perfil; no cubre autorizaciones del documento ni el archivo adjunto. La evidencia debe registrar digest, algoritmo, perfil, versión, clave identificada, bytes cubiertos y resultado de validación. Un log que dice signature=true sin esos campos no permite reconstruir la decisión.
Escritura, estado y frontera con el capítulo 54
Escribir un archivo implica decisiones diferentes: dónde crear, con qué permisos, qué nombre interno, qué bytes exactos, qué metadatos conservar y cuándo anunciarlo. «La llamada devolvió éxito» no prueba que otro proceso vea bytes completos ni que sobrevivan a una pérdida de energía. Esas garantías dependen del filesystem, flags, flush y protocolo, y se tratarán en el 54.
Hasta esa frontera, este capítulo exige que el escritor reciba una representación validada, un presupuesto, un destino autorizado y un identificador de versión. Debe distinguir un artefacto temporal, un artefacto preparado y uno visible al consumidor. Si la validación cambia los bytes —por ejemplo, al re-serializar— debe producir nuevo hash y procedencia. No debe afirmar que una firma del input cubre la salida transformada.
El contrato de 54 tendrá que resolver atomicidad, durabilidad, recuperación y concurrencia; aquí sólo se evita que un estado no validado cruce la frontera. Una operación puede ser atómica para un nombre y aun no ser durable. Un rename puede hacer visible un archivo completo en ciertos sistemas y no constituir garantía de persistencia energética. Estas diferencias son deliberadas, no detalles de vocabulario.
Método de diagnóstico y transferencia
Para revisar un pipeline de archivos, congelar primero bytes y metadatos observados. Después enumerar formato, versión, límites y parser; separar señales de clasificación de validaciones. Para texto, registrar unidad de longitud, encoding, política de error y forma de normalización. Para paths, identificar actor, raíz, namespace, symlinks, carrera y operación efectiva. Para archives, calcular presupuestos comprimido y expandido, profundidad y número de entradas. Para hashes y firmas, fijar bytes cubiertos, perfil, algoritmo, clave y contexto.
Aplicar controles positivo y negativo: un archivo válido pasa; una longitud máxima, versión desconocida, ruta fuera de raíz, enlace prohibido, secuencia UTF-8 inválida, archive expandida por encima del presupuesto y firma sobre bytes alterados deben producir resultados explícitos. Un rechazo no demuestra que todo consumidor esté aislado; demuestra sólo la frontera probada. Una ausencia de error no demuestra equivalencia semántica.
Transfiere el modelo a una exportación de logs. El nombre 2026-10-05.log, text/plain y UTF-8 son señales distintas. Si se normaliza el texto antes de firmarlo, la firma cubre la salida normalizada y no el original. Si el export contiene rutas provenientes de un tenant, no se deben reutilizar como destinos. Si se comprime, el límite se aplica a la expansión. Si un timeout ocurre tras anunciar disponibilidad, el estado es desconocido hasta observar el objeto por el contrato del 54.
Síntesis
El modelo profesional conserva cinco separaciones. Bytes no son significado; metadatos no son contenido. Encoding no es normalización; normalización no es canonicalización de dominio. MIME y magic son señales; un parser con versión y límites valida una representación concreta. Una ruta no es un path seguro sólo porque su string parezca inocente; los symlinks y las carreras viven en el namespace real. Un hash o firma cubre bytes y contexto explícitos, no toda la semántica ni autorización.
El capítulo 54 continuará con creación, atomicidad y durabilidad. La pregunta que llega allí ya debe estar bien formada: qué bytes se materializan, bajo qué formato y perfil, para qué principal y destino, con qué límites, qué identidad tiene el artefacto y qué estado se puede observar después. Sin esa especificación, una escritura aparentemente correcta sólo conserva una ambigüedad.
Procedencia, perfiles y estados de lectura
La procedencia no es un campo ornamental. Un pipeline que recibe bytes por HTTP, los descifra, descomprime y re-serializa debe poder explicar qué operación produjo cada artefacto. Conviene asignar un identificador a cada etapa y conservar relaciones input_hash → output_hash, algoritmo, versión de biblioteca, perfil de formato y límites aplicados. Esto no convierte el resultado en confiable por defecto: permite adjudicar qué fue observado, qué se transformó y qué clave o principal autorizó la operación.
El estado de un archivo también tiene dimensión temporal. Un descriptor puede seguir leyendo el objeto previo aunque el nombre se haya reemplazado; una caché puede servir bytes antiguos después de que el recurso cambie; un watcher puede recibir eventos agrupados o perdidos. La consistencia entre bytes, tamaño y metadatos debe definirse para cada operación. Si el análisis requiere una instantánea, el sistema debe proporcionar ese contrato o marcar que la evidencia proviene de lecturas separadas.
El lector no debe mezclar EOF, error y ausencia. Un archivo vacío tiene una secuencia de longitud cero; una lectura abortada antes de obtener bytes no es el mismo valor. Un archivo inexistente y uno inaccesible pueden exponerse como el mismo error externo por minimización de información, pero la capa interna debe conservar causa suficiente para no convertir una denegación en «no existe». Los mensajes a usuarios pueden ser generales mientras la evidencia operacional sea estructurada y no filtre contenido sensible.
Un formato versionado necesita una política de compatibilidad, no sólo un entero version. Hay que decir si el lector acepta versiones menores, si campos desconocidos se ignoran o rechazan, si valores por defecto son semánticamente seguros y si una escritura conserva o actualiza la versión. Ignorar un campo que cambia autorización no es forward compatibility; es pérdida de control. Aceptar una versión antigua puede requerir migración explícita y nuevo hash, porque la serialización resultante ya no es el mismo artefacto.
Los formatos de texto presentan otra tensión: preservar bytes originales ayuda a forensics y firmas; re-serializar facilita interoperabilidad y canonicalización. No deben realizarse ambas cosas bajo un único nombre o digest. Un diseño puede guardar raw_input inmutable y normalized_projection derivada, con políticas de retención y acceso diferentes. La proyección no debe sobrescribir la evidencia original ni heredarse como si fuese byte-equivalente.
Validar el tamaño del archivo antes de leerlo no basta si un campo interno induce asignaciones repetidas. El presupuesto debe viajar por la pila: bytes totales, profundidad de estructuras, número de nodos, tamaño de strings, expansiones y tiempo de CPU. Una forma aparentemente compacta puede ser costosa de decodificar. El límite de entrada y el límite de trabajo son invariantes distintos y requieren observación distinta.
La cancelación de una lectura o extracción también crea estado. Un buffer temporal puede contener bytes parciales; una tabla de índices puede referirse a entradas que no llegaron; un índice persistido puede anunciar un objeto que la validación no terminó. El consumidor debe recibir una marca de completitud o un handle que sólo se vuelve visible cuando el contrato lo permite. La limpieza de temporales y recuperación tras interrupción son parte de la transición de escritura del 54, pero el productor ya debe distinguir prepared, complete, rejected y unknown.
Considera un servicio que exporta datos de un tenant a exports/<tenant>/<fecha>.zip. El tenant del path no debe otorgar autorización: debe provenir del principal y del contexto validado. La fecha se trata como dato con formato y zona horaria definida, no como componente libre del path. El nombre interno se genera después de validar que el destino pertenece a la raíz autorizada. Al extraer una solicitud de soporte, el archivo se coloca en una raíz temporal que no comparte permisos con el directorio de publicación.
Si el archivo contiene enlaces, la política debe indicar si se rechazan, se materializa el contenido apuntado dentro de raíz o se conserva el enlace como dato inerte. Cada alternativa tiene implicaciones distintas; seguirlo sin límite puede filtrar secretos y conservarlo sin tratamiento puede inducir a un consumidor posterior a seguirlo. Un symlink cuyo texto no contiene .. todavía puede escapar de la raíz mediante un destino absoluto o un enlace intermedio. La defensa se expresa sobre resolución efectiva y operación de creación, no sobre una búsqueda de substrings.
Fuentes primarias
- Unicode Consortium, The Unicode Standard, versión 18.0.0 (2026), capítulos 2–3; Unicode Core Specification.
- Unicode Standard Annex #15, Unicode Normalization Forms, rev. 58 (2026-08-12), §1–3; UAX #15 rev.58.
- Unicode Standard Annex #39, Unicode Security Mechanisms, §4; UAX #39.
- RFC 3629, UTF-8, a transformation format of ISO 10646, §§3–4; RFC Editor.
- RFC 8785, JSON Canonicalization Scheme (JCS), §§3–4; RFC Editor.
- RFC 9110, HTTP Semantics, §§8.3, 8.5 y 12.5.1; RFC Editor.
- POSIX.1-2024,
openat(),O_NOFOLLOW, path resolution y symbolic links; The Open Group Base Specifications. - IETF RFC 8089, The file URI Scheme, §§2–4; RFC Editor.
- PKWARE, APPNOTE.TXT 6.3.10, ZIP fields and structure; PKWARE APPNOTE.